
逐步回归
这个方法是做什么的
让程序按显著性自动决定哪些自变量该进模型:每一步把当前最显著的候选变量放进来(p 小于“进入”阈值),再回头把已经不再显著的变量踢出去(p 大于“删除”阈值),反复增删直到没有变量可进也没有变量可出。可选方法有逐步(双向)、向前、向后,以及“进入”——最后这种其实不筛选,把全部候选一次放进模型。默认阈值是进入 0.05、删除 0.10,都可以改。
最终输出的是一个普通的多元线性回归:系数 B、标准误、95% 置信区间、标准化系数 Beta、t、p,加上 VIF 与容忍度;方差分析表、R² 与调整 R²、RMSE、AIC/BIC、Durbin-Watson。此外还有两张别处没有的表:一张按步列出筛选路径上每个模型的变量集合与 R²、调整 R²、AIC、BIC,另一张记录每一步的系数与显著性明细。第一张卡在残差正态、同方差、独立性之外,专门单列一行“逐步筛选的固有风险(选择性推断)”,判定写的是“须声明”——这是整份报告里最该先读的一行。
需要准备什么数据
- 放入 [定量] 变量Y:1 个,定量变量(数值)
- 放入 [定量] 自变量X:至少 1 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 候选变量不多,只想快速看看哪些变量在多元模型里还站得住,作为探索性分析的第一步
- 需要一份带完整筛选路径明细的输出:每一步进了什么、系数如何变化、AIC/BIC 怎么走
- 学科惯例或复现他人分析要求报告“逐步回归”,且你愿意在文中声明它的局限
- 想拿数据挑出来的变量集合与理论驱动的固定模型做个对照
因变量与全部候选自变量必须是定量列,本模块不做哑变量编码,拖入定类列会被整列判为缺失;含缺失或非数值的记录整行剔除;候选自变量不得为常数列。有效样本量必须大于候选自变量个数加一——注意分母是候选变量个数而不是最终纳入的个数,因为筛选这一步本身也在消耗自由度。第一张卡给出实测的 N/k 与“候选VIF”,后者是全部候选变量同时入模时算的,反映筛选之前的共线状况。
什么时候不要用它
- 你打算把最终模型的 p 值当作证据写进论文:改用理论驱动的固定模型「线性回归 (最小二乘法)」,或者按理论把变量分块、看每一块增量解释力的「分层回归」——那两种的 p 值没有经过筛选,含义是干净的。
- 候选变量之间共线严重:共线下逐步筛选的取舍会随样本抖动,先用「VIF共线性诊断」查清是哪几个变量凑成的;想保留全部变量并把系数稳住用「岭回归(Ridge)」,想让程序做选择又要样本外评估与入选稳定性用「Lasso回归」,同源指标希望成组去留用「ElasticNet回归」。
- 目的是预测:本模块的 R²、RMSE、AIC/BIC 全部是训练集回代值,报告里没有任何交叉验证。要样本外评估用「Lasso回归」或「ElasticNet回归」;只求预测精度可以用「随机森林回归」或「XGBoost回归」。
- 只想知道每个候选变量单独与因变量的关联有多强:用「特征筛选」,它做的是逐个变量与目标的单变量筛选,不涉及变量之间的取舍。
- 自变量里有定类列,或因变量不是数值型:定类自变量先用“数据编码”转成数值,或改用会自动做哑变量编码的「线性回归 (最小二乘法)」;因变量是 是 / 否 用「逻辑回归」,是等级用「有序逻辑回归」,是计数用「计数数据回归」。
容易误读的地方
- 按 p 值反复增删变量之后,最终模型的 p 值、置信区间、R² 全都不再是它们名义上的东西。 机制很直接:变量是按“哪个最显著就先进”挑出来的,能留到最后的必然是在这批样本上恰好显著的那些;然后又用同一批数据去检验这些系数,等于让已经赢过一轮的选手再比一次。三件事同时失真——p 系统性偏小、95% 置信区间的真实覆盖率低于 95%、R² 与调整 R² 被高估。第四张卡的半偏 sr² 与偏 η² 建立在同一套 t 值上,同样偏高;那里的 Holm 校正只处理“同时检验多个系数”这一层多重性,表注写明了它修不了筛选造成的偏倚。所以这张表给的不是“客观筛出来的模型”,而是“在这批样本上碰巧最好看的模型”。要得到可信的显著性,只能在独立样本上重做检验,或者一开始就用理论固定模型。
- 换一批样本常常选出不同的变量集合,所以“没被选进去”不等于“无关”。 两个高度相关的候选变量之间,谁先进入往往由很小的随机差异决定;先进去的那个占住了共享的解释力,另一个就上不了台面而被挡在门外,报告于是呈现出“A 显著、B 不显著”的假象。第一张卡的候选 VIF 越高,这种抖动越厉害。产品里唯一能量化“这个变量到底稳不稳”的是「Lasso回归」第四张卡的自助入选频率。
- 进入 0.05 / 删除 0.10 只是可改的默认值,不是标准。 阈值一动,最终模型就换一套变量,而报告不会告诉你哪一套更对。想看筛选到底删掉了什么,可以先用“进入”方法跑一次全变量模型作参照。更要紧的是:如果你反复调阈值或换方法,直到得到一个满意的变量组合,那是在筛选之上又叠了一层筛选,上面说的失真只会更严重——而且这一层报告完全记录不到,第四张卡的筛选过程明细只记录你最后跑的那一次。
- 筛选路径上那张 AIC/BIC 对比表是用来核查路径的,不是模型选择的独立证据。 它的用途是看某一步引入的变量有没有用(AIC 反而上升就说明这步没带来收益),但表里每一行都是被同一套筛选逻辑挑出来的模型,数值同样受选择效应影响。AIC 与 BIC 也只在同一批样本、同一因变量的模型之间可比。另外 R² 随变量增多单调不减,判断某一步值不值得应看调整 R² 与 AIC/BIC。
- 残差诊断和整体 F 检验都验证不了“变量选对了”。 Shapiro-Wilk、Breusch-Pagan、Durbin-Watson 与第三张卡的残差分箱表都是在最终模型的残差上做的,它们全部满足也只说明“给定这套变量时 OLS 的标准误算得对”,与变量该不该是这套无关。整体 F 的原假设只是“除截距外全部系数同时为 0”,拒绝它只表示至少有一个变量有用,而且这个 F 本身也是在被挑过的模型上算的。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:最终模型主结果表
- 输出结果三:模型拟合与残差诊断可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
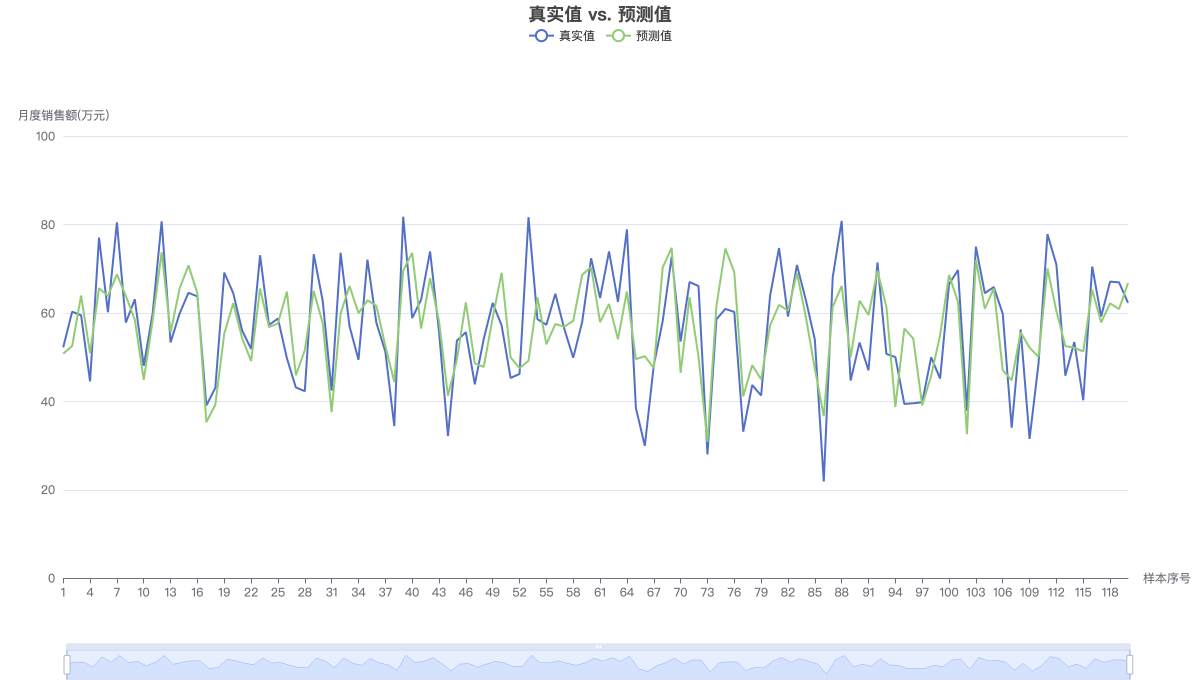
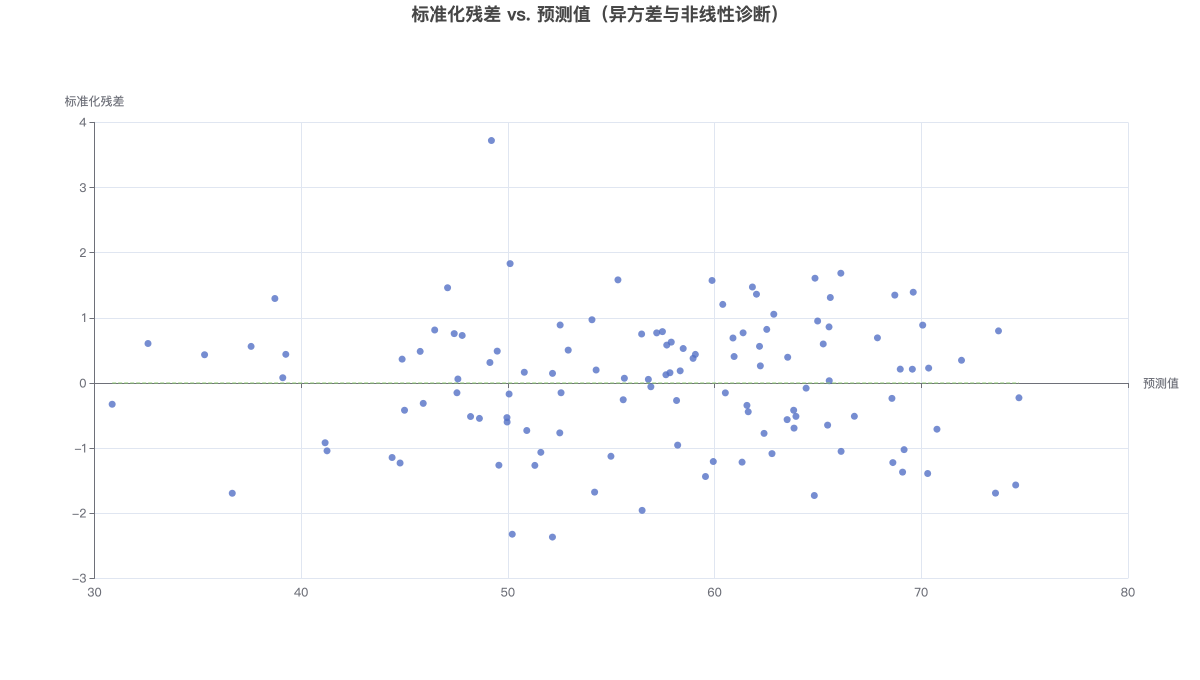
卡③ 用两张图检查模型:拟合图看整体贴合程度,残差图看是否违背同方差与线性假定。