
单样本T检验
这个方法是做什么的
拿一个数值变量的样本均值,和一个你自己指定的检验值比,问总体均值是不是等于它。检验值不是从数据里算出来的,它来自数据之外——国标限值、临床参考阈值、历史基准。所以这个方法回答的是“这批东西合不合某条既定的线”,而不是“A 和 B 有没有差别”。拖拽区一次只接 1 个变量;检验值在控件里填,它有预填默认值,务必改成你自己的基准。
除了“等不等”,它还回答“差多少”:均值差(原始单位)及其 95% 置信区间、Cohen's d 与小样本校正的 Hedges' g,后两者的置信区间由非中心 t 分布反演非中心参数得到,并按 Cohen (1988) 给出微弱 / 小 / 中等 / 大的量级判读。第一张卡给样本量、缺失清单与正态性证据(Shapiro-Wilk、Lilliefors 校正的 K-S、偏度与峰度);第三张卡把直方图与理论正态曲线叠在一起;最后一张卡给结论摘要与一段可直接誊入论文的规范表述。
需要准备什么数据
- 放入正态分布的 [定量] 变量:1 个,定量变量(数值)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 一批产品的实测指标是否达到国标或合同约定的限值
- 一批患者的化验值是否偏离临床参考阈值
- 一批仪器的读数是否存在零偏(检验值取 0)
- 一份量表的平均得分是否达到常模给出的分界值
前提有三条。观测互相独立——由抽样设计保证,数据里查不出来;变量为连续定量且不能是常数列——标准差为 0 时 t 统计量无定义;总体近似正态。最后一条要结合样本量看:n≥30 时样本均值的抽样分布已接近正态,t 检验对轻度偏斜相当稳健;真正要紧的是 n 只有十几例又明显偏态的情形。另外,“数据要求”里那个最少 3 行是技术下限(少于 3 例连样本标准差都算不出来),不是统计上够用的样本量;缺失率上限放到了 50%,所以报告里的有效 N 完全可能只有原始行数的一半,跑完先看第一张卡的缺失率那一行。
什么时候不要用它
- 要比的是两批不同对象:用「独立样本T检验」。单样本检验里没有“另一组”,检验值是个不带抽样误差的常数。
- 两列是同一批对象的两次测量:用「配对样本T检验」。你也可以自己相减成一列差值、把检验值填 0 再跑本模块——数学上完全等价——但那样会丢掉两次测量各自的描述统计、差值的正态性检验,以及“变量1 减 变量2”这个方向的交代。
- 数据明显偏态或含极端值,且样本量不大:用「单样本Wilcoxon符号秩检验」。它比较的是分布位置而不是均值,一个极端值只占一个名次。
- 你比的其实是一个比例(合格率是否等于 95%):用「二项式检验」。t 检验的对象是均值;把 0/1 变量的均值当成率来做,小样本时置信区间会算错,甚至给出超出 0~1 的端点。
- 想看一个分类变量的分布是否符合某组理论比例:用「卡方拟合优度检验」。
- 还在设计阶段,想知道多大样本才检得出某个差距:用「单样本t检验功效」。事后拿一个不显著的结果去反推功效(observed power)是循环论证——它只是 p 值的另一种写法,得不出任何新信息。
容易误读的地方
- 检验值必须来自数据之外;用样本自己算出来的数当检验值,p 值就没有意义了。 “检验值”是一个要你手填的控件,不会从数据里推断。把这批数据的均值填进去,检验的就成了“样本均值等不等于它自己”,t 会被人为压向 0,几乎必然不显著;反过来,先看了数据、再挑一个明显偏离的数填进去,p 又会被人为做小。这两种做法都不是“保守一点”或“更严格一点”,而是让 α 不再等于名义上的 0.05。合法的检验值只有一种:在你看这批数据之前就已经确定、且与本次抽样无关的量。
- 正态性检验不显著不是“数据服从正态”,也不该当成能不能用 t 检验的开关。 第一张卡的 Shapiro-Wilk 与 K-S 只能拒绝正态,不能证明正态:n 小时它几乎必然不显著(于是放行了本该谨慎的情形),n 很大时一点轻微偏斜就显著(于是把本来完全稳健的情形赶去用效能更低的方法)——两头都错。而且 t 检验要求的从来不是原始数据完美正态,是样本均值的抽样分布近似正态。真正该看的是样本量和偏离的程度:同一张卡上的偏度与峰度不随样本量变化,比那两个 p 值有用得多;再配上第三张卡直方图与正态曲线的贴合程度,判断会踏实很多。
- t 值是“差了几个标准误”,不是“差了多少”。 t = 均值差 ÷ 标准误,而标准误 = SD/√N。所以 t 变大有两条路:差距真的变大,或者只是样本量变大。样本量翻四倍,同样大的均值差算出的 t 大致翻一倍,p 会更小,可这批数据离检验值仍旧只差那么多。要判断“超没超标”,看的是均值差及其 95% 置信区间落在哪一段——那是带原始单位的量;要判断这个差距相对于个体差异算不算大,看 Cohen's d 及其区间。p 值本身两个问题都不回答。
- 不显著同样不等于“总体均值就等于检验值”。 看均值差的置信区间:若它是 [-0.9, +1.4],这批数据同时容得下“几乎没偏”和“偏了 1.4 个单位”,这离“等于检验值”很远,只说明现有证据不足以分辨。要论证“符合标准”这类等价性结论,必须先讲清多大的偏离算可以接受,再用等效性检验去证——拿一个不显著的 p 反推“达标”,是把“没找到证据”当成了“证据表明没有”。
- 一次只收 1 个变量,多重比较和单双侧的账都得你自己记。 第四张卡说得很直白:单样本 t 检验只涉及一次比较,模块内不做任何校正。但“8 个指标各跟标准值比一遍,挑出显著的两个写进结论”是 8 次检验,即使全都没有差异,至少出现一次假阳性的概率也已接近 34%;要么在汇总层面自己做 Holm 或 Bonferroni 校正,要么事先说明哪个是主指标、其余为探索性。单双侧同理:表注写明报告给的是双侧 p,而“是否超上限”这类问题逻辑上常是单侧的——如果你确实要用单侧,方向必须在看数据之前定好,看了数据再改方向、或不加检查地把双侧 p 除以 2,等于把 α 悄悄放大了一倍。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:单样本t检验主结果表
- 输出结果三:分布可视化(直方图与正态曲线)
- 输出结果四:效应量与置信区间
- 输出结果五:结论与学术表述
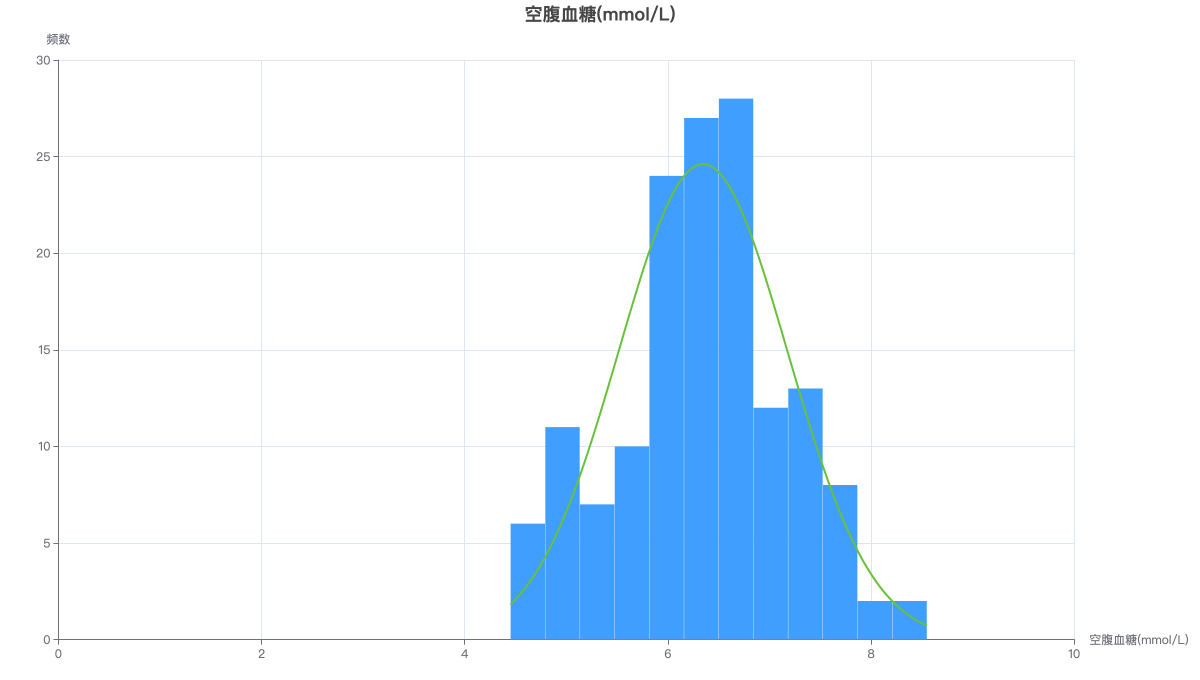
蓝色条形为实际频数分布,绿色曲线为按样本均值与标准差绘制的理论正态密度曲线(已按 N×组距 缩放到频数尺度)。可切换为「表格」查看频数分布表。