
基尼系数与洛伦兹曲线
这个方法是做什么的
衡量一笔非负数量(收入、财富、消费、产值)在个体之间分得均不均匀。把个体按取值升序排列,画出“累计人口比例—累计财富比例”的洛伦兹曲线,它与 45° 均等线所夹面积占三角形面积的比例就是基尼系数:0 是绝对平均,1 是绝对不平均。0.4 通常被当作收入分配差距的国际警戒线。
基尼系数是个点估计,本模块不止给这一个数:1000 次自助重抽样的 95% 置信区间(固定随机种子、端点截断到 [0,1])与自助标准误、小样本偏差修正后的 G×n/(n−1);指定分组变量时还给各组的组内基尼与财富占比,以及组间基尼差值的自助法检验(带 Benjamini-Hochberg 校正)。第四张卡把基尼与另外七个不平等指标(泰尔 T、平均对数离差、Atkinson、变异系数、Hoover、帕尔马比、20:20 比)并排列出,另给五等分份额,并把泰尔指数按分组严格分解为组内与组间两部分。这份报告特有的着眼点是:基尼是唯一被拿去对照警戒线的那个数,但它只是八个指标之一,而且是对分布中部最敏感的那一个。
需要准备什么数据
- 放入[定量]收入/财富变量:不限
- 放入[可选]分组变量(可选):不限
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[可选]分组变量」的类别数需在 2~50 之间。
- 「放入[可选]分组变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 收入、财富、资源分配的不平等程度,需要一个可跨研究比较的无量纲指标
- 城乡、地区、行业之间比不平等,并且要知道差距是不是统计显著
- 想把总不平等拆成“组内差距”与“组间差距”两部分
- 需要一条能直接放进论文的洛伦兹曲线
前提是分析变量定量且非负——出现负值(亏损、负资产)时洛伦兹曲线会跌破横轴、基尼可以超出 [0,1],本模块会直接拒绝;总量必须为正。它按个体级微观数据计算,分组比较时每组至少 2 个观测。基尼是排序统计量,小样本下系统性低估真实不平等,样本量太小时自助区间也不稳。
什么时候不要用它
- 分析变量含负值:基尼的定义域不允许,会被入口拦下。若你要的其实只是离散程度而非分配格局,用「描述性统计」里的标准差与变异系数。
- 手上是各收入段的人数与总额这类分组汇总数据:把组均值当个体值会抹掉组内差距、系统性低估不平等。先用「频数分析」核对分段结构并还原到个体级,再回本模块。
- 要回答“不平等是由哪些因素造成的”:基尼只描述分布、不做归因。把收入对各因素做「线性回归 (最小二乘法)」;想知道某因素在低收入段与高收入段上的作用是否不同,用「分位数回归」。
- 要比的是两组的平均水平而不是分配形状:用「独立样本T检验」;分布偏态严重时用「独立样本 Mann-Whitney U 检验」。
- 需要一个严格可加分解、并且要作为主指标单独成篇的熵类指标:用「泰尔指数(Theil)」——注意它要求取值严格为正,含 0 会被拒绝,而基尼允许 0。
容易误读的地方
- 两组的置信区间有没有重叠,回答不了“两组差异是否显著”。 正确做法是直接检验差值,第二张卡的第三张表就是干这个的:实测“城镇 − 农村”的基尼差值 0.0838、差值 95%CI [0.0284, 0.1287]、自助 p = 0.004、BH 校正 p = 0.004,判定“校正后仍有显著差异”。结论文案也把这条写了出来。要下“A 组比 B 组更不平等”的判断,看的是这张差值表,而不是把两条区间摆在一起目测。
- 同一份数据的八个不平等指标不能混着引用,它们对分布不同部位的敏感度不同。 实测同一份数据 G = 0.3750、泰尔 T = 0.2423、平均对数离差 = 0.2317、Atkinson(ε=1) = 0.2068、变异系数 = 0.7955、Hoover = 0.2762、帕尔马比 = 1.5805、20:20 比 = 6.6392。表注把各自的偏好列了出来:基尼对中部敏感、泰尔 T 对顶端敏感、平均对数离差(MLD)对底端敏感、变异系数(CV)对极端值最敏感。同一份数据换个指标,“不平等严不严重”的观感可以完全不同——挑一个数值最合意的指标写进结论,是这类分析最常见的误用。
- 组内 / 组间那张分解表用的是泰尔指数,不是基尼。 实测分解结果是组内 0.164647(贡献 67.95%)、组间 0.077663(贡献 32.05%),合计正好等于总体泰尔 T = 0.242309。这是因为泰尔指数满足严格可加分解,而基尼在组与组的取值范围有重叠时分解会多出一项残差、不能干净拆开。所以写“按城乡把基尼分解成组内与组间”是错的,报告也没有这样做。
- 0.4 那条警戒线读的是点估计,别当成“确定没过线”。 实测 G = 0.3750,判定为“相对合理”,而它的 95% 置信区间上端是 0.4041——已经越过 0.4。分档是国际惯例的经验标签,不是统计检验的结论;结论落在分档边界附近时,必须把置信区间一起报出来,否则“未达警戒线”这句话的把握程度会被严重夸大。
- 基尼低估的程度取决于样本量,跨样本量比较前要先修正。 它在小样本下的期望约为真值的 (n−1)/n 倍。实测 N = 300 时 G = 0.3750、修正后 0.3763、偏差因子 0.9967,差别可以忽略;但拿一个 n = 40 的群体去和 n = 3000 的群体比,前者会被系统性地压低。报告里给了原值与修正值两个数,论文中报的是哪一个必须写清楚,两个群体之间也必须用同一口径。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:基尼系数与置信区间
- 输出结果三:洛伦兹曲线
- 输出结果四:效应量与结构分解
- 输出结果五:结论与学术表述
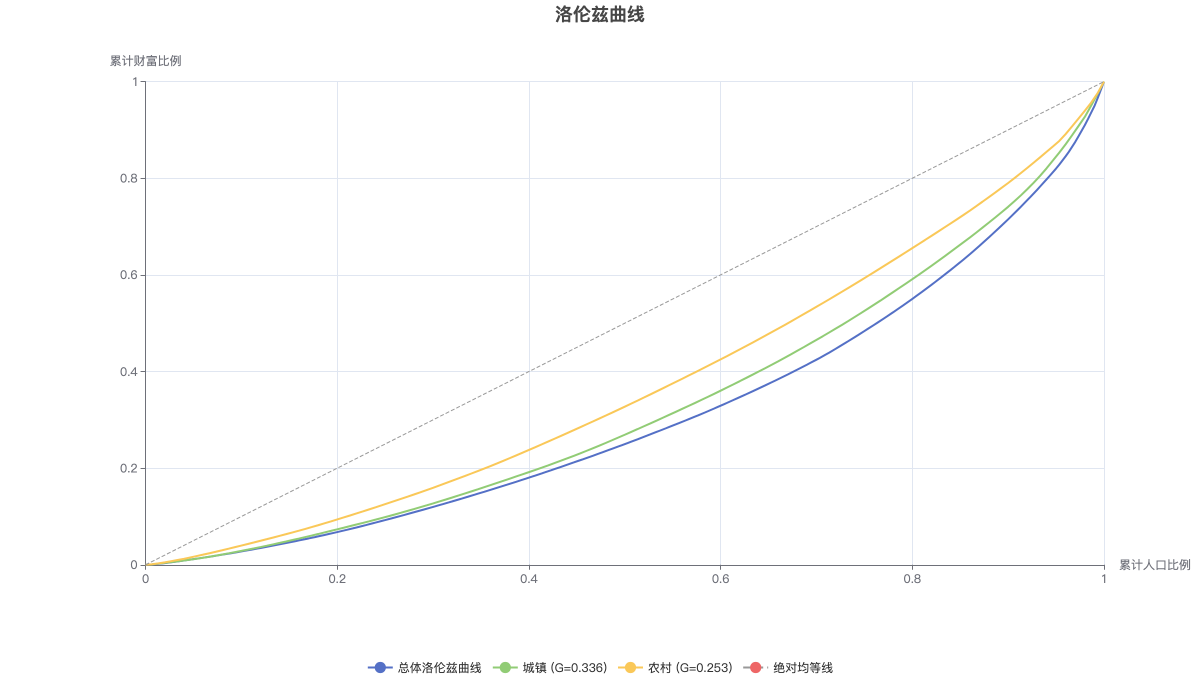
横轴为按收入/财富升序排列后的累计人口比例,纵轴为对应的累计财富比例;虚线为 45° 绝对均等线。可用右上角切换器切到「表格」视图,逐点读取累计人口占比、累计财富占比及二者之差。