
两阶段回归
这个方法是做什么的
当某个解释变量与扰动项相关时——遗漏了同时影响它和结果的变量、两者互为因果、或者它被测量得不准——普通最小二乘的系数就不再是因果效应,而且样本再大也不会收敛到真值。两阶段最小二乘的办法是借一个工具变量 Z:它只通过内生变量影响结果。第一阶段用 Z(连同外生控制变量)预测内生变量,第二阶段用这份预测值代替原变量进入回归,于是只有“由 Z 驱动的那部分变异”被用来识别系数。
报告把识别条件拆成三条逐条判读:阶条件(工具数是否不少于内生变量数)与秩条件(工具够不够强)可以由数据检验,排除性约束不可以,卡① 会把它明确登记为“无法由数据检验”。此外还有:逐个内生变量的第一阶段 F 与 partial R²、解释变量的 VIF、Wu-Hausman 内生性检验、过度识别时的 Sargan 检验、OLS 与 2SLS 的系数并排对比表(差值即内生性偏误的量级与方向)、以及第二阶段的系数森林图。注意 R² 这一项:表注写明工具变量估计的 R² 不具备常规的方差解释比例含义,甚至可能为负,不应用作模型好坏的判据。
需要准备什么数据
- 放入 [定量] 因变量 (Y):1 个,定量变量(数值)
- 放入 [定量] 内生变量 (X1):至少 1 个,定量变量(数值)
- 放入 [定量] 工具变量 (Z):至少 1 个,定量变量(数值)
- 放入 [定量] 外生变量 (X2)(可选):定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 解释变量与被解释变量互为因果(资本投入与产出、警力与犯罪、广告与销量)
- 关键混杂变量测不到,但存在一个制度性、地理性或政策性的外生变异来源可作工具
- 解释变量有明显测量误差,需要一个不含该误差的外生变异来源
- 想量化“内生性到底让 OLS 偏了多少”——卡④ 的 OLS 对比表直接给出差值与方向
工具变量个数必须不少于内生变量个数,否则模型不可识别;四个拖拽区的变量互不重复,各列须为定量且非常数列;2SLS 是大样本方法,样本量建议不少于 50。
什么时候不要用它
- 找不到能论证的工具,只是随手挑了一个相关变量:这比不做还糟,见下方第一条实测。老实用「线性回归 (最小二乘法)」把关联说清楚,并在文中写明内生性风险与它对结论的可能影响。
- 有政策时点和对照组:识别来自设计而非工具,用「双重差分(DID)」;两组基线差得多时用「PSM-DID」。
- 分配由一条分数线决定:过线本身就是最干净的那类工具,直接用「断点回归(RD)」,它还会替你检验密度操纵与协变量连续性。
- 混杂是可观测的,只是两组特征差得多:不必动用工具变量,用「倾向得分匹配 (PSM)」,它会强制检查共同支撑与协变量均衡。
- 内生性来自“结果只在部分样本上可观测”:这是样本选择而不是解释变量内生,用「Heckman两步法」。
- 面板数据,内生性来自不随时间变化的个体特征:用「面板模型」的固定效应可以直接把它差掉;被解释变量的滞后项进入方程时用「系统GMM动态面板」。
容易误读的地方
- 工具弱一点,结论可以整个翻过来。 实测把工具换成一个与内生变量关系很弱的变量:第一阶段 F 由 986.600 掉到 3.612、partial R² 只剩 0.0119,资本投入的系数由 1.0252(p<0.001)变成 −1.1922(p=0.339),符号都反了。卡① 会直接点名这件事,原话是:弱工具下 2SLS 的有限样本偏误可能超过 OLS,且稳健标准误严重低估,此时即便 Sargan 检验通过,估计与推断也都不可靠。看结果的顺序应当是先看 F,再看别的。
- Sargan 通过不等于工具有效。 表注写明它只是排除性约束的必要条件,恰好识别时更是完全无法检验。演示数据两个工具、一个过度识别约束,Sargan χ²(1)=0.578、p=0.447;换成一个工具之后这一行直接变成“不适用(恰好识别)”。而排除性约束本身,卡① 登记的是“无法由数据检验”,全部因果解释都压在它上面,只能靠制度背景论证。
- Wu-Hausman 显著,只说明 OLS 与 2SLS 不一样,不说明 2SLS 那一侧是对的。 在上面那个弱工具设定里,Wu-Hausman 仍然报 F(1, 297)=131.419、p<0.001,结论栏照旧写着“存在内生性,使用 2SLS 是必要的”,可这时 2SLS 给出的是一个符号相反、且不显著的系数。这个检验比较的是两个估计量的差,两个都偏的时候它照样显著。
- 本模块只输出同方差假定下的标准误,且没有异方差检验。 表注写明协方差类型是 unadjusted,Sargan 也是在这个假定下才有效;卡⑤ 的解释边界明说,若存在异方差应改用稳健标准误、此时 Sargan 须换成 Hansen J——但模块没有提供切换开关。数据明显异方差时,这里的 p 值与置信区间不能直接誊进论文。
- 2SLS 估的是 LATE,不是总体平均效应。 卡④ 的结论文案点明:它识别的是受工具影响的那部分个体上的局部平均处理效应,在效应异质时并不等于总体平均效应。换一个工具就换了一批“被工具推动的人”,两篇文章用不同工具得到不同的数字,未必有哪一篇算错了。报告里必须写清楚工具是什么,读者才知道这个效应是谁的效应。
报告里有什么
- 输出结果一:数据概览与识别条件检验
- 输出结果二:两阶段最小二乘(2SLS)第二阶段系数表
- 输出结果三:系数森林图与 OLS 对比
- 输出结果四:效应量与事后检验
- 输出结果五:结论与学术表述
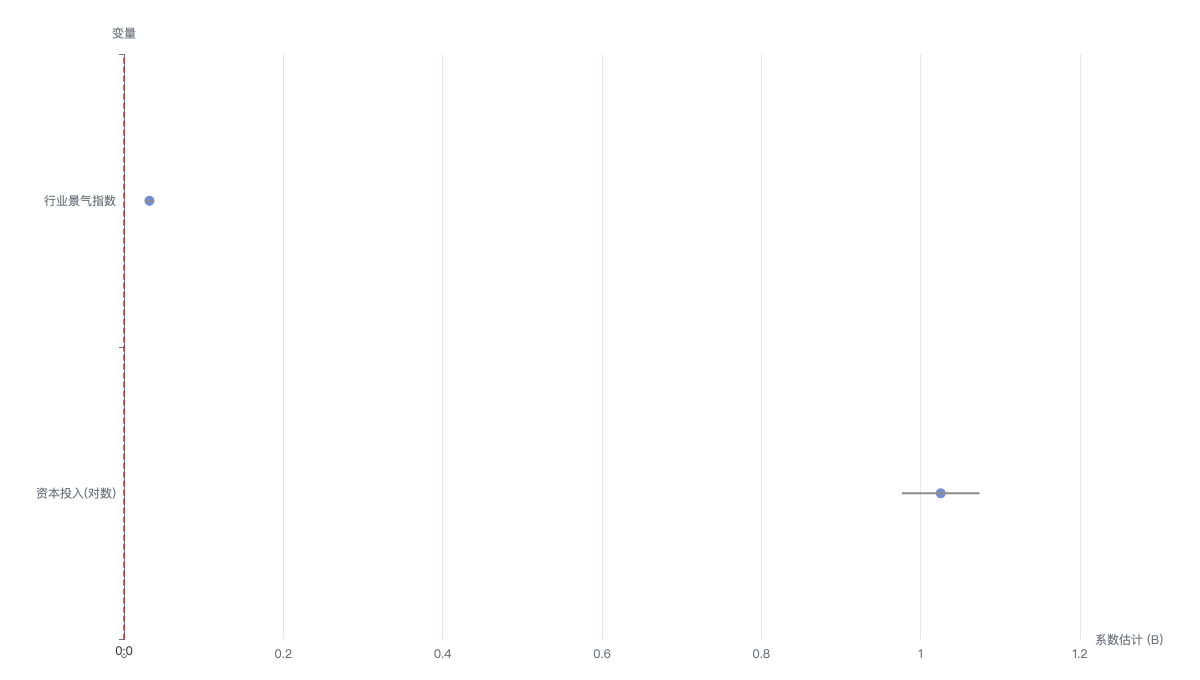
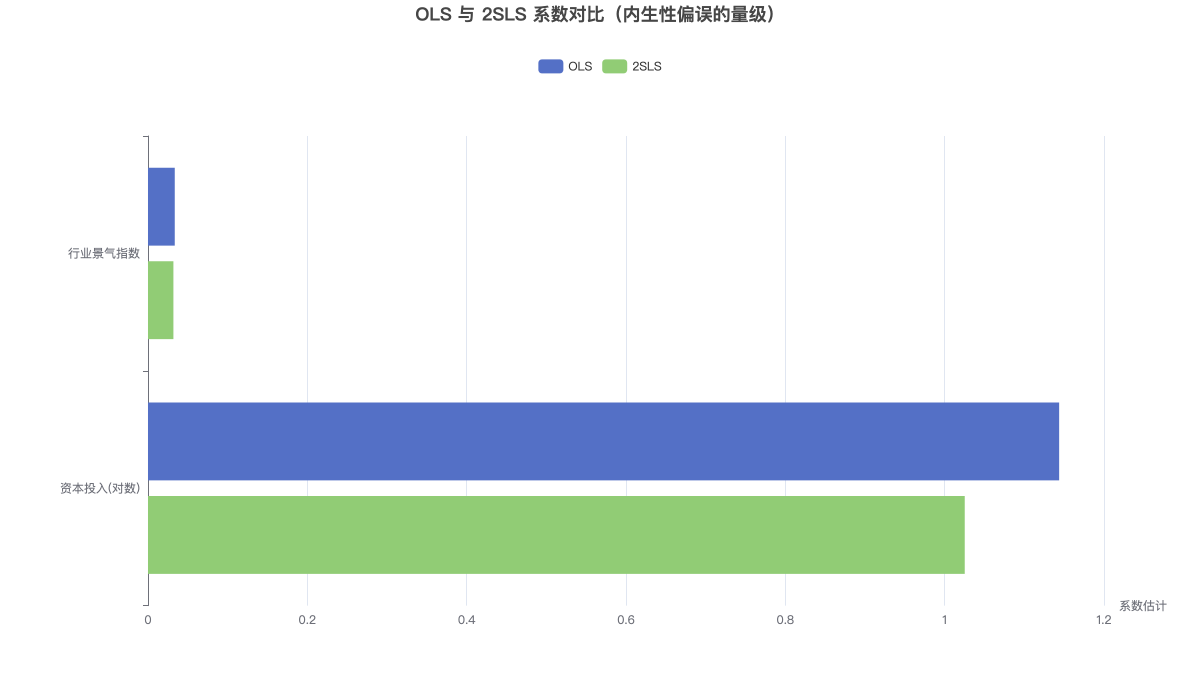
上图为第二阶段系数森林图:圆点为点估计,横向须为 95% 置信区间,须跨过红色零参考线表示不显著。为避免截距量级压扁图形,森林图已略去截距。 下图把 OLS 与 2SLS 的系数并排对比,两者差距即内生性偏误的量级。 两图均可用右上角切换器切到「表格」视图读取精确数值。