
NPS净推荐值分析
这个方法是做什么的
把“您有多大可能把我们推荐给朋友或同事”这道 0~10 分的题算成净推荐值:9~10 分记为推荐者、7~8 分记为被动者、0~6 分记为贬损者,NPS = 推荐者占比 − 贬损者占比,取值范围 −100~+100。评分列只能放 1 列,且必须是 0~10 的整数;越界与非数值记录会被剔除并在概览表里如实计数,非整数会四舍五入并单独计数。
NPS 本身只是一个描述性指标,这份报告的价值在于给它配上不确定性。卡② 给 NPS 的 95% 置信区间(示例 17.50,区间 [5.87, 29.13],标准误 5.93)、针对“NPS=0”的 z 检验,三类占比各自的 Wilson 区间,以及不依赖大样本近似的精确二项检验。卡④ 另给 Bootstrap 百分位区间(B=2000,种子固定)与两个尺度无关的效应量——Cohen's h 和推荐者∶贬损者人数比,并对三类人群做两两条件精确二项检验(Holm 校正)。
需要准备什么数据
- 放入[定量]推荐意愿评分:1 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 客户体验调研的推荐意愿题,需要一个能对外沟通的单一指标
- 报告里要说明这个 NPS 的抽样误差有多大、是否显著大于 0
- 想知道推荐者、被动者、贬损者三类人数之间的差异是否站得住(事后两两比较)
- 样本不大、担心正态近似不可靠时,需要 Bootstrap 区间与精确二项检验作旁证
前提:评分必须是 0~10 的整数量表,5 分制或百分制请先换算;推荐者与贬损者两类都要出现,否则 NPS 退化;三类人数建议都不小于 5,正态近似才可用;每位受访者只应有一条记录。数据表的行数下限实测为 30 行——29 行会被直接拦下——但使用说明建议至少 100 条,因为 NPS 的置信区间在小样本下会宽到无法解释。
什么时候不要用它
- 要比较两组或多组的推荐意愿(新老客户、不同城市):把 11 级压成 3 类会损失统计效率,卡⑤ 的方法学提示明确建议直接用平均评分做检验——两组用「独立样本T检验」,三组及以上用「多独立样本Kruskal-Wallis检验」。
- 要比较不同期次或不同人群的三类构成是否不同:那是分类变量的关联问题,用「列联(交叉)分析」批量扫,或用「卡方检验」做一对并查看逐格残差。
- 评分不是 0~10 分制(五星、百分制、七级李克特):本模块会把越界值整条剔除,先换算到 0~10 再进来;若只想描述分布,用「频数分析」看逐档人数,用「描述性统计」看均值与分位数。
- 想知道推荐意愿受什么因素驱动:NPS 是结果指标、不做建模,用原始 0~10 评分做「线性回归 (最小二乘法)」,把评分当有序等级则用「有序逻辑回归」。
- 想分析开放题里“为什么给低分”:本模块只吃数值评分,文本原因用「情感分析」判断倾向,用「词频统计」找高频抱怨点。
容易误读的地方
- NPS 相同不代表评分分布相同。 卡① 的图注写明:把 11 个刻度压成 3 类再相减会丢掉大量信息,两个 NPS 相同的样本其评分分布可以完全不同。示例 NPS=17.50 背后是 91/53/56 的人数构成与 7.38±2.70 的平均评分;而一份“91 人打 10 分、56 人打 0 分”的极端数据,NPS 同样是 17.5。报告因此并列给出逐分值分布与平均评分,写结论时应当一起带上。
- 被动者完全不进入 NPS 的计算,所以 NPS 只对跨线的移动敏感。 示例的 53 位被动者(26.50%)对这个数字没有任何贡献。把一个 7 分的人做到 9 分,NPS 会跳;把一个 6 分的人做到 7 分,NPS 也会跳(少了一个贬损者);而把 3 分做到 6 分、或 9 分做到 10 分,NPS 纹丝不动。用 NPS 的变化去说“整体满意度提升了多少”,等于用一个只认两条分界线的指标去描述连续的改善。
- 只报点估计而不报样本量与置信区间,是这个指标最常见的误用。 示例 N=200 时标准误已达 5.93 分,模块的结论句据此给出一句很实用的换算:即便真实 NPS 不变,再抽一批 200 人,NPS 也会在约 ±11.6 分内波动。所以季度之间从 17 变到 24,先看两期的区间是否重叠,再决定要不要说“提升了 7 分”。
- 那个显著性检验的原假设是 NPS=0,不是“达到了目标档位”。 卡② 的 z 检验只回答“推荐者是否多于贬损者”(示例 z=2.949,p=0.0032);而 >0 尚可、≥20 良好、≥50 卓越、≥70 世界级这套分档是业界经验值,不是任何检验的结论。示例 NPS=17.50 显著为正,但区间下限只到 5.87、上限已到 29.13,跨了“尚可”和“良好”两档——把 p<0.01 写成“显著达到良好水平”是把两件事拼在了一起。
- “每位受访者只有一条记录”这条前提,统计上验不出来。 卡① 的前提表把它标注为“由数据采集流程保证,统计上不可检验”,模块只能按独立同分布处理。同一个用户填了三次会被当成三个人,标准误被压低、区间被压窄,而报告里不会出现任何异常提示——重复填答要在进模块之前,到“重复值处理”里清掉。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:NPS 主结果表
- 输出结果三:可视化(评分分布、人群构成与 NPS 仪表盘)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
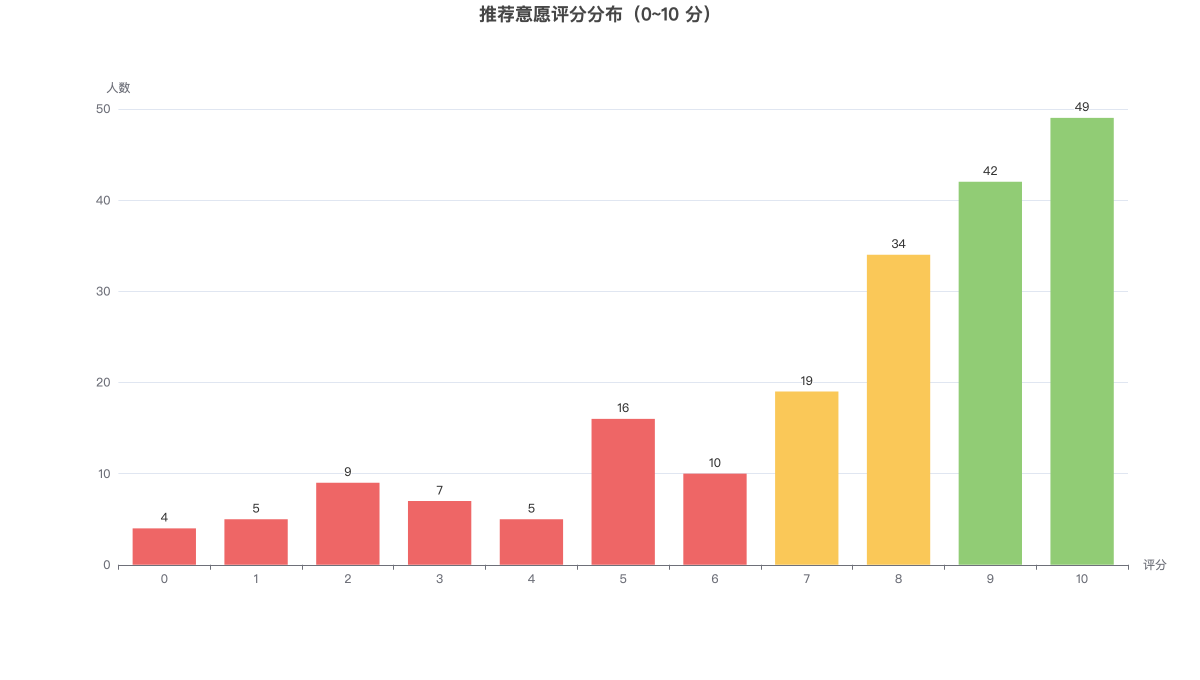
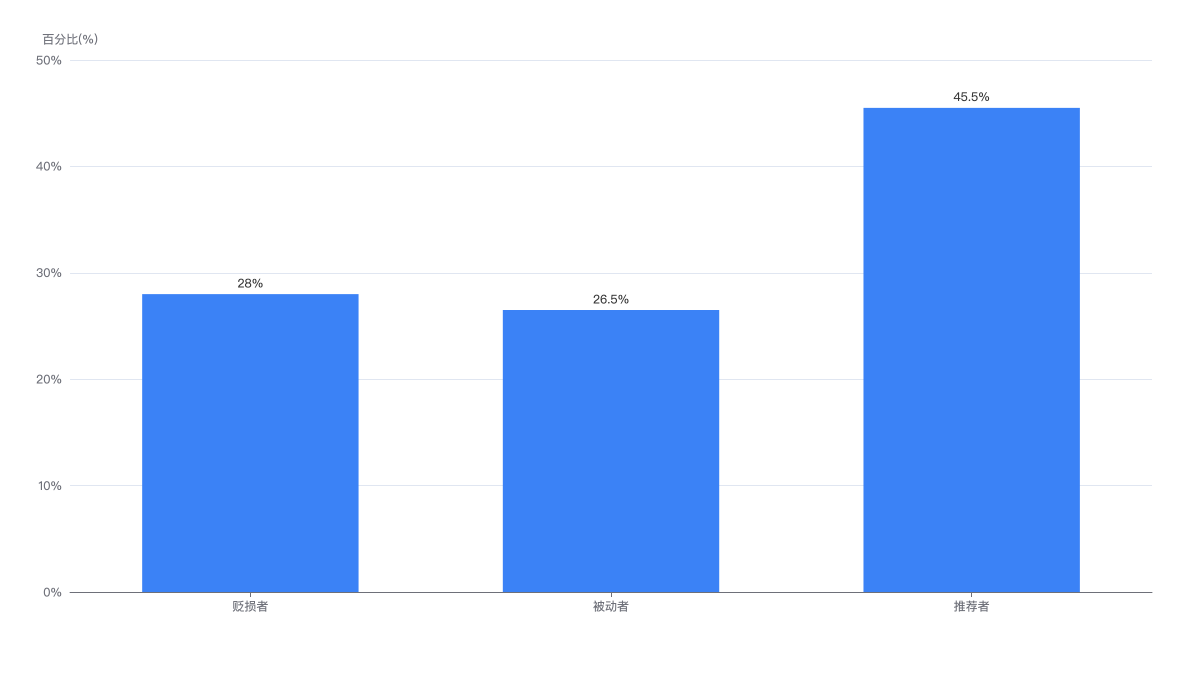
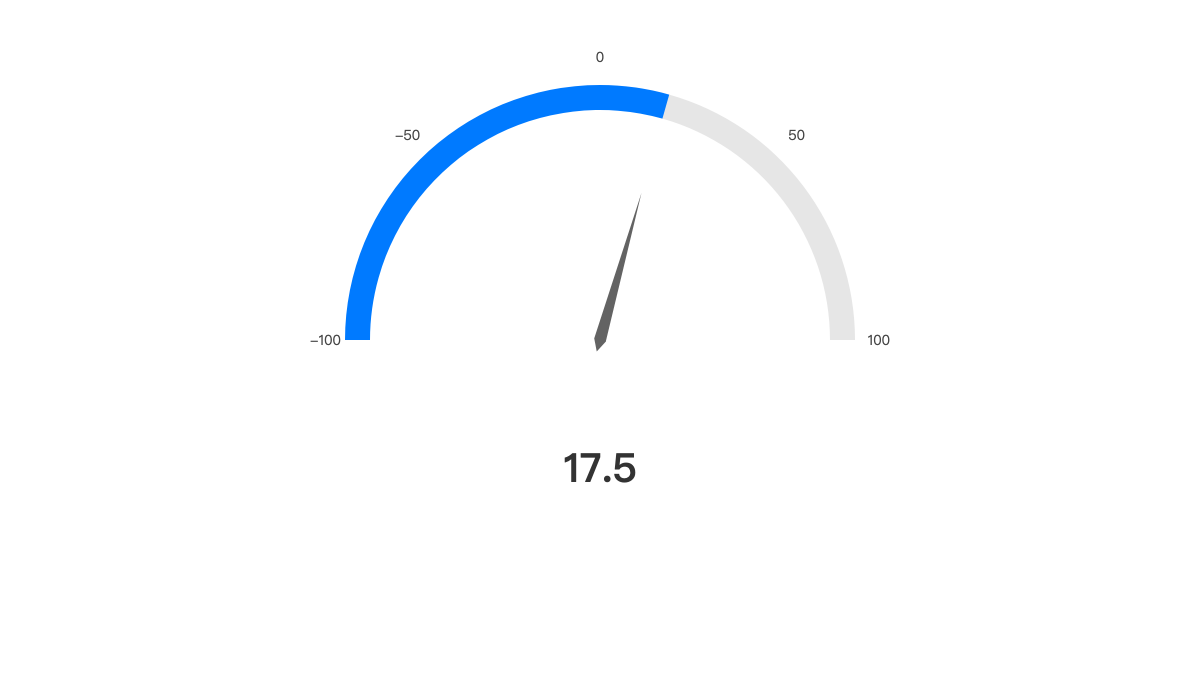
第一张图按 NPS 三分段着色展示 0~10 分的逐分值分布(可切换为柱状图/折线图/条形图/数据表);第二张图展示三类人群构成(可切换为柱状图/条形图/饼图/数据表);第三张为 NPS 仪表盘。