
多重插补
这个方法是做什么的
不是把缺失填一次,而是填 m 次(默认 5,可选 10 或 20)。链式方程每一轮用其余变量的当前取值预测当前变量,并从贝叶斯岭回归的后验里抽样,于是同一个缺失格在 m 套数据里会被填成 m 个不同的值——这些值之间的分歧,就是缺失带来的不确定性本身。卡① 会如实记下本次的设定:插补次数、最大迭代轮数与随机种子。
m 套数据分别算完之后按 Rubin 规则合并:合并标准误等于组内方差加上放大 (1+1/m) 倍的组间方差再开根,同时包含“本来就有的抽样误差”和“不同插补之间的分歧”,95% 置信区间用 Rubin 自由度的 t 分位构造。卡④ 把方差拆开摆给你看:组内方差、组间方差、相对方差增量、Rubin 自由度、缺失信息比与相对效率。要留意合并的对象——本模块合并的是各变量的均值,不是后续任何回归或检验的系数。
需要准备什么数据
- 放入待多重插补变量:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 20 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
- 单列缺失率不超过 60%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 缺失率不低(大约一到四成)且后续要报告置信区间或 p 值
- 缺失结构是“任意”而非单调,简单的逐步填补做不了
- 变量之间彼此相关,插补模型有信息可用(卡① 会给出变量间相关性与信息量判定)
- 论文或审稿要求交代插补模型、插补次数及其依据、合并规则与缺失信息比
至少需要 2 个定量变量——插补靠变量之间的相互预测,单个变量无从插起;所选变量中必须确实存在缺失,否则模块会直接拒绝;整行全缺失的记录不含任何可用信息,会被自动移除并在卡① 报出条数,因此有效样本可能比原始行数少。总行数至少 20 行。本实现基于线性高斯模型,对强偏态、计数型或有界变量须人工核查插补值是否落在合理范围。
什么时候不要用它
- 只是想拿一份填好的完整数据交给别的流程:本模块产出的是合并后的估计量,不产出一份“最终数据”,卡② 的完整数据只是预览。要一份填好的数据用「均值估计/回归插补」,并接受它压缩方差的代价。
- 待插补的是分类变量:只接受定量列。定类变量的缺失通常是把“缺失”当作一个类别参与分析,用「频数分析」看它占多少、用「列联(交叉)分析」看它是否与别的变量相关。
- 只有一个变量有缺失、没有别的变量与它相关,而且只要描述性的均值或占比:插补值只能回到均值附近,点估计与「均值估计/回归插补」里的均值估计基本一致,后者更省事。但只要还要报标准误或区间,就仍该用多重插补——两者点估计像,方差口径不像。
- 还没看过缺失结构与机制线索:先跑「缺失模式分析表」——它会告诉你缺失是单调还是任意、哪些变量成组地一起缺,后者直接决定插补模型该拉进哪些变量。
- 要合并的是回归系数或组间比较,而不是各变量的均值:本模块只把 m 套数据合并到均值这一层,不会把它们接到后续模型里。产品目前没有这条链路,可行的做法是用本模块的缺失信息比说明缺失造成了多大的信息损失,回归本身用「线性回归 (最小二乘法)」另做,并在文中如实写明缺失的处理方式与这一局限。
容易误读的地方
- 多重插补的要害不是“填得更准”,而是“把不确定性算进去”。 单看任何一套数据,它的填入值未必比回归插补更接近真值;示例里同一个“收缩压”缺失格在 5 次插补中的标准差平均达到 13.49,几乎与该变量自身的标准差 15.45 相当。正是这份分歧被计入了合并标准误。所以多重插补给出的置信区间比单一插补更宽——那是它对的地方,不是它差的地方。谁的区间窄谁更好,在这里是反的。
- 卡② 的“第 1 套完整数据”不能单独拿去用。 它只是 m 种合理猜测中的一种,表注写得很直白:任何单独一套完整数据都不能单独使用。从中挑一套导出来当作“填好的数据”,等于退回单一插补,还额外引入了挑选的随意性。多重插补的推断必须建立在全部 m 套的合并结果上。
- 缺失信息比不是缺失率。 示例中“总胆固醇”缺失率 10.79%,缺失信息比却是 13.19%;反过来,一个缺失率 30% 但能被其它变量很好预测的变量,缺失信息比可能只有 5%。它回答的是“最终估计里有多大比例的信息来自插补而不是观测”,同时取决于缺了多少和缺的部分能不能被补回来。论文里该报的是它、m 与合并规则,只写一句“使用了多重插补”是不够的。
- 报告建议“提高到约 14 次”时,控件里只有 5 / 10 / 20 三档,应当选 20。 经验法则是插补次数不小于缺失信息比的百分数,示例最大缺失信息比 13.19%,于是 m=5 被判为“偏少”。注意此时相对效率已达 97.43%,很接近 100%——但相对效率高只说明再加 m 对点估计的效率提升有限,m 偏少仍会让组间方差与 Rubin 自由度估得很毛糙、区间跟着不稳。拿相对效率高来给 m=5 开脱,是把两件事混成了一件。
- 换一个随机种子,填入值和合并结果都会变。 后验抽样本身就是随机的,这是方法固有的蒙特卡洛误差,不是结果不可靠。但它有两个实际后果:论文里必须写明插补次数、迭代轮数与种子,别人才复现得出来;如果换个种子结论就翻了,说明 m 太小或缺失太多,正确的反应是加大 m,而不是挑一个“好看”的种子。
- 插补模型是线性高斯的,它不知道你的变量有边界。 对强偏态、计数型或有界变量(人次、金额、0~100 的量表分),后验抽样可能填出负数或超出量程的值,卡① 的“插补模型设定”一行明确要求人工核查。发现越界值时,可先用「数据变换(Box-Cox/Yeo-Johnson)」把变量拉近正态再插补。另外插补模型应当“富含”变量:后续分析要用到的变量都该放进来,否则插补值在那些维度上是无关的,会人为削平真实存在的关系。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(Rubin 合并估计)
- 输出结果三:可视化(缺失率 / 插补不确定性 / 各套估计的波动)
- 输出结果四:效应量与事后分析(Rubin 方差分解 / FMI / 相对效率)
- 输出结果五:结论与学术表述
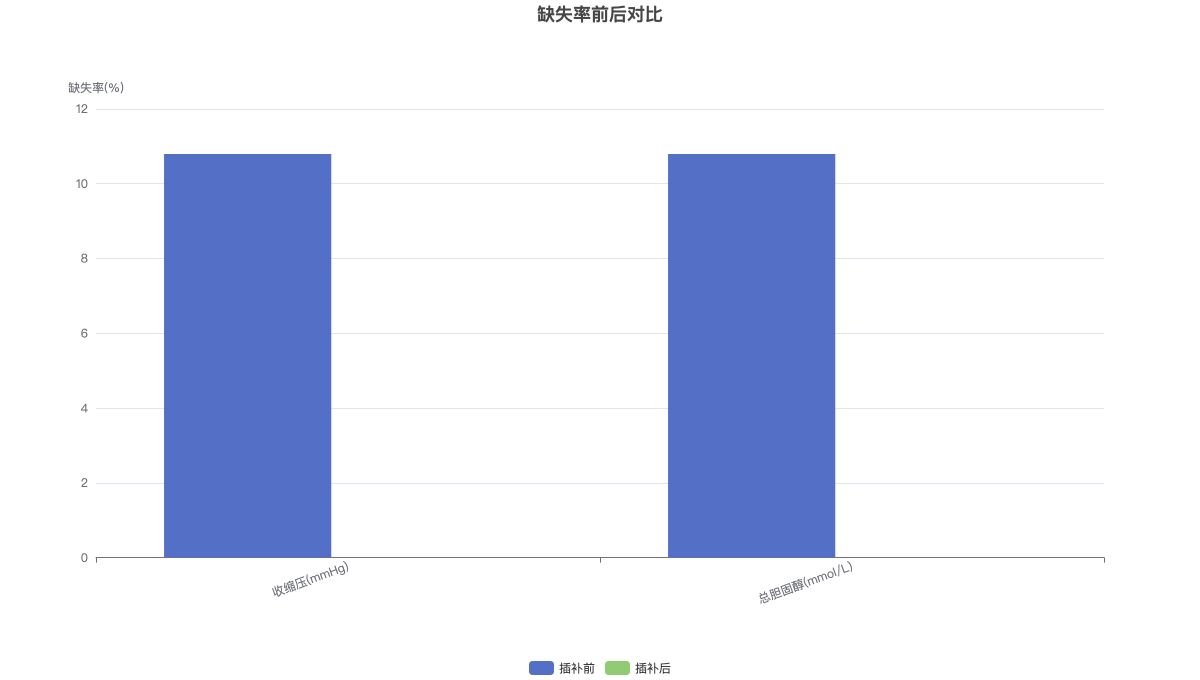
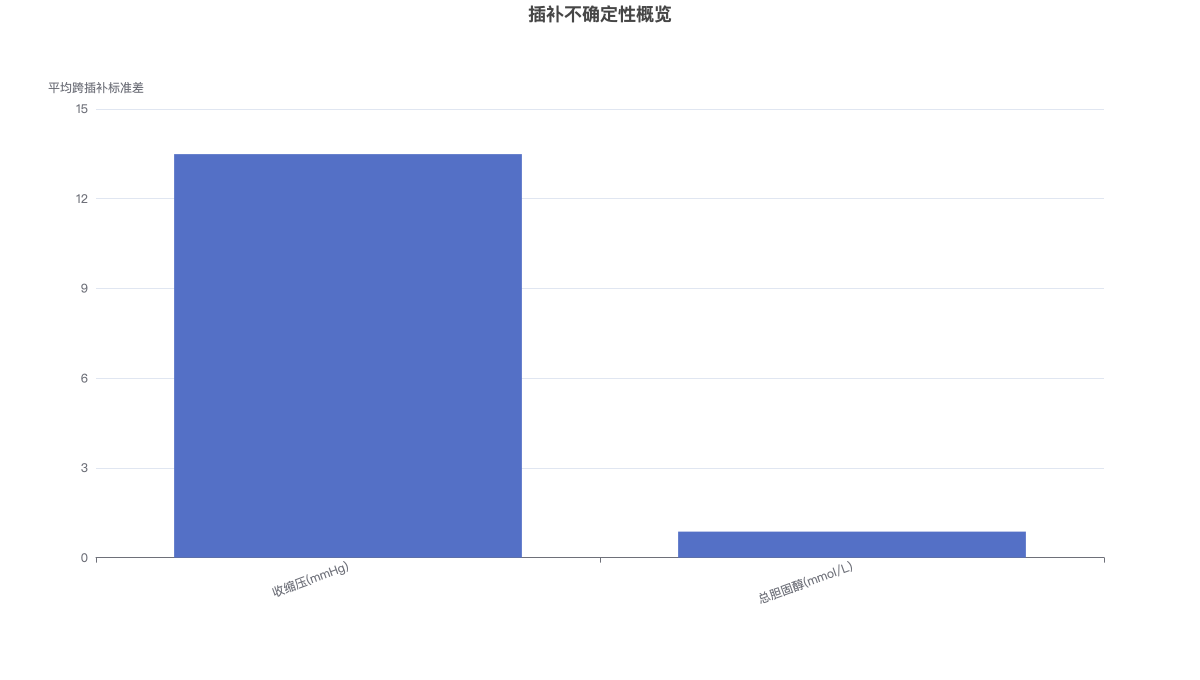
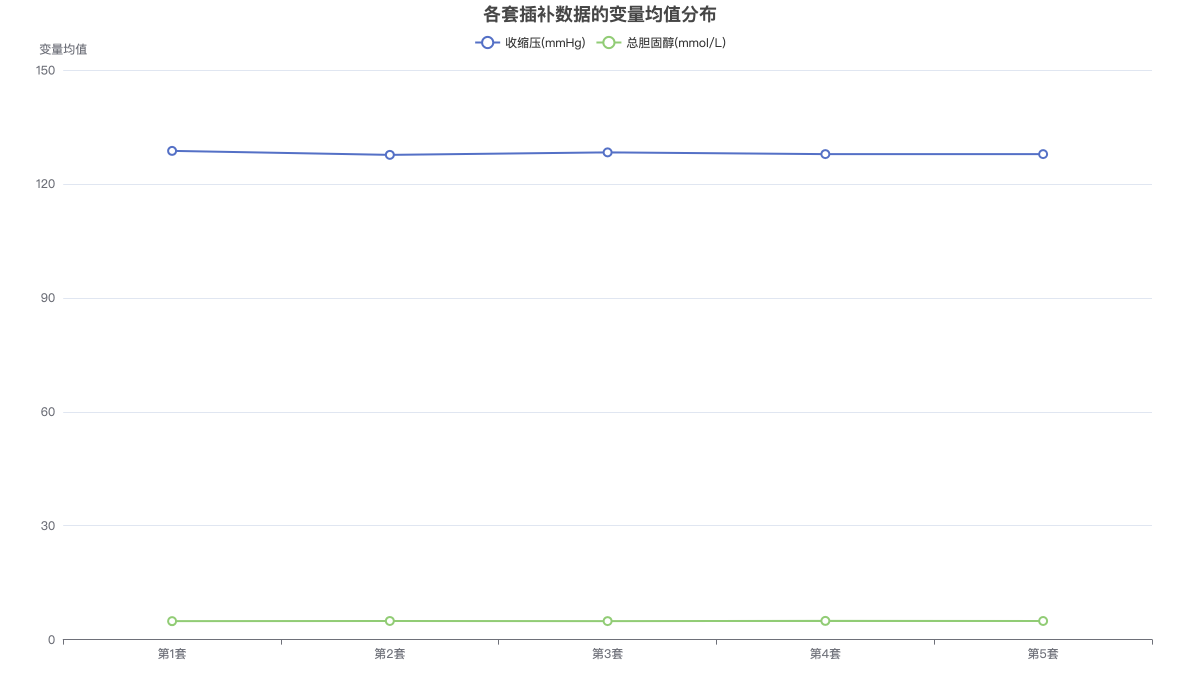
三张图分别回答:缺失是否被填满、各变量缺失位置的不确定性有多大、不同插补套次之间的估计波动有多大。