
Lasso回归
这个方法是做什么的
在最小二乘的目标函数上加一个 L1 惩罚项,把不重要的自变量系数压缩到恰好 0,从而在建模的同时完成变量选择——最后留在表里的就是模型选中的那批变量。代价有两条:系数是向 0 收缩的有偏估计,不能当无偏偏效应读;在一组彼此高度相关的变量里,它会任意挑一个留下而压掉其余,谁被选中相当依赖这批样本的偶然结构。这正是它与同族方法的分工——「岭回归(Ridge)」只压不删,「ElasticNet回归」让共线的一组变量倾向于一起去留,「逐步回归」则按 p 值增删。
惩罚系数 λ 默认由交叉验证在 1e-4~1e2 的网格上自动寻优(最小化折间平均 MSE),也可以在控件里手动指定。因为 L1 惩罚对量纲敏感,全部自变量统一做标准化,且标准化被放进 Pipeline、在每个训练折内独立拟合,避免信息泄漏。主结果是交叉验证的 R²、RMSE、MAE(均值 ± 标准差、折间均值的 95% 置信区间)与训练集回代值的对照,以及两者的过拟合差量。系数表只给非标准化系数 B、标准化系数 β 和“是否保留”,不给 t 值与 p 值。第三张卡有系数轨迹图、交叉验证 MSE 曲线(带 ±1 标准误范围)与拟合对照图;第四张卡用 200 次自助重抽给出 β 的 95% 百分位区间、区间是否跨 0、以及每个变量的入选频率。
需要准备什么数据
- 放入 [定量] 因变量Y:定量变量(数值)
- 放入 [定量] 自变量X:至少 1 个,定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 候选自变量一大堆,想让数据把清单压短,得到一个稀疏、好写好讲的模型
- 目标是预测,需要一个自带样本外评估(交叉验证 R²/RMSE)的模型
- 想区分“稳健入选”与“换批样本就掉出去”的变量——这正是入选频率那一列回答的问题
- 变量多又共线,OLS 系数已经乱了,而你能接受删掉其中一部分
因变量与全部自变量必须是定量、非常数列;列表删除缺失后的有效样本量必须大于自变量个数加一。交叉验证折数按样本量自动取,最多 10 折,样本少时会降到 2~4 折——折数少时每个验证折更大、折间标准差反而更小,但折间均值 95%CI 的自由度只剩折数减一(2 折时 t 临界值高达 12.7),区间会很宽,别把小的标准差读成估计更准。第一张卡会列出实际用了几折。系数表里的 β 是标准化尺度上的直接估计值,可用于比较相对重要性;B 是按各自变量标准差换算回原单位的结果。
什么时候不要用它
- 你要的是每个系数的无偏偏效应,以及它的 p 值和置信区间:Lasso 给不了,L1 惩罚使经典 t 检验的抽样分布不成立。用「线性回归 (最小二乘法)」,共线严重时先用「VIF共线性诊断」查清楚是哪几个变量凑成的。
- 不希望任何变量被删掉,只想把共线下的系数稳住:用「岭回归(Ridge)」,它同样收缩系数但永远不置零,而且照常给出 t 与置信区间。
- 共线的是一组同源指标(如同一量表的几个维度),希望它们同进同出:Lasso 会任选其一,用「ElasticNet回归」的分组效应更合适;若想干脆把它们压成一个综合维度再进模型,用「主成分分析(PCA)」。
- 变量该怎么分组是理论早就定好的,你要检验的是某一组变量有没有带来额外解释力:那是增量问题不是筛选问题,用「分层回归」看 ΔR² 与 ΔF。
- 自变量有定类列,或因变量不是数值型:本模块只收定量列。定类自变量先用“数据编码”转成数值,或改用会自动做哑变量编码的「线性回归 (最小二乘法)」;因变量是 是 / 否 用「逻辑回归」,是等级用「有序逻辑回归」,是计数用「计数数据回归」。
- 变量比样本还多:模块要求有效样本量大于自变量个数加一,达到或超过会被直接拒绝。先用「特征筛选」按单变量关联把候选压到样本量以下再回来。
容易误读的地方
- 系数被压为 0,只说明“在当前样本与这个 λ 下没被选入”,不等于该变量与因变量无关。 在共线的一组变量里 Lasso 只会留一个,留谁带有偶然性。判断一个变量稳不稳,要看第四张卡的入选频率——200 次自助重抽里它被选中的比例,而不是看它这一次在不在表里。写报告时对落选变量的正确表述是“本研究未能识别”,不是“无关”。
- 不要给 Lasso 系数配上 OLS 的 p 值。 用全变量最小二乘跑一遍、把那套 p 值贴到 Lasso 系数旁边,是常见但错误的做法,本模块因此干脆不出 t 与 p。唯一合理的替代品是第四张卡的自助 95% 区间加入选频率:前者说效应有多大,后者说这个变量会不会被选中。但那个区间本身也偏窄——它没有计入选 λ 这一步的不确定性,要作保守解读。
- λ 由交叉验证选出,再用同一份交叉验证报告性能,结果会偏乐观。 模块如实声明了这点,没有做嵌套交叉验证,所以交叉验证 R² 这个数字本身也略微高估。还要留意第一张卡对 λ 的标注:一旦提示最优 λ 落在搜索网格的下界,说明真正的最优值可能更小、L1 惩罚几乎不起作用、结果接近普通最小二乘——这时“变量选择”与“入选稳定性”两节几乎没有信息量,因为谁也没被压掉。
- 第三张卡轨迹图横轴的“K 值”与岭回归的 K 不是一回事,方向恰好相反。 这里的 K 是当前 L1 范数与无惩罚最小二乘 L1 范数之比:K 趋近 0 是惩罚最强、K 趋近 1 是没有惩罚。而「岭回归(Ridge)」里的 K 是惩罚强度,K = 0 才等于最小二乘。两个模块的图并排看时极易读反方向。
- 训练集那条线不是模型的本事。 拟合对照图画的是回代预测,第二张卡的训练集列同理,它们必然偏乐观,只用来量过拟合。模型性能一律以交叉验证列为准,两者之差就是过拟合的量级。同时要看折间标准差与折间均值的 95% 区间:区间很宽(尤其折数被降到 2~4 折时)说明“性能到底是多少”本身就没估准,不要拿一个宽区间的中点当结论。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:交叉验证性能与 Lasso 系数
- 输出结果三:系数轨迹、交叉验证曲线与拟合效果
- 输出结果四:系数不确定性、入选稳定性与过拟合量化
- 输出结果五:结论与学术表述
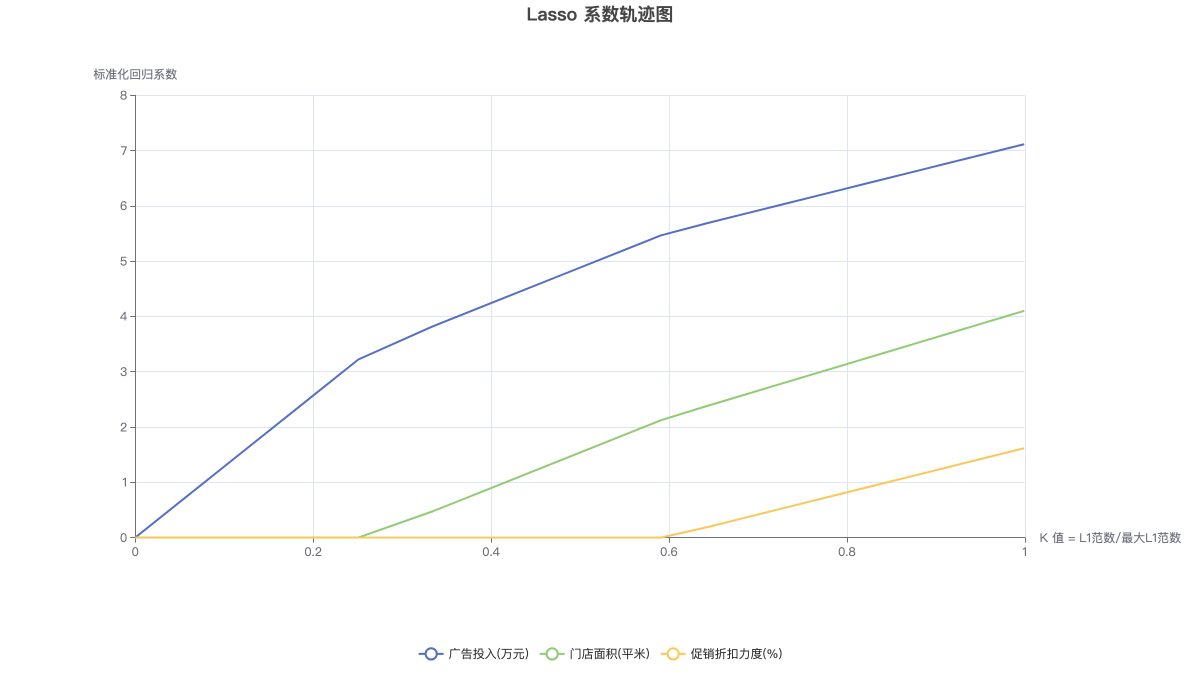
横轴 K 值为当前 L1 范数与无惩罚 OLS 的 L1 范数之比(K→0 惩罚最强、K→1 无惩罚),纵轴为标准化回归系数。每条线是一个自变量的系数随惩罚放松的变化轨迹。
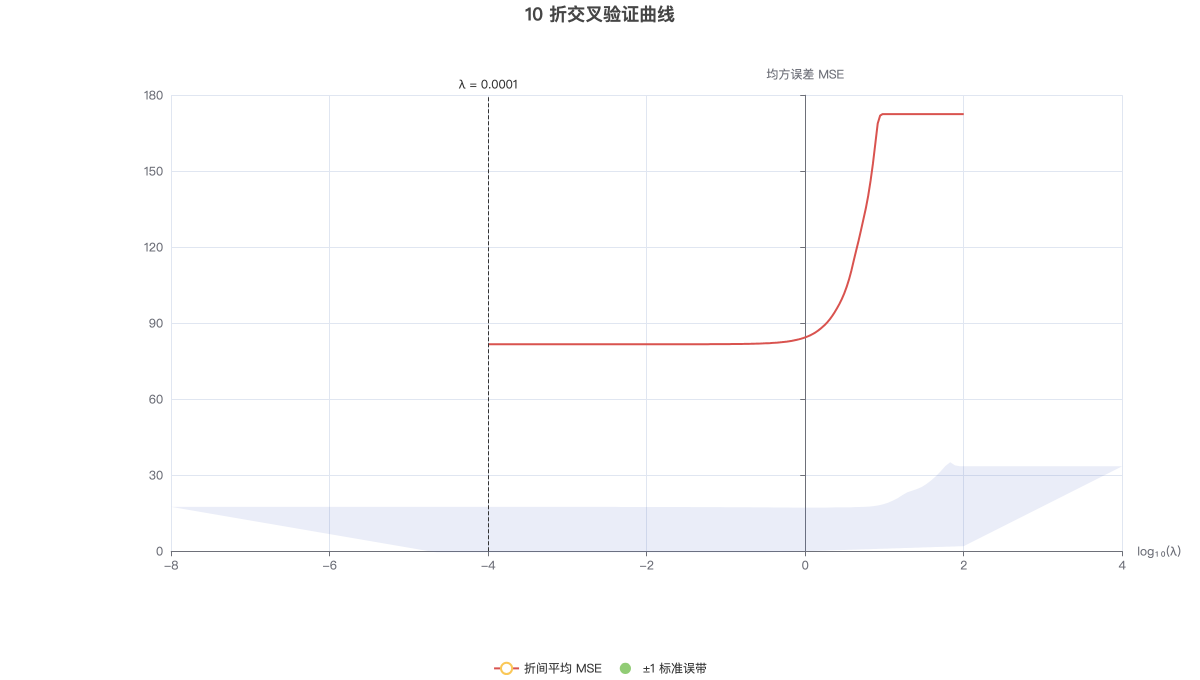
横轴为 log₁₀(λ),纵轴为 10 折交叉验证的平均 MSE,浅蓝带为 ±1 标准误范围,黑色虚线标出选定的 λ = 0.000100(使平均 MSE 最小)。
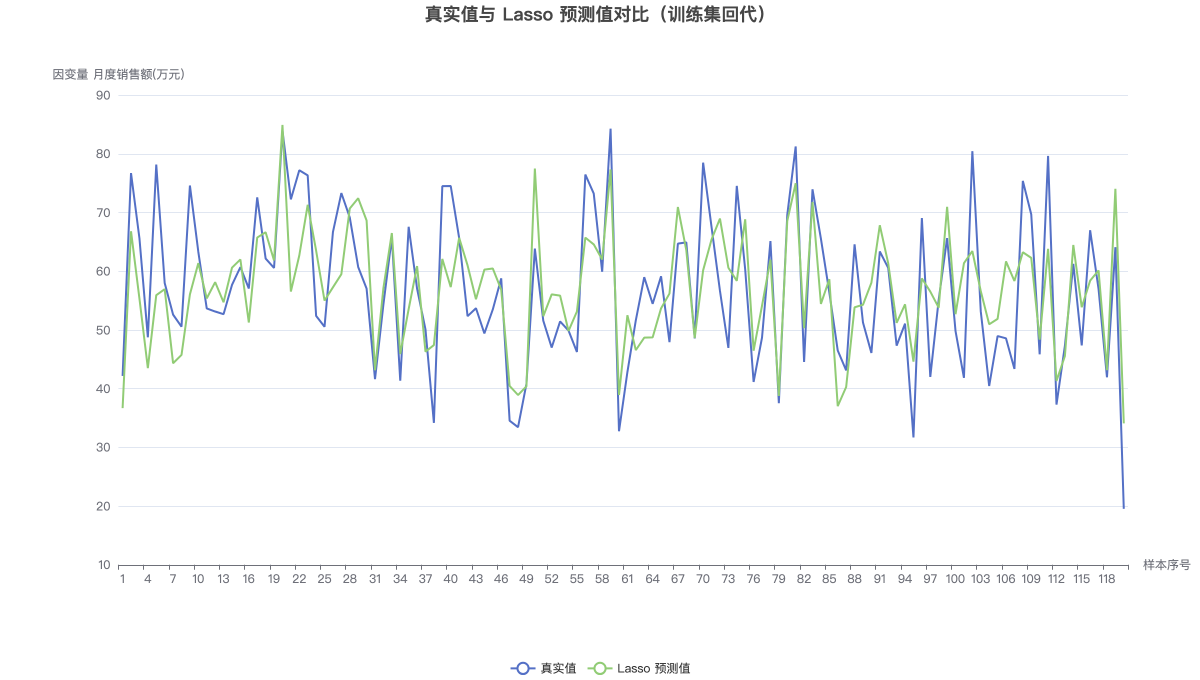
两条线分别为样本真实值与模型预测值(横轴为样本序号)。**注意这是训练集回代**,不是样本外预测——样本外表现请看表5 的交叉验证列。