
泰尔指数(Theil)
这个方法是做什么的
度量一个正数值变量(收入、财富、产值、床位数)分配得有多不平等。它区别于其他不平等指标的关键在于可加分解:总不平等能干净地拆成“组间”与“组内”两块,两块相加恰好等于总量,没有余项。泰尔指数 T 属广义熵指数族的 α=1 情形,T=(1/n)·Σ(x_i/x̄)·ln(x_i/x̄),T=0 表示完全平等、越大越不平等。定义里有 ln(x/x̄),所以要求全部取值严格为正,出现 0 或负值端点会在计算前直接拦截。
报告把三个测度并列给出:T(GE(1),对高端差异更敏感)、L/MLD(GE(0),对低端差异更敏感)与基尼系数,各配 1000 次非参数自助法的百分位区间(随机种子固定为 20260805),另给标准化 T/ln(n) 便于跨样本比较。卡③ 是洛伦兹曲线加各组贡献图,卡④ 是组间/组内分解与逐组贡献明细。要留意的是:泰尔指数是描述性测度、不设定原假设,因此整份报告没有一个 p 值,卡① 那张“适用前提核查”检的是定义域与“有没有实质性不平等”,不是显著性。
需要准备什么数据
- 放入[定量]分析变量:不限
- 放入[定类]分组变量(可选):不限
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 「放入[定类]分组变量」的类别数需在 2~50 之间。
- 「放入[定类]分组变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 要回答“差距主要在群体之间还是群体内部”:城乡之间还是城乡各自内部、行业间还是行业内、区县间还是区县内
- 需要一个可加分解的不平等指标写进论文或政策报告,且要说清各组各贡献了多少
- 分布明显右偏、少数高值把均值拉高,想量化这种集中程度
- 想同时从高端敏感(T)与低端敏感(L)两个视角看,判断不平等主要出在分布的哪一端
分析变量必须全部为正数值。分组变量可选:若拖入须为定类列,有效样本中至少 2 个组、每组至少 2 个观测,否则无法做组间/组内分解。样本量建议不少于 30,样本太小会让自助法置信区间宽到没有参考价值。
什么时候不要用它
- 数据里有 0 或负值(零收入、亏损、负资产):ln(x/x̄) 无定义,端点会直接拦截。用「基尼系数与洛伦兹曲线」,它接受非负数(含 0),只拒绝负值。
- 手上是分组汇总数据而不是个体微观数据(各收入段的人数与总额):把组均值当个体值代入会系统性低估不平等,需要改用分组公式,本模块与「基尼系数与洛伦兹曲线」都按个体级微观数据计算。
- 你要比较的是两组的平均水平高低,而不是分配形态:用「独立样本T检验」,分布偏态时用「独立样本 Mann-Whitney U 检验」。
- 要给一批对象按多项指标算综合得分再排名:那是综合评价不是不平等度量,用「优劣解距离法(TOPSIS)」或「熵值法」。
- 只想看分布形状、分位数与偏度:用「描述性统计」,看分段人数用「频数分析」。
- 要检验两个时点或两个总体之间的不平等差异是否显著:本模块不做假设检验,只给各自的自助法区间,看两个区间是否重叠是弱判据。产品内可做的是把两批观测合成一列、另加一个标记来源(时点/总体)的定类列拖进分组区,直接读“来源”这一维贡献了多少组间差异;若你真正想问的是分布整体有没有移动,用「独立样本 Mann-Whitney U 检验」——但它检验的是位置而非不平等程度。
容易误读的地方
- 不拖分组变量,卡④ 不会消失,它会改按分位数自动分组——占比会完全变样。 实测同一份数据:按真实的“城乡类型”分解,组内占 68.97%、组间占 31.03%;把分组变量去掉后,模块自动按分析变量自身的五等分位分组,组间占比跳到 86.85%、组内只剩 13.15%。这是必然结果——分组本身就是按取值高低切出来的,组间差异当然主导。报告在卡① 就预告了会改用等分位分组,卡③、卡④、卡⑤ 三处都标着“探索性”“请勿据此下政策结论”;但那张表的形状与真分组时一模一样,很容易被顺手抄进论文。
- “组内为主导”是分组口径的结论,不是数据的固有属性。 换成按地区、按行业、按学历分,会得到完全不同的一套占比。所以正确的写法是“按城乡类型分解,组内差异占 68.97%”,而不是“该地区的不平等主要来自组内”。卡⑤ 的方法局限也是这么表述的:分解结果依赖分组口径。
- 组间贡献可以是负数,这不是算错。 逐组明细里 s·ln(s/p) 那一列,份额低于人口占比的组为负(演示数据“农村”s=0.3156 < p=0.5000,贡献 −0.1452),高于的为正(“城镇”+0.2149),两者加总才是组间泰尔且恒 ≥0。看到负号不要理解成“这个组降低了不平等”,它表达的是该组在分配中处于份额偏低的一侧。
- T、L 与基尼这三个数不能互相比大小。 演示数据 T=0.2245、L=0.2174、G=0.3659,基尼看着大得多,但三者的取值范围与敏感区段都不同:T 对高端差异更敏感、L 对低端更敏感、基尼对中段更敏感。报告文案明说“两者与基尼系数方向一致但数值不可直接比较”。只有同一个指数在不同样本或不同时点之间才可比,跨研究引用时必须把指数族一起写出来。另外,基尼系数不像泰尔那样可加分解,做组间/组内拆分时会多出一个交叠项——这正是分解型研究选泰尔的原因。
- 没有 p 值不是漏做,是这个指标本来就没有原假设。 卡① 表注专门写了“泰尔指数无原假设,故本表不含 p 值”。因此不能说“不平等显著”,只能报告点估计与自助法区间;“显著上升/下降”这类措辞在这份报告里没有对应的统计依据。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:不平等测度与置信区间
- 输出结果三:洛伦兹曲线与各组贡献可视化
- 输出结果四:不平等来源分解与各组贡献
- 输出结果五:结论与学术表述
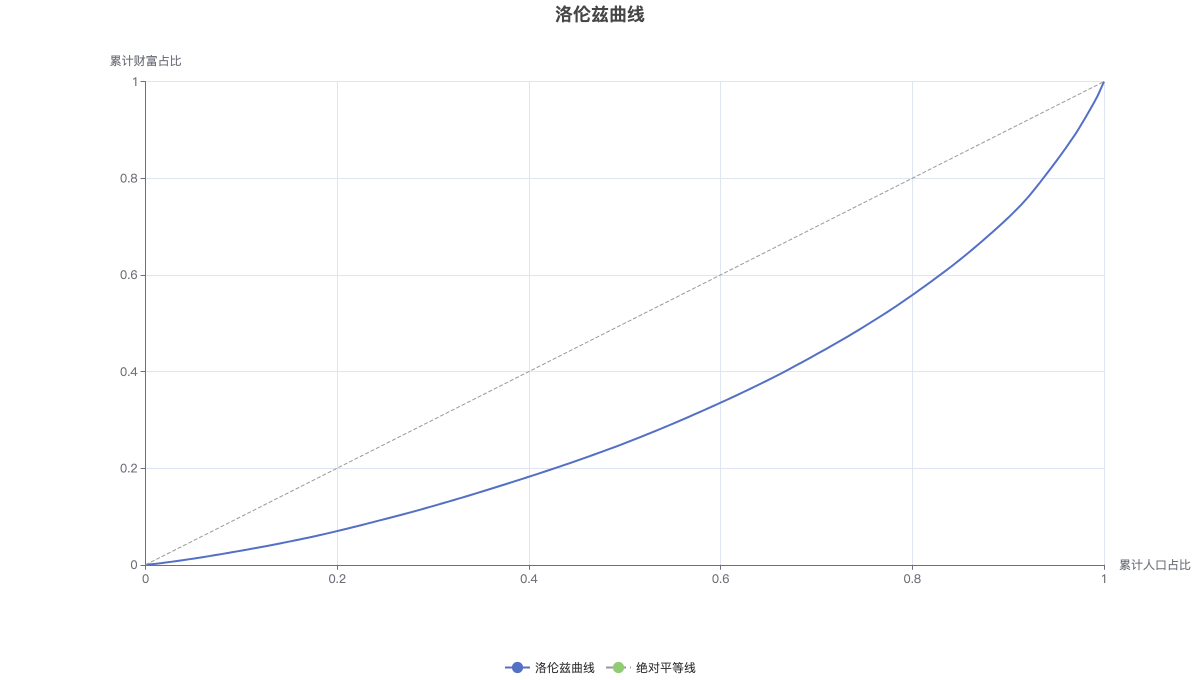
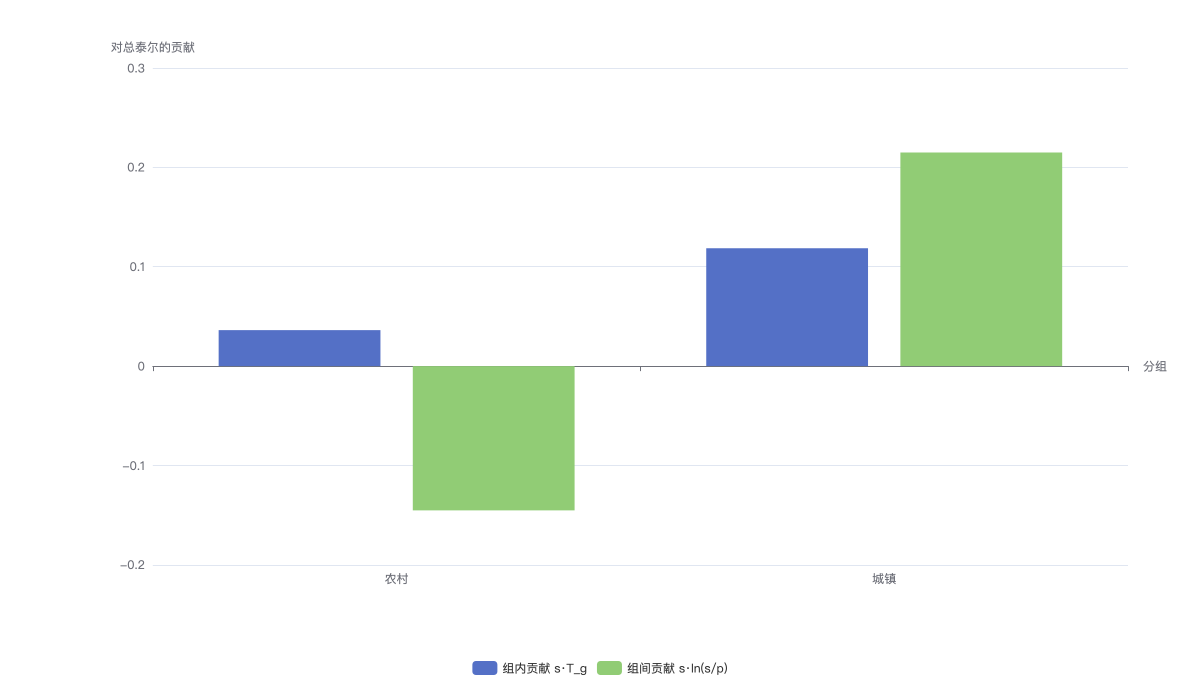
上图为洛伦兹曲线:横轴按取值升序的累计人口占比、纵轴累计财富占比,曲线越远离对角线越不平等;下图并列展示每组的组内贡献与组间贡献,二者跨组分别加总即为 T_组内 与 T_组间。下图可用切换器在「柱状图 / 条形图 / 表格」之间切换。