
过程能力分析
这个方法是做什么的
把过程的实际分布与工程规格限比一比,回答“这条线做出来的东西合不合格、还差多少”。你在控件里填规格下限 LSL、规格上限 USL(可选填目标值 T),模块给出四个能力指数:Cp=(USL−LSL)/(6σ)只看波动、Cpk=min(CPU,CPL)同时看波动与中心偏移、Pp/Ppk 是把 σ 换成另一个口径后的同名指标。填了目标值还会多给一个 Taguchi 指数 Cpm,它同时惩罚波动与偏离目标值(该指数没有简明的区间闭式,表里不给 CI)。
Cp/Cpk 与 Pp/Ppk 的差别只在 σ 用哪一个口径,不在时间跨度。 前者用组内(短期)标准差——有子组列时取合并组内标准差并按 c₄ 无偏化,只含过程固有波动;后者用整体(长期)标准差——全部观测的样本标准差,把时段间漂移也算了进去。演示数据 σ̂_within=0.0235(ν=100)、σ̂_overall=0.0288(ν=124),比值 1.2248 就是 Cp/Pp。报告还把能力指数翻译成两套可比口径:卡④给双侧超规概率合成的 Z_bench 与 PPM,并把观测到的超规件数与正态模型的预期数做精确二项检验,直接校验“用正态模型外推 PPM 到底可不可信”。卡①则内置了一张控制图判异,专门回答本文最要紧的那个前提:过程受控了吗。
需要准备什么数据
- 测量值:1 个,定量变量(数值)
- 子组编号(可选)(可选):0~1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 10%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「子组编号(可选)」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 有明确的双侧规格(图纸公差、药典限度、客户规格书),要给出 Cp/Cpk 或 Pp/Ppk
- 客户或体系审核要求提交能力研究报告,需要指数、置信区间、PPM 与西格玛水平一整套
- 已经用控制图确认过程受控,下一步评估“稳定之后的实力够不够”
- 想量化改进空间:报告会直接算出“中心对准后 Cpk 能到多少”“要达到 Cpk=1.33 需把 σ 压到多少”
前提:必须填 LSL 与 USL 且 LSL<USL;每行是一次测量并已按采集先后排列(行序即时序);个体值近似正态——这是把指数换算成 PPM 与西格玛水平的直接依据;过程需处于统计受控状态。数据要求把行数下限定在 30,少于 30 行会被前置校验拦下(AIAG 能力研究的通行要求是 ≥25 个子组或 ≥100 个个体值)。若使用子组列,每个子组至少 2 个观测才能估出组内标准差。
什么时候不要用它
- 还没确认过程受控:这是最常见也最严重的误用,见下文第一条。先用「X-bar/R 控制图」(有子组)或「单值-移动极差(I-MR)控制图」(单值)把稳定性判掉。
- 没有规格限,只想看过程稳不稳:能力指数无从谈起,用「X-bar/R 控制图」「X-bar/S 控制图」或「单值-移动极差(I-MR)控制图」。
- 数据明显偏态或厚尾:同一个 Cpk 对应的真实不合格率可能差一个数量级,先用「数据变换(Box-Cox/Yeo-Johnson)」把它拉正态再回来;确认形态用「正态性分析」。
- 质量特性本身是寿命数据(右偏、常有删失):正态模型不适用,用「Weibull可靠性(寿命分布)」按分位数口径给出可靠度与 B 寿命。
- 数据是合格/不合格的计数:没有连续分布可言,用「P 图」或「np 图」监控不合格率,它们的卡④也给 DPMO 与西格玛水平。
- 能力差是因为量具不准而不是过程不行:先做「量具GageR&R(测量系统分析)」,测量系统的波动会原封不动地计入 σ、把 Cpk 压低;只想描述分布的位置与离散则用「描述性统计」,不必填规格限。
容易误读的地方
- 过程不受控时算出来的能力指数没有意义——这条没有例外。 能力指数是把当前分布外推到未来的预测量;过程若还受特殊原因支配,“当前分布”本身就不稳定,外推的对象根本不存在。演示数据正是这种情形:卡①内置的 Xbar-R 判定检出 2 个超限点、过程未受控,报告照样算出了 Cp=1.417、Cpk=1.275,同时在卡⑤写明“此时能力指数只描述观测期的历史表现,不能外推为未来能力”。数字能算出来不等于能引用。 正确顺序永远是先控制图判稳、消除特殊原因、再评估能力。
- 判读要看置信区间下限,不是点估计。 卡②的表注写明了这条口径。演示数据 Cpk=1.275 的 95%CI 是 [1.089, 1.461],点估计离 1.33 不远,但下限只有 1.089——按下限判,这个过程还谈不上“能力充分”。样本量越小区间越宽,只报点估计会系统性高估能力。
- 自相关会让 Cp/Cpk 系统性偏高,方向是固定的。 演示数据一阶自相关 r₁=0.2865、Ljung-Box p=0.001 显著,卡①的结论文案直接指出后果:相邻观测彼此相关会压低组内波动的估计,σ_within 偏小,于是 Cp/Cpk 被高估。看到自相关显著还照抄 Cpk,等于把一个偏乐观的数字报了出去。
- 观测超规数与模型预期“无显著差异”不能读成“正态模型是对的”。 演示数据实际 0/125 件超规,整体口径模型预期 0.120 件,精确二项检验 p=1.000。卡④的表注专门提醒:样本量较小时该检验的功效很低,不显著只说明现有数据无法否定它。要在 125 个样本里发现 961 ppm 这个量级的偏差,本来就不可能。这个检验能证伪、不能证实。
- Cpk=Cp·(1−k) 这个恒等式告诉你改进该往哪走。 k 是中心偏离规格中心的相对程度,Cp 只由波动决定,两条路径彼此独立。演示数据 k=0.0999、Cp=1.417、Cpk=1.275:把均值从 50.0100 挪到规格中心 50.0000,Cpk 最高只能到 1.417;要达到 1.33,即使不动中心,也只需把 σ_within 从 0.0235 压到 0.0226(约 4.1%)。先看 k 大不大,再决定是调中心(便宜)还是降波动(贵)。
- 西格玛水平里的 1.5 是行业约定,不是本数据算出来的。 卡④给的“西格玛水平 4.602”= 整体 Z_bench 3.102 加 1.5。表注写明这个 1.5 是六西格玛领域约定的长期漂移经验值。引用时必须注明口径,否则读者会以为 4.6σ 是实测结果。另需注意 Z_bench 与 Cpk 的关系是 Z_bench≤3·Cpk,只有在单侧超规概率可忽略时两者才近似相等。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:过程能力指数与置信区间(主结果)
- 输出结果三:过程分布可视化
- 输出结果四:西格玛水平、PPM 与事后分析
- 输出结果五:结论与解读
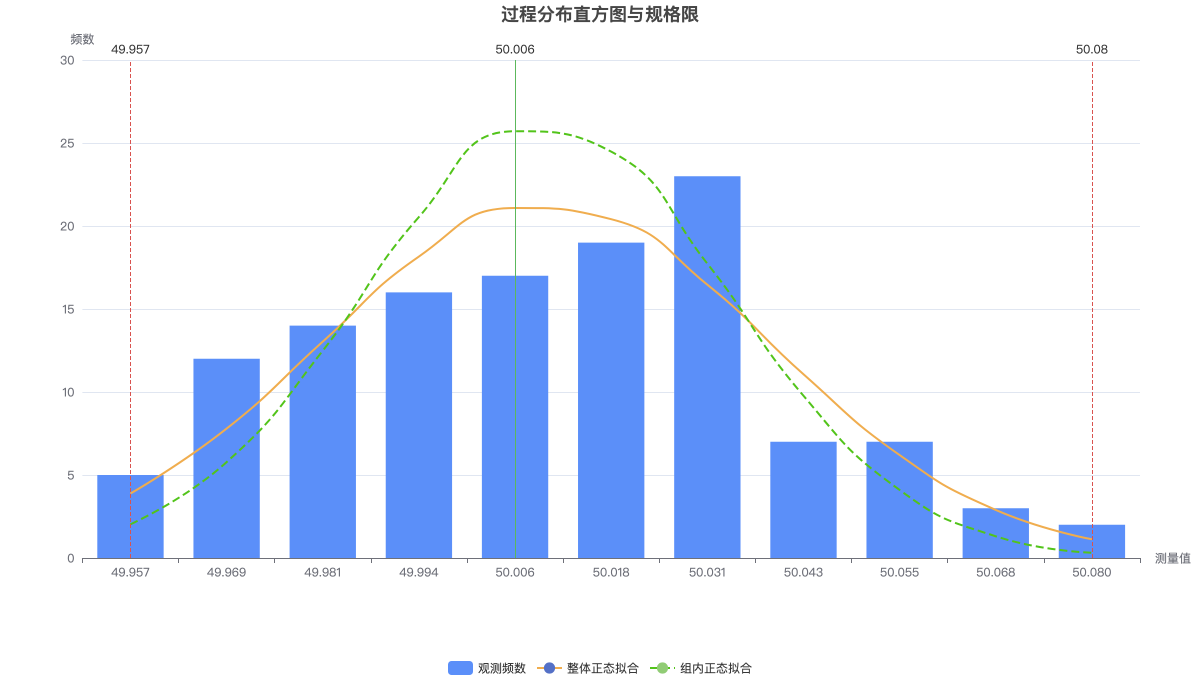
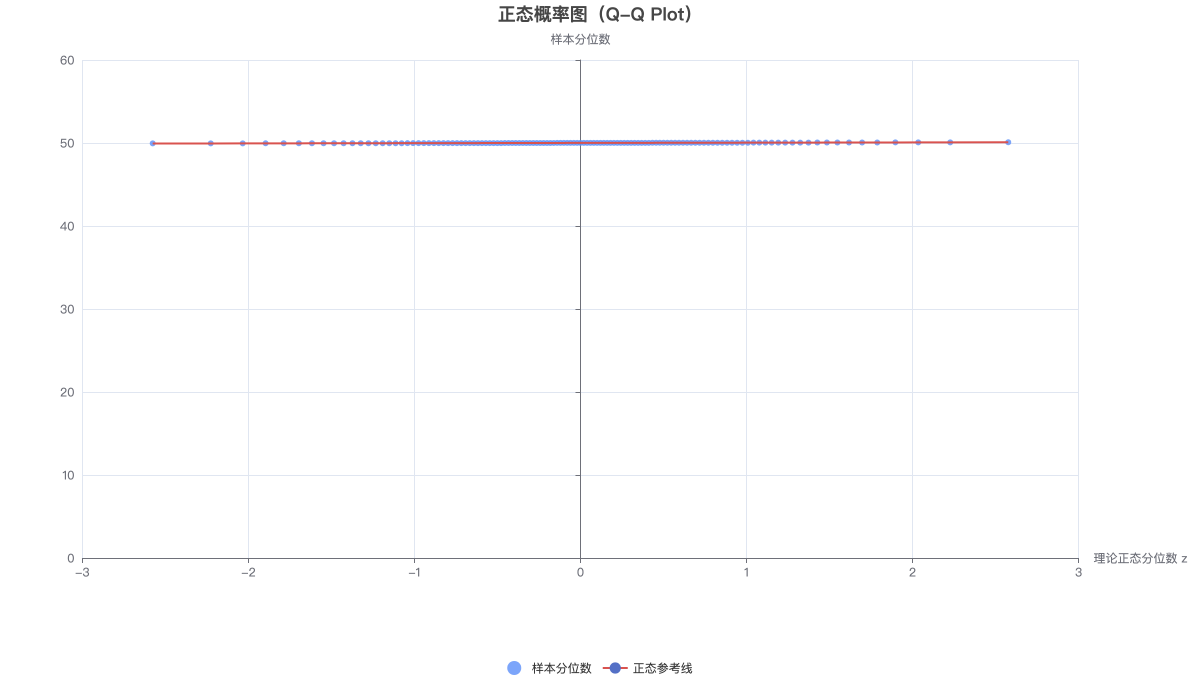
上图为测量值直方图,红色虚线为规格上下限、深色实线为过程均值、绿色实线为目标值;橙色曲线是按整体 σ 的正态拟合,绿色虚线是按组内 σ 的正态拟合,两条曲线的宽窄差异直观反映时段间漂移的大小。下图为正态概率图:点列越贴近红色参考线,正态假设越成立。两图均可用右上角切换器在图/表之间切换。