
Cox比例风险回归
这个方法是做什么的
生存资料上的多因素回归。它是半参数模型:用偏似然把“基线风险函数长什么样”整个消掉,只估各协变量的相对效应——风险比 HR = exp(β)。HR>1 是危险因素、<1 是保护因素,95% 置信区间不含 1 与 p<0.05 完全等价。正因为不设定基线分布,它既不要求生存时间服从指数或威布尔分布,也不要求正态或方差齐;换来的核心前提是比例风险(PH)假定——各协变量的 HR 不随时间变化。
除了系数与 HR,报告给出模型整体的似然比检验、一致性指数 C-index(生存资料下的 AUC 推广)、似然比 R² 与 Nagelkerke R²、每参数事件数 EPV、各列 VIF,以及逐变量的 Schoenfeld 残差 PH 检验(同时给未校正 p 与 Holm 校正 p)。第三张卡画调整后的预测生存曲线,第四张卡给 HR 森林图与 Holm 校正后的结论。除协变量外还有两个可选拖拽区:“绘图分组变量”只影响卡③画哪几条曲线,“分层变量”则允许各层拥有各自的基线风险——某变量违背 PH 时就把它放这里。
需要准备什么数据
- 放入[定量]生存时间 T:1 个,定量变量(数值)
- 放入[定类]结局事件 E:1 个,定类变量(分组/标签)
- 放入协变量 (可选)(可选):定量或定类变量
- 放入[定类]绘图分组变量 (可选)(可选):定类变量(分组/标签)
- 放入[定类]分层变量 (可选)(可选):定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]结局事件 E」必须正好是 2 个类别。
- 「放入[定类]绘图分组变量 (可选)」的类别数需在 2~10 之间。
- 「放入[定类]分层变量 (可选)」的类别数需在 2~10 之间。
- 「放入[定类]绘图分组变量 (可选)」的每一组至少 5 个样本。
- 「放入[定类]分层变量 (可选)」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 比较治疗效果的同时调整年龄、分期、基线指标等混杂因素
- 想知道某个连续指标每升高一个单位,事件的瞬时风险变化多少
- 已用「Kaplan-Meier生存分析」看到组间差异,需要给出调整后的 HR
- 某个变量的效应随时间变化,想让它只作分层、不估它自己的系数
数据要求:至少 30 行,随访时间为正的定量列,结局严格取 0/1(1=事件,0=删失),缺失比例不超过 20%,且不允许常数列。经验准则是事件数至少为待估参数个数的 10 倍(示例 EPV=122/4=30.5),否则系数与置信区间不稳定。分类协变量会自动哑变量化,因此待估参数个数常多于协变量个数。
什么时候不要用它
- 结局只有“发生 / 不发生”、没有时间维度:用「逻辑回归」,它还能给 ROC 与 AUC。
- 存在竞争事件(研究肿瘤特异死亡时的其他原因死亡):本模块把竞争事件当删失,会高估主要事件的累积发生率,改用「竞争风险模型」。
- 只有一个分组变量,你要的是生存曲线与中位生存时间:用「Kaplan-Meier生存分析」,它直接给中位数及其置信区间。
- 数据是配对或精细分层的病例对照:匹配因素必须被条件化掉,用「条件逻辑回归」。
- 比例风险明显不成立(曲线交叉),而你只有一个分组变量:一个恒定的 HR 会把前后相反的差异抹平,改用「Kaplan-Meier生存分析」,它的 RMST 差值不依赖比例风险假定。
- 只拿得到按固定时间区间汇总的随访资料:Cox 需要个体级的事件时点,改用「寿命表」。
容易误读的地方
- PH 假定的“违背 / 满足”判定读的是未校正 p,而同一张表里还有一列 Holm 校正 p。 示例中“肿瘤分期_I期”的未校正 p=0.028、Holm 校正后 p=0.113,判定栏写的是“违背 PH 假定”,卡①的结论文案也据此建议把它改放分层变量区。协变量一多,按未校正 p 判会偏向于报“违背”;反过来,PH 检验不显著也不等于比例风险成立——样本小的时候它几乎检不出任何时间趋势。定论前把卡③的曲线是否交叉一并看过。
- 参照类不是你选的,是按类别名排序自动定的。 示例的“肿瘤分期”有 I 期、II 期、III 期三类,系数表里只出现“肿瘤分期_II期”与“肿瘤分期_I期”两行——被丢掉的 III 期就是参照。所有 HR 都是相对它而言,报告时必须点名参照类是谁,否则读者无从还原。
- 连续协变量的 HR 是“每增加 1 个原始单位”,换个单位数字就变。 示例年龄 HR=1.036,即每长一岁风险升高 3.6%;若把年龄换算成“天”,同一个效应会变成一个几乎等于 1 的数,看上去像没有影响。卡④的结论文案自己也提示改用每 10 岁或每 1 个标准差重新表述。
- C-index 与两个伪 R² 都是训练集回代的结果,且伪 R² 不表示“解释了多少方差”。 示例 C-index=0.6949,卡④直接判“区分度一般,预测价值有限”;似然比 R²=0.200、Nagelkerke=0.201,它们衡量的是偏似然的改善程度,只宜在同一份数据上比较不同模型,拿线性回归 R² 的标准去读会得出完全错误的结论。本模块没有做交叉验证或外部验证,真要当预测模型用必须另做。
- HR 是相对效应,同样的 HR 在低危人群里带来的绝对获益小得多。 卡⑤的结论文案专门提醒这一点:要谈绝对风险,得回到卡③的预测生存曲线上读某个时点的生存率,而不是用 HR 反推。另外观察性研究里即使调整了协变量,仍可能存在未测量混杂,“显著”不等于“因果”。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:模型检验与回归系数主结果表
- 输出结果三:可视化(预测生存函数曲线)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
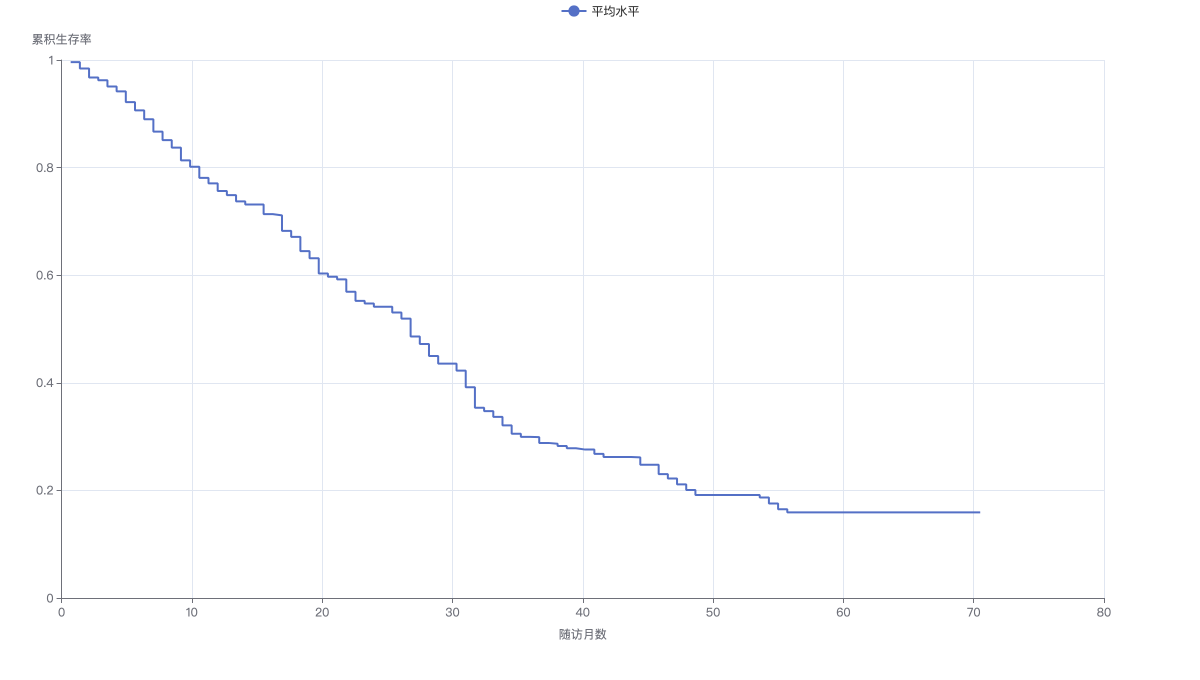
上图展示了在所有协变量处于平均水平时,研究对象的总体预测生存函数曲线。它反映了随时间推移,平均生存概率的变化趋势。
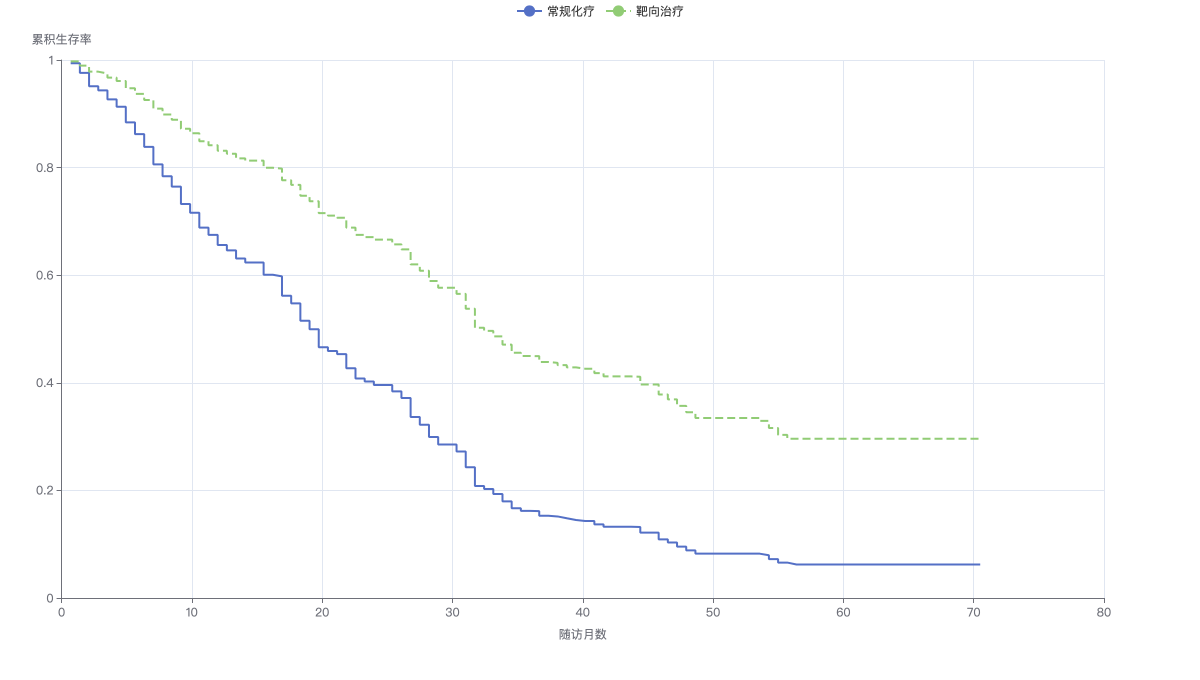
上图在控制了模型中其他协变量后,根据变量'治疗方案'的不同水平,分别绘制了预测的生存曲线。
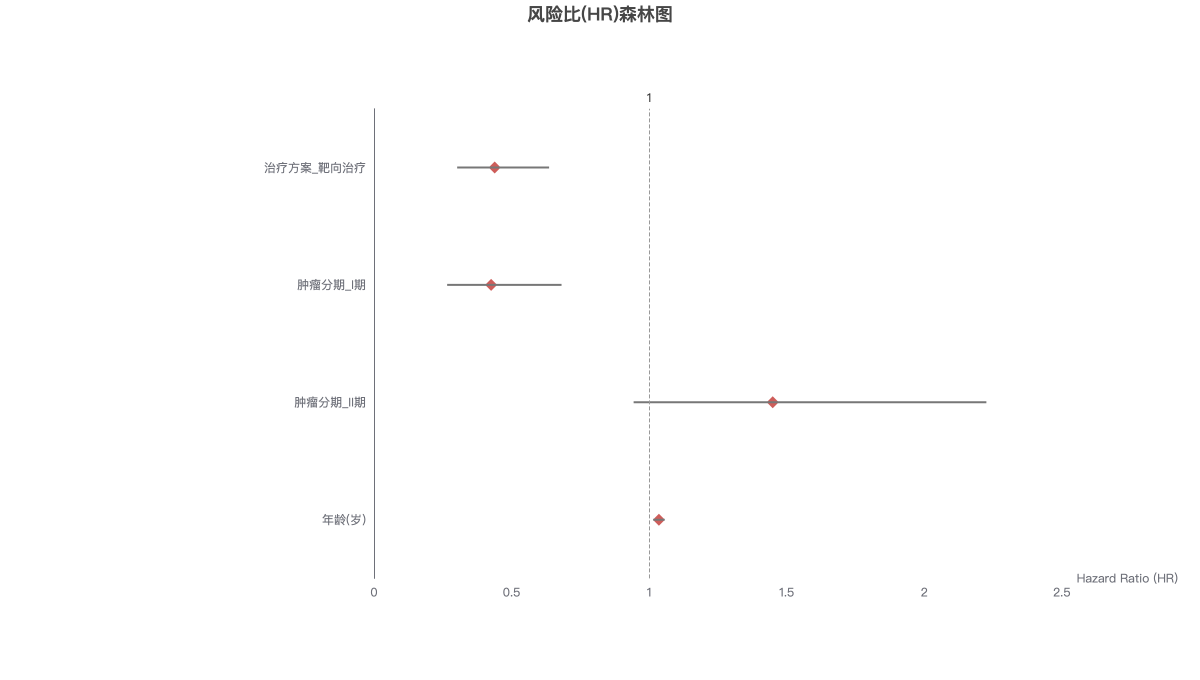
森林图与上表同源(点估计与区间自上而下复用,未重算);竖直虚线 HR=1 为无效参考线,置信区间跨过它即不显著。