
Pearson卡方检验
这个方法是做什么的
把两个分类变量交叉成一张 r×c 列联表,逐格比较实际人数与“假如两个变量毫不相干时本该有的人数”(期望频数 E = 行合计 × 列合计 / N)。差得越离谱,χ² 越大。它回答的只有一个问题:这两列是不是相互独立。
关联有多强、来自哪一格,报告分开回答。主结果表在 Pearson χ² 之外并列似然比 G²(示例 χ²(2)=17.523 与 G²(2)=18.182,同自由度、渐近等价,两者结论不一致就是样本偏小的信号)与线性趋势检验 M²——M² 只在两个变量的类别标签都能被解析成有序数值时才真的算,文字标签时这一行的统计量与 p 留空,并注明“按名义变量处理,不做趋势检验”。第四张卡用 Cramér's V(附非中心卡方反演的 95%CI)、Cohen's w、列联系数与 Goodman-Kruskal λ 回答强度,用逐格 Haberman 调整标准化残差+Bonferroni 校正 p 回答来源。另有一个可选的权重拖拽区,用来喂已经汇总好的频数列。
需要准备什么数据
- 行变量 (X):1 个,定类变量(分组/标签)
- 列变量 (Y):1 个,定类变量(分组/标签)
- 权重 (可选)(可选):定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 「行变量 (X)」的类别数需在 2~15 之间。
- 「列变量 (Y)」的类别数需在 2~15 之间。
- 「行变量 (X)」的每一组至少 5 个样本。
- 「列变量 (Y)」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 吸烟状况 × 疾病严重程度这类暴露与分级结局的关联
- 治疗方案 × 疗效是否达标
- 病理分型 × 是否发生转移
- 问卷里两道选择题的交叉分析
要求每个个体只落进一个格子、观测之间互相独立。规模上,行列变量各需 2~15 个类别、每个类别至少 5 条记录、总行数不少于 20;期望频数是否达标由第一张卡按 Cochran 判据逐格给出。有一条容易踩空的边界:权重区救不了小的汇总表——把一张 2×3 汇总表(6 行数据加一列频数)拖进来,实测被“当前数据表共 6 行,少于Pearson卡方检验所需的至少 20 行”直接挡在门外,各类别还会另外报“仅有 2 个有效观测”。权重区只有在表格本身行数已经够多时才用得上,常规做法仍是上传逐例数据。
什么时候不要用它
- 同一批对象被测了两次(治疗前后是否达标、两种试剂对同一批标本):这是配对资料,独立性前提不成立,用「配对卡方检验」。
- 2×2 表且期望频数偏小:用「Yates校正卡方检验」取更保守的 p,或直接用不依赖大样本近似的「Fisher精确检验」;也可以先把语义相近的低频类别合并。
- 已知有需要控制的混杂因素(年龄、病情基线):直接做二维卡方会被辛普森悖论扭曲,用「分层卡方分析」在每层内部比较后再合并。
- 结局是有序等级、你要问的是“哪一组结局更好”而不是“是否独立”:卡方把等级当成无序标签,会丢掉全部顺序信息,用「Ridit分析」。
- 格子里填的是均值、金额或比例而不是人数:χ² 会随你选的分母尺度任意放大缩小。比较平均水平两组用「独立样本T检验」、三组及以上用「单因素方差分析」;只想描述构成比不做检验,用「列联(交叉)分析」。
- 只有一个分类变量、要对照某个理论比例:用「卡方拟合优度检验」。
容易误读的地方
- χ² 的大小不能当关联强度用。 百分比结构完全不变、样本量翻十倍,χ² 也大致翻十倍,p 随之变小,可两个变量的关联一点没变强。要说强度只能看第四张卡的 Cramér's V,示例是 0.242,95%CI[0.119, 0.349],按 Cohen(1988) 属弱关联。
- 整体显著不代表每一格都偏离,更不是“列百分比最高的那一格”。 示例 6 个格子里,Bonferroni 校正后只有“重度 × 吸烟”(O=49、E=34.10、调整残差 +4.16)与“重度 × 不吸烟”(O=17、E=31.90、残差 −4.16)仍显著;而列百分比最高的一格是“中度 × 不吸烟”的 53.79%,它的实际 78 与期望 70.57 几乎没差,残差只有 1.72、校正 p=0.515。指着百分比最高的格子说“就是它造成了关联”,恰好指错。
- Goodman-Kruskal λ = 0.000 不等于“没有关联”。 示例里 λ 正好是 0,而同一份报告的 p 小于 0.001。λ 问的是另一件事:知道 X 之后,用众数去猜 Y 能少错多少。本例吸烟与不吸烟两列的最大类别都是“中度”,和总体的最大类别一样,所以猜法一点没变、λ 恒为 0。它是预测口径的指标,不能拿来否定 Cramér's V。
- 两个变量都有序时,只看 Pearson χ² 会白白损失效能。 趋势检验 M² 的自由度是 1,把“关联沿等级单调变化”这一个方向集中检验,比自由度更大的整体 χ² 更灵敏。示例把“轻/中/重”编成 1/2/3、吸烟状况编成 1/2 之后,M²(1)=13.102、p<0.001 出现了,而 Pearson χ² 仍是 17.523 一点不变——是标签的形态决定了这一行算不算,不是数据变了。
- 期望频数的条件是对期望频数说的,不是对实际频数。 某格实际只有 2 个人不一定违规,要看那一格的期望是多少;反过来实际人数不算少而期望很小的情况也存在。第一张卡逐格列出期望频数,照着核对即可。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Pearson 卡方检验主结果表
- 输出结果三:列联表交叉可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
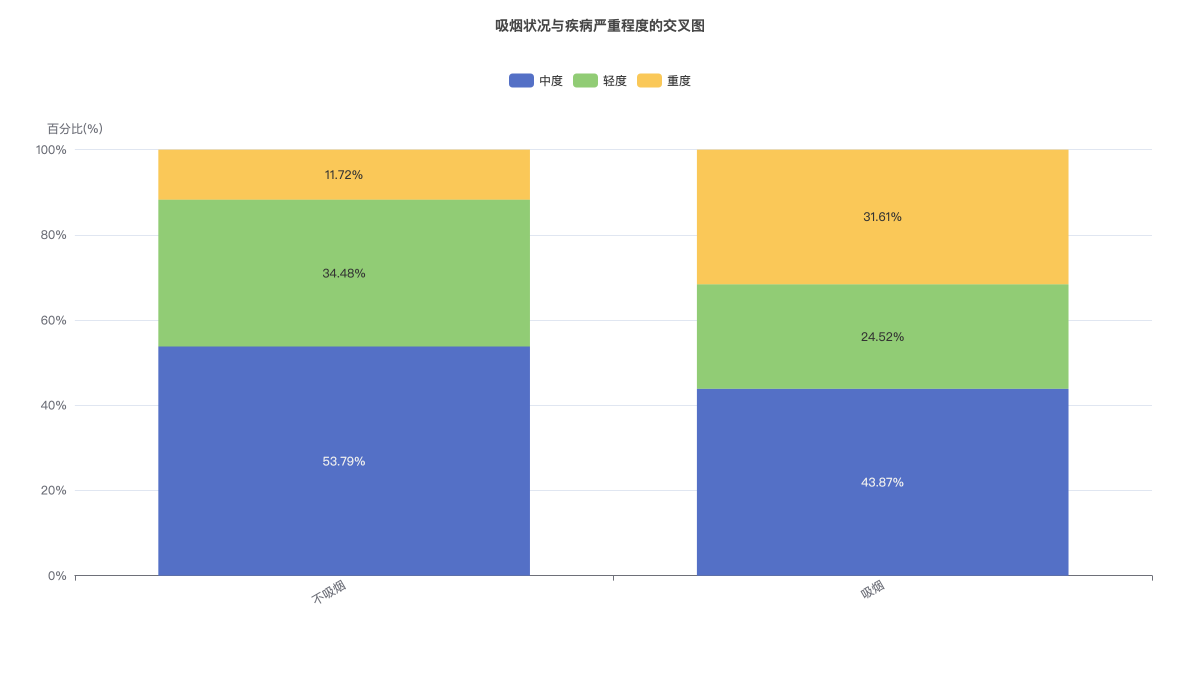
您可以通过图表上方的下拉框切换图表类型和核心指标。'列百分比'有助于理解自变量各类别内部的因变量构成,而'行百分比'则有助于理解因变量各类别在自变量上的来源分布。此外可用右上角的视图切换器在「柱状图 / 条形图 / 折线图 / 表格」之间互切,表格视图给出各列的构成比数值。