
RFM客户价值分层
这个方法是做什么的
把客户按三个交易行为维度分层:R(最近一次消费距今天数,越小越近)、F(消费频次)、M(消费金额)。本模块的切法是固定的,先看清楚再用:三个维度各按五分位赋 1–5 分(R 反向计分,越近分越高),再以各维度的平均分为界把每个维度二分成“高/低”,三个高低组合成 8 类客户分群——重要价值、重要保持、重要发展、重要挽留,以及对应的四个“一般”类。也就是说这是等频分箱加均值切分,不是等距,也不是业务自定义阈值。
报告给 8 类分群的客户数、占比、平均 R/F/M、平均 M 的 95%CI、平均 RFM 总分,以及金额贡献占比——这一列往往比人数占比更该指导预算。之后是可检验的部分:分群分布是否偏离均匀的 χ² 与 Cramér's V;分群间消费金额差异的 Kruskal-Wallis 检验与 ε²(金额通常极度右偏,所以用非参数而非方差分析);Mann-Whitney U 加 Bonferroni 的分群两两比较;还有客户价值集中度——前 10%/20%/30%/50% 客户的累计金额贡献与 Gini 系数。卡① 先查客户数、每个维度的唯一取值数够不够切五档,以及 R/F/M 三维之间的 Spearman 相关。
需要准备什么数据
- 放入[定量]最近一次消费 R:不限
- 放入[定量]消费频次 F:不限
- 放入[定量]消费金额 M:不限
- 放入[可选]客户ID(可选):不限
数据要求
- 数据表至少 100 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 会员运营前的客户盘点:谁该重点维护、谁该召回、谁已在流失边缘
- 营销预算分配:按金额贡献而不是按人头去投放
- 想量化“多少客户贡献了多少收入”,用帕累托与 Gini 说话
- 已经把每行整理成一个客户、带 R/F/M 三列的汇总数据
前提:R/F/M 必须是三个不同的定量列、来自同一批客户按行对应。R 要求是“距今天数”,如果你的字段是“最近消费日期”得先换算成天数,直接拖日期进去方向会反。客户数建议 ≥100——五分位要把客户切成 5 段,样本太少时分箱边界会随个别客户漂移;某个维度的唯一取值数少于 5(比如频次只有 1、2、3 三种)时切不出真正的五档,卡① 会逐维度报这一项。数据不少于 100 行。
什么时候不要用它
- 数据是订单明细,一个客户占很多行:模块把每一行当作一个客户处理,直接跑出来的分层是错的。先用「分类汇总」按客户 ID 把 R/F/M 聚合成客户级一行一人,再回来跑。
- 想让数据自己决定分几群、群界在哪,而不是套这套固定的高/低规则:RFM 的边界是人为设定的,不是从数据结构里学出来的。要按 R/F/M 的自然聚集分群用「聚类分析(K-Means)」或「二阶聚类」。
- 想预测某个客户未来会不会流失、会不会响应活动:RFM 是描述性分层,不做预测。二分类结果用「逻辑回归」或「随机森林分类」,关心“还能留多久、什么时候流失”则用「Kaplan-Meier生存分析」或「Cox比例风险回归」。
- 只有两个维度可用(比如拿不到频次):8 类分群依赖三维的高低组合,缺一维就退化。两个变量之间的关系与分组用「列联(交叉)分析」,单维度分档看分布用「频数分析」。
- R/F/M 之间高度相关(卡① 报出 |ρ| 很大):8 类会退化成少数几类,分层失去意义。此时改用「聚类分析(K-Means)」,或只保留两个维度用「列联(交叉)分析」交叉看;只想看金额分布有多集中,用「基尼系数与洛伦兹曲线」。
容易误读的地方
- 分层阈值是切出来的,不是数据里本来就有的界线。 本模块用等频的五分位赋分,再以各维度平均分为界二分高低(示例的界线是 R 分 ≥3.00、F 分 ≥3.04、M 分 ≥3.00)。等频意味着无论你的客户实际有多优质,永远大约有两成落在最低档、两成落在最高档。换成等距切分(按金额区间平均分段)或业务自定义阈值(“年消费满 5000 算高价值”),同一批客户会得到完全不同的分层。所以“重要价值客户占 22%”说的是这批客户内部的相对位置,不是一个绝对标准,更不是行业基准。
- 换一批客户,标签会跟着动。 分箱边界与高低界线都由当前样本算出来,卡⑤ 的研究局限逐字写着:分群标签不具备跨数据集的绝对可比性。这有两个直接后果:不能拿上季度的分层结果和本季度对比说“重要价值客户少了 3 个百分点”——边界本身已经变了;也不能把 A 门店的分层标准套到 B 门店。要做跨期或跨门店比较,必须先固定一套业务阈值,而不是每期重跑五分位。
- “重要”类金额高于“一般”类是构造性结果,不是发现。 分群本身就按 M 的分位数定义,“重要”即 M 分高于平均。所以卡④ 里那些跨越重要/一般的显著差异(28 组中 20 组显著、ε²=0.782)没有信息量,卡④ 的结论文案自己就点破了这一点。真正值得看的是同为“重要”的四类之间、或同为“一般”的四类之间在金额上是否也有差异——那才不是定义带来的。
- RFM 描述过去,不预测响应。 卡① 与卡⑤ 都明确声明:分到重要价值客户只说明历史行为好,不代表对营销刺激的响应率更高。一个每月都来的高价值客户很可能不发券也会来,对他投券的增量收益甚至可能是负的。要知道谁会因为营销而改变行为,需要对照实验或提升度建模,RFM 本身给不出这个答案。
- 人数占比和金额贡献占比是两条完全不同的线。 示例里人数最多的是“一般挽留客户”(87 人、29.00%),而 66 人(22.00%)的重要价值客户贡献了 39.29% 的金额。按人头分预算,钱会花在贡献最小的那群人身上。但反方向的误读同样常见:卡④ 的集中度表显示前 20% 客户只贡献 41.57%,判定写的是“集中度低于二八法则”,Gini 只有 0.3574——这批数据里前 50% 的客户才贡献 75%,硬套二八法则去砍长尾会砍掉真正的大头。集中度要看这张表,不要看经验法则。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:8 类客户分群分布、画像与均匀性检验
- 输出结果三:可视化(分群规模与画像)
- 输出结果四:效应量、集中度与事后多重比较
- 输出结果五:结论与学术表述
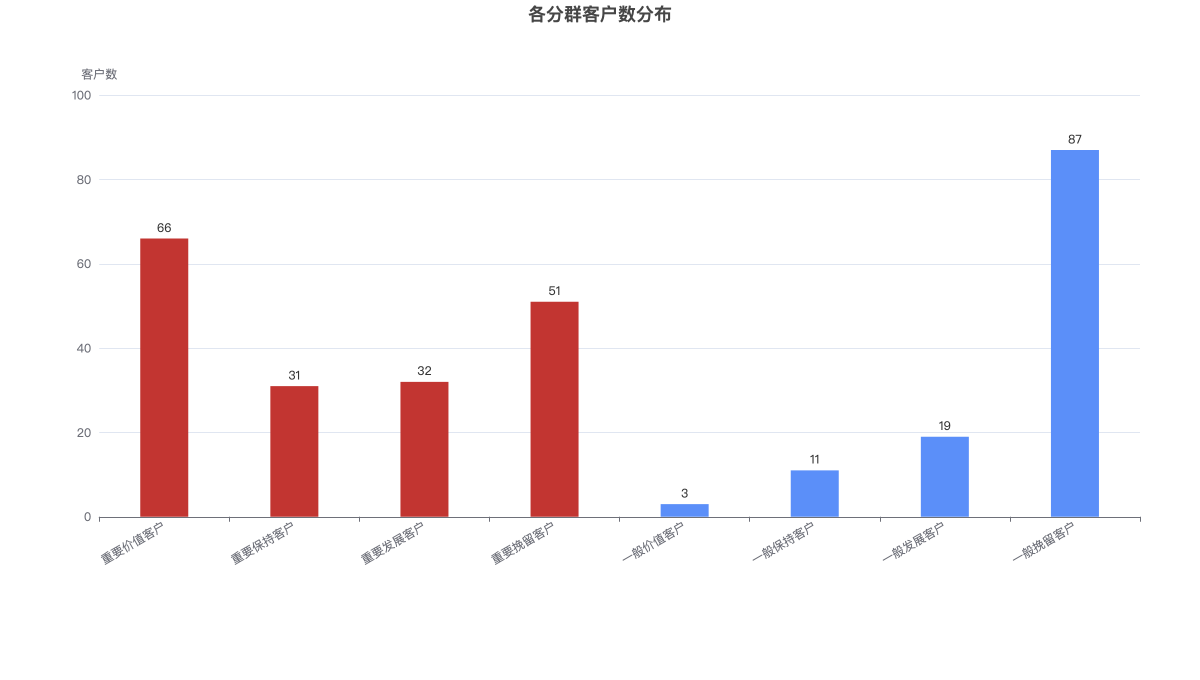
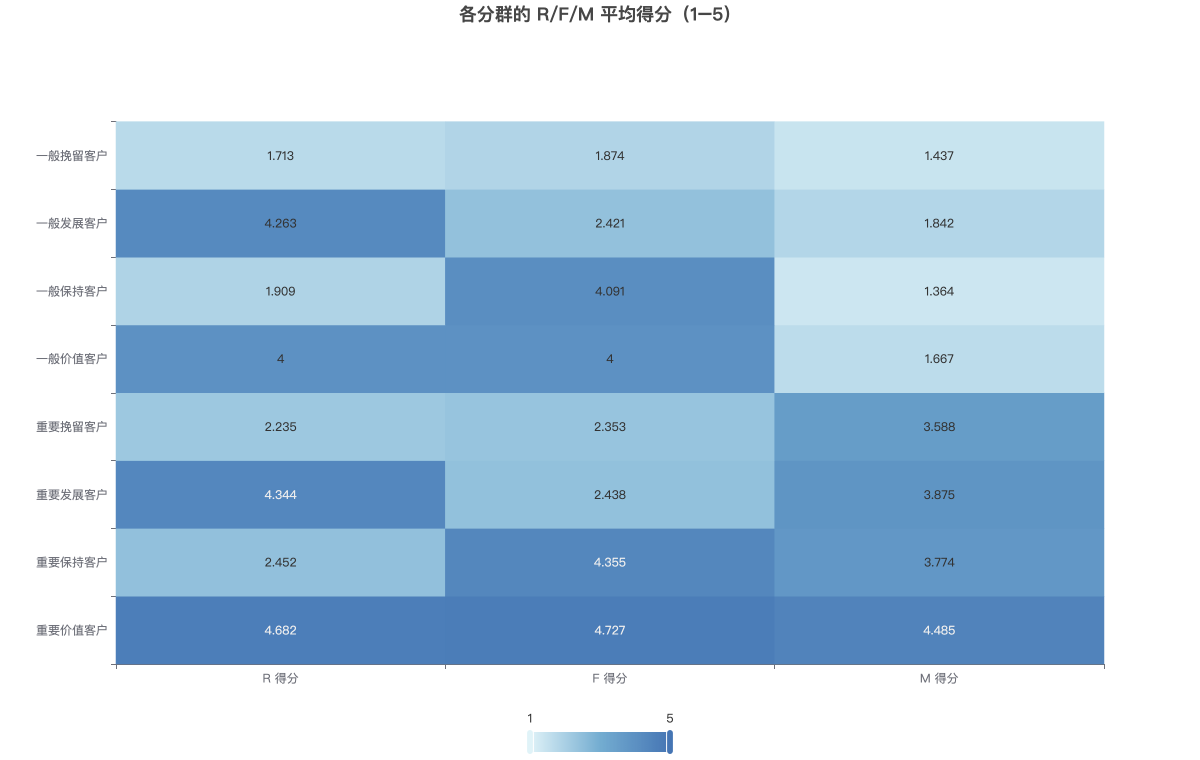
上图为各分群客户数(红=「重要」类即高金额,蓝=「一般」类;可切饼图看占比结构),下图为各分群的 R/F/M 平均得分热力图。