
QUEST决策树
这个方法是做什么的
QUEST 存在的理由只有一条:把“选哪个变量分裂”和“在这个变量上切哪里”拆成两步。C&RT 是把两件事一起做的——遍历所有变量的所有切点,谁切得最好选谁;后果是候选切点越多的变量(取值多的定量变量、水平多的定类变量)机会越多,天然占便宜,哪怕它和目标没什么关系。QUEST 先只做变量选择:定量自变量用单因素方差分析 F 检验、定类自变量用 χ² 检验,谁与目标的关联最强选谁;选定之后才在这个变量上找切分点——定量变量在原始尺度上遍历阈值取加权 Gini 最小者(不分箱),定类变量找最优的类别二分。它始终做二叉分裂,目标变量必须是定类。
报告共六张卡,与 CHAID 家族同构,但卡⑤ 表9 的两列要单独学。“分裂统计量”在这里是二分后的加权 Gini 不纯度,越小越好,与 CHAID 同名列(Pearson χ²,越大越好)方向相反,也不能跨模块横比数值;“分裂 p”来自变量选择那一步,表注逐字写着“这些 p 值未做多重比较校正”——CHAID 那边至少有 Kass Bonferroni,这里一层都没有。分支条件因此是“≤ 6.6000 / > 6.6000”这种原始尺度阈值,而不是 CHAID 那样的区间并。
需要准备什么数据
- 放入[定类]目标变量Y:定类变量(分组/标签)
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]目标变量Y」的类别数需在 2~20 之间。
- 「放入[定类]目标变量Y」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 自变量的“候选切点数”差别很大(有的是二值、有的是几十个取值的连续量),担心 C&RT 的选择被这件事带偏
- 要的是定类结果的分层规则,同时希望切点落在原始刻度上、能直接说出“门店面积 > 172.5500 平米”
- 希望树是二叉的:每个节点只有“是 / 否”两条路,便于画成流程图或做成问卷式分诊
- 想要每个分裂带一个关联强度的 p,作为“这一层为什么这么切”的交代
- 变量不多、样本中等,需要一个比 C&RT 更稳、比穷举 CHAID 更快的折中(同一份数据端点耗时 0.59 秒,穷举 CHAID 要 35.76 秒)
前提:目标变量必须是定类(2~20 类)、每类至少 2 条记录,至少 20 条完整记录,禁止常数列,目标变量不得同时出现在自变量里,含缺失的整行剔除。另有一条只写在数据要求里、报告不会替你检验:变量选择用的 F 检验以组内正态与方差齐性为近似前提,严重偏态的定量自变量可能被系统性低估,必要时先做变换。
什么时候不要用它
- 目标变量是连续数值:直接报“当前算法要求目标变量为定类变量”。回归树用「C&RT决策树」,要连续因变量的系数用「线性回归 (最小二乘法)」。
- 希望一次分出三支以上:QUEST 只做二叉,把“低 / 中 / 高”并成两支会丢掉中间档的独立性;要多叉分组用「CHAID决策树」。
- 定量自变量严重偏态或组间方差差得很远:F 检验的前提不成立会让它在变量选择阶段被埋没。先用「数据变换(Box-Cox/Yeo-Johnson)」处理,或改用不依赖 F 检验的「CHAID决策树」。
- 要把 p 当成统计推断结论:这里的 p 一层校正都没做。真要检验某个自变量与目标的关联,单独用「Pearson卡方检验」或「单因素方差分析」重做一次。
- 只关心预测精度:单棵树的上限有限,改用「随机森林分类」;自变量多且互相相关时用「LightGBM分类」。
容易误读的地方
- “分裂统计量”这一列在 QUEST 下越小越好,很容易被读反。 演示数据里根节点 0.372、子节点 0.332 / 0.456 / 0.246 / 0.218 / 0.211——它是二分后的加权 Gini,不随深度单调下降,也不能和 CHAID 报告里的 51.121(那是 χ²)比大小。要比较“哪一层切得更干净”,看同一张表的“节点纯度”列。
- p 没有任何多重比较校正,所以同一个 α 下 QUEST 比 CHAID 更容易继续长。 每个节点都在全部自变量上择优、并且逐层重复检验,实际第一类错误率高于名义 0.05。表注对此逐字写明。把显著性阈值从 0.05 往下调(例如 0.01)是这个模块里最直接的剪枝手段,比调深度更贴合它的机制。
- “无偏”只保护了变量选择那一步,切点那一步照样是过拟合的。 选中变量后仍要遍历所有阈值取加权 Gini 最小者,这一步和 C&RT 一样会挑中最迎合训练数据的位置。演示数据里节点10 用“广告投入 ≤ 7.5000”把 11 个样本切成 6 和 5,两片叶纯度 1.0000 和 0.6000——阈值精确到小数点后四位,背后只有 11 个样本。看到很“精确”的阈值,先回表9 看那一支有多少人。
- 调大“最小叶节点样本数”在 QUEST 上的后果和在 CHAID 上不一样。 因为是二叉分裂,任一侧不够就整次分裂直接放弃,不会像 CHAID 那样把小分支并进相邻分支。实测把它从 5 调到 30:树深度从 4 掉到 2、叶节点从 8 个降到 4 个,而表9 表注仍写“本次没有任何分支因样本数不足最小叶节点样本数(30)而被归并”——这句不是没生效,是它压根不走归并那条路。
- “谁在根节点”不是“谁最重要”。 卡③ 图注和卡⑤ 结论都提醒了这一点,值得当真:演示数据里根节点选的是广告投入,卡④ 的置换重要性也确实把它排第一(0.18198),但门店面积(0.08625)与促销折扣力度(0.07956)几乎并列,而根节点只能有一个赢家。删掉少量样本就可能换一个根节点,结论要以卡④ 的重要性区间为准,不要照着树图讲故事。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:交叉验证性能主结果表
- 输出结果三:树结构图与折外预测诊断图
- 输出结果四:判别效能与变量重要性
- 输出结果五:节点明细与叶节点决策规则
- 输出结果六:结论与学术表述
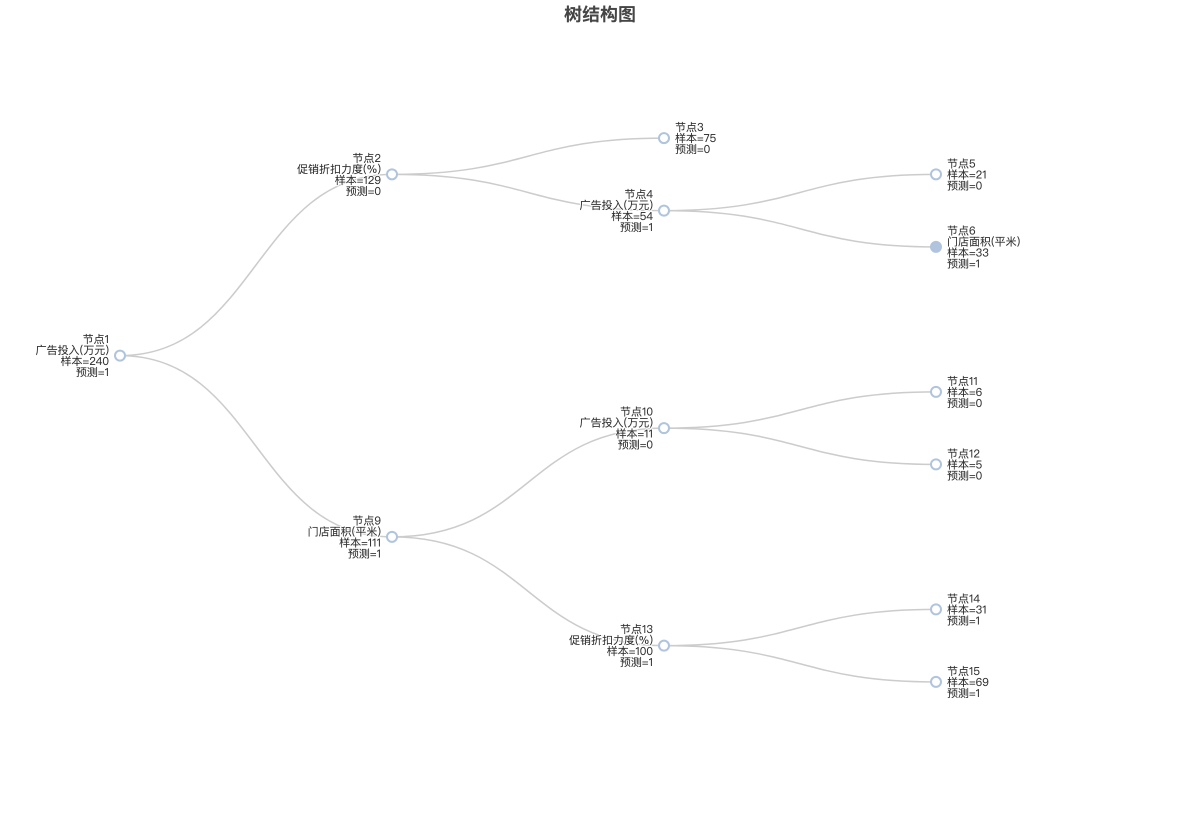
树图自左向右展开:每个节点标注编号、本节点采用的分裂变量、落入该节点的样本数与预测类别;叶节点没有分裂变量。可用右上角切换器切到「表格」查看同一棵树的节点清单。
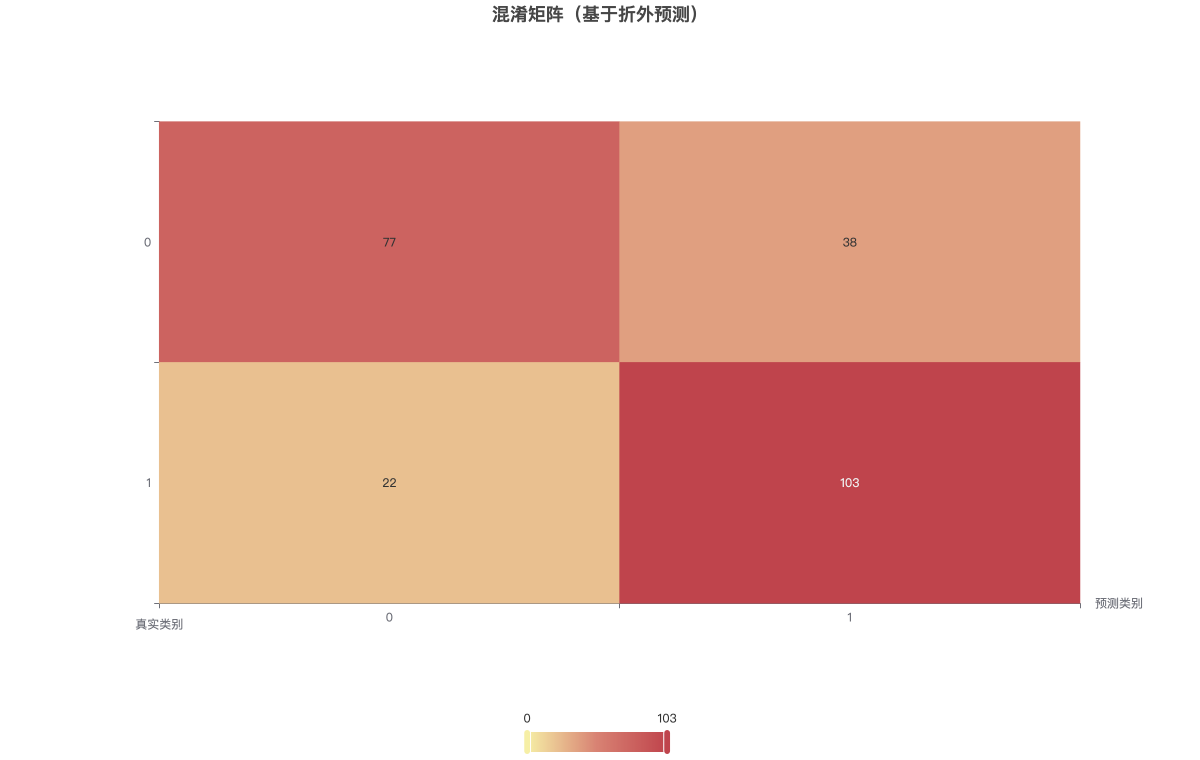
混淆矩阵基于交叉验证的折外预测:行是真实类别、列是预测类别,对角线为预测正确的样本数。
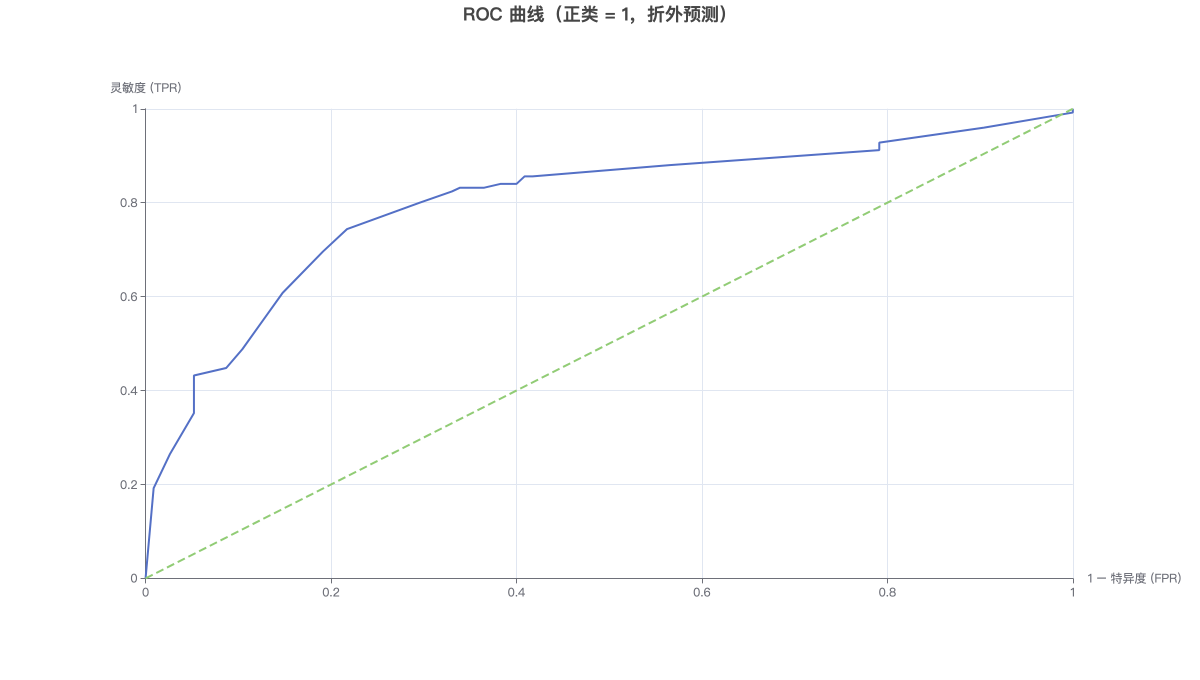
ROC 曲线以「1」为正类,基于折外预测概率绘制;对角虚线为随机猜测参考线,曲线越靠左上判别力越强。