
Bland-Altman法
这个方法是做什么的
回答“两种测量方法能不能互相替代”。做法是对同一批对象的配对测量算出每一对的差异,看两件事:平均差异有多大(系统偏倚),以及单个个体的差异能大到什么程度——后者就是 95% 一致性界限 LoA = 平均差异 ± 1.96×SD。注意它问的不是“两法相不相关”:两法恒定相差 10 个单位时相关系数照样可以是 1,而它们显然不能互换。
顶部的“检验方法”三选一:差值(默认)、比值、差值的百分比,选哪一个会改变整份报告的量纲与统计口径。除偏倚、LoA 以及它们各自的 95% 置信区间外,报告给重复系数 CR、Lin 一致性相关系数 CCC(并拆成精密度 r 与准确度 Cb 两个分量)、组内相关系数 ICC(A,1)、标准化偏倚 Cohen's d_z、按两法均值三分位分层的偏倚检验(带 Holm 校正),以及差值分布直方图。另有一个“不输入最大误差区间”的开关,把它关掉即可填入临床可接受的误差范围,卡⑤会据此直接给出能否互换的结论。
需要准备什么数据
- 放入 [定量] 测量方法1:1 个,定量变量(数值)
- 放入 [定量] 测量方法2:1 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 新仪器、新试剂或新方法与参考方法的比对
- 同一方法两次测量之间的重复性评价
- 人工判读与自动判读的互换性
- 不同采样部位、不同试剂批次之间的可比性
数据要摆成一行一个对象、两列同量纲的配对测量,同一个变量不能同时放进两个区。至少 10 对,但 Bland & Altman(1986) 建议至少 50 对——低于 10 对时 LoA 的置信区间会宽过 LoA 本身,结论无从解释。第一张卡逐条检验三件事:差值近似正态(Shapiro-Wilk)、无比例误差(差值对两法均值的 OLS 回归斜率)、方差齐(|差值−均差| 与均值的 Spearman 相关),它们共同决定 LoA 能不能按名义的 95% 来读。
什么时候不要用它
- 两列是同一批对象干预前后的测量,你要问的是“有没有变化”:那是差异检验不是一致性评价,用「配对样本T检验」;分布明显偏态时用「配对样本Wilcoxon检验」。
- 评价者给的是类别判定而不是连续测量:用「Kappa一致性检验」。
- 有多次重复测量,想把“评价者之间的差异占总变异多少”拆出来:用「组内相关系数(ICC)」。
- 要估两法之间的换算关系(斜率与截距),而不只是差异有多大:两列都带测量误差,用「Deming回归」。
- 只想知道两列相关不相关:用「Pearson相关性分析」——但相关高绝不等于可互换,这正是 Bland-Altman 当年被提出来的理由。
容易误读的地方
- 换一个“检验方法”,量纲和统计口径全变,不能把某一支的读法套到别支。 比值口径不是在比值尺度上取均值±1.96SD,而是按 Bland & Altman(1999) 先对两列取自然对数、在对数尺度上做常规差值分析、再指数回变换:主结果给的是几何均值比 GMR(示例 0.955)与乘性界限 [0.860, 1.060](倍),重复系数变成 exp(1.96×SD_log)=1.110,界限读作“95% 的个体比值落在下限倍到上限倍之间”,而不是“相差多少个单位”。同一份数据在差值口径下给的是 −4.684 与 [−14.283, 4.915](原始单位),差值百分比口径给 −4.611 与 [−15.042, 5.819](%)。三支的校正方式也不同:比值口径存在系统偏倚时要除以 GMR 做乘性标定,不能加减一个常数。
- 前提检验的结论会随口径改变,别拿默认那一支的“满足”给别的口径背书。 实测同一份数据:差值口径下 Shapiro-Wilk p=0.823、Spearman p=0.903,三条全部“满足”;切到比值口径,正态性 p=0.031 判“不满足(LoA 的 95% 覆盖会失真)”、方差齐性 ρ=−0.285、p=0.002 判“不满足”。先定口径,再读卡①。
- 偏倚显著不等于不可互换,偏倚不显著也不等于可互换。 那个 p 值来自“平均差异是否为 0”的单样本 t 检验,样本一大,再小的偏倚也会显著(示例偏倚 −4.684,p<0.001)。能不能互换取决于 LoA 的宽度与你的临床可接受误差。默认状态下“不输入最大误差区间”是打开的,卡⑤的“临床可接受性”一行会写明未设定可接受误差区间、需由专业判断 LoA 宽度是否临床可接受;把开关关掉并填入 [−10, 10] 之后,同一份数据的摘要与卡⑤会直接改口,指出 LoA 超出了你设定的区间、两法不可互换。
- CCC 与 ICC 很高,也不能替代 LoA。 两者都依赖被测对象的异质性——同一对方法放到变异更大的人群里,ICC 会更好看。示例 CCC=0.972 判“良好”、ICC(A,1)=0.972 判“优秀”,而偏倚仍然显著、LoA 宽达 19.197 个单位。卡④的结论文案也明说 ICC 必须与 LoA 一并报告。
- 三分位分层各层都显著,并不说明偏倚随测量量级漂移。 卡④把判据写得很清楚:量级依赖看的是差值对均值的回归斜率(示例 b=−0.006、95%CI[−0.037, 0.026]、p=0.725),不是各层自己的 p。示例三层平均偏离 −4.688 / −4.532 / −4.832,层间极差只有差值标准差的 0.06 倍,因此结论是“常数系统偏倚”,可用单一常数标定后再评估互换性。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Bland-Altman 主结果表
- 输出结果三:可视化(Bland-Altman 图与差值分布)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
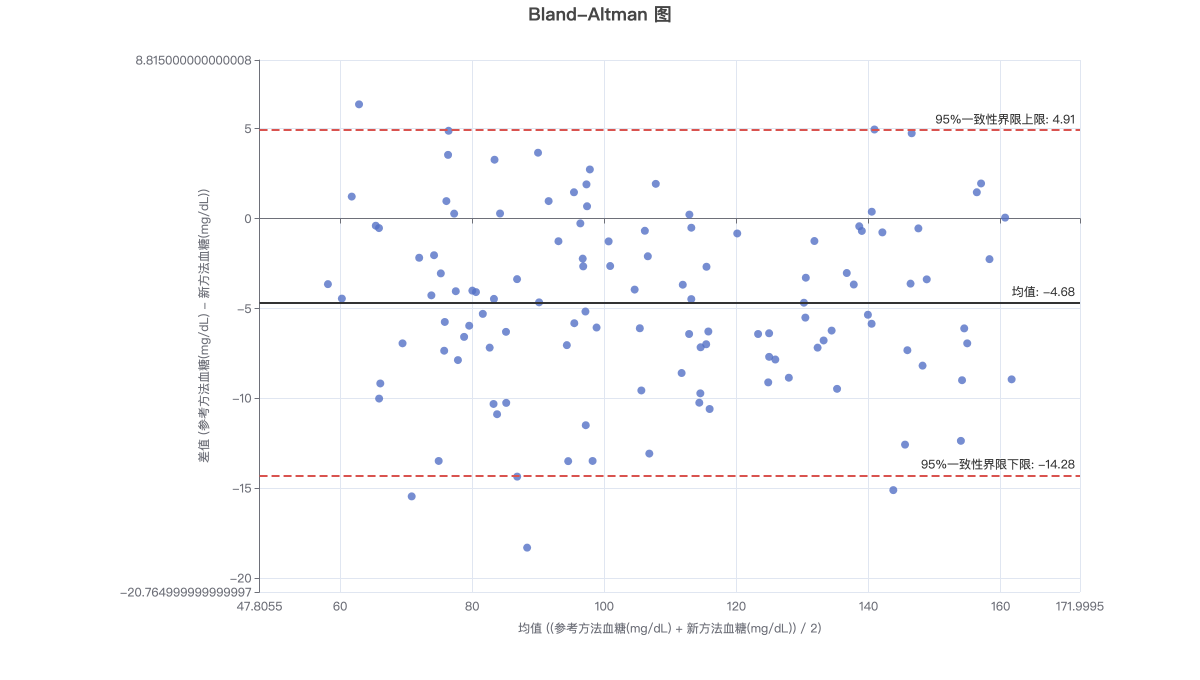
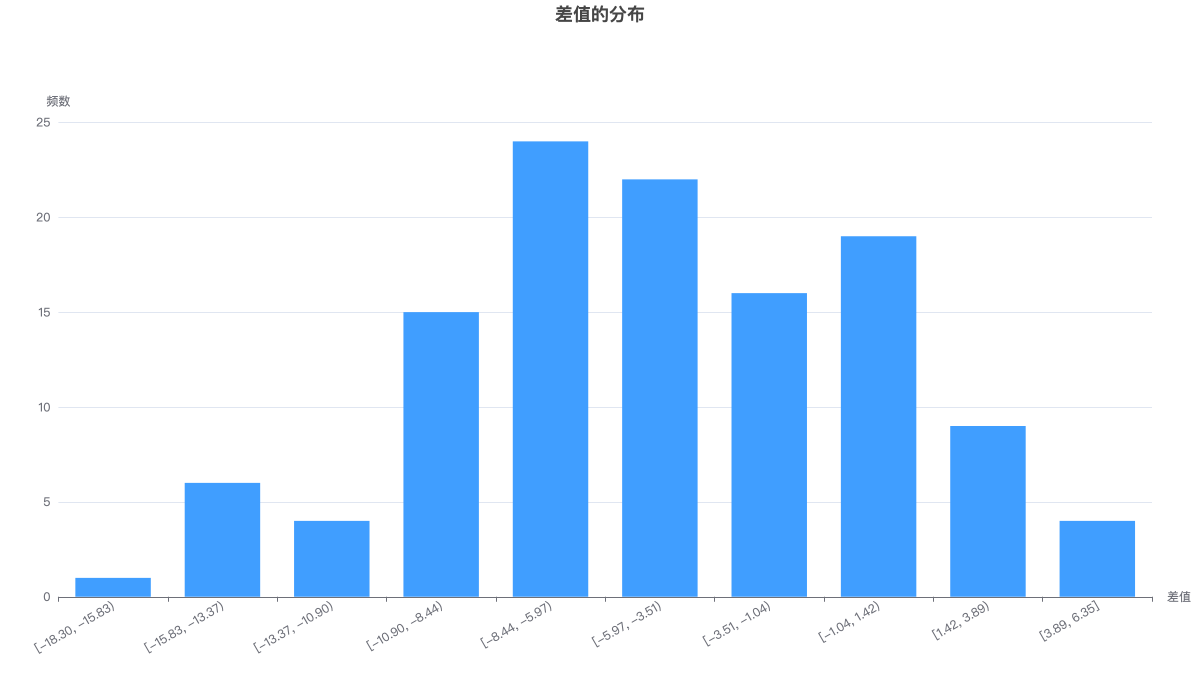
上图直观地展示了两种测量方法的一致性。X轴是两种测量的均值,Y轴是它们的差异。