
交叉分析【多选&多选】
这个方法是做什么的
考察两道多选题之间的搭配关系:勾了 A 题某个选项的人,是不是更可能(或更不可能)也勾 B 题的某个选项。两侧都必须是 0/1 编码的多选项,行区与列区各至少 2 列。多选 × 多选的共现矩阵不是标准列联表——同一位受访者会被重复计入多个格子,网格合计远大于样本量——所以它不对整张表做卡方,而是把每一对(行选项 × 列选项)还原成受访者层面的 2×2 表:两项都选 / 只选行项 / 只选列项 / 两项都不选,四格互斥且合计恰为 N。
读这份报告时,重心应当放在 φ 的符号上——它区分“搭配”与“互斥”,这是两道多选题交叉最有决策价值的产物。卡④ 对每一对给 φ 系数(定义域 −1~1,正=倾向搭配、负=倾向互斥,其绝对值等于该表的 Cramér's V)、Jaccard 相似度、偏倚校正 V 与优势比 OR 及其 95%CI;卡② 给逐对的 χ²、p 与 Holm 校正 p(族系是全部选项组合);卡③ 画“两项都选”格的调整标准化残差热力图,红色是搭配、蓝色是互斥。
需要准备什么数据
- 行变量 (多选题):至少 2 个,定类变量(分组/标签)
- 列变量 (多选题):至少 2 个,定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「行变量 (多选题)」必须正好是 2 个类别。
- 「列变量 (多选题)」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 购买考虑因素 × 期望改进方向,找“关心什么的人在意什么”的对应关系
- 想找出带替代关系的选项对(选了这个就不太选那个),用于产品组合与套餐设计
- 需要方向与强度都量化的结果,而不只是一张共现人数表
- 需要在多次比较之后仍站得住的结论(逐对检验 + Holm 校正)
前提:两侧的多选列都必须是 0/1 编码,且每个选项都要既有人选中又有人未选中(全选或全不选的列边际为空,2×2 表退化);同一字段不能同时放进行区与列区(自我关联恒为 1);数据表至少 30 行。检验次数等于行选项数 × 列选项数,模块的使用说明直接建议先聚焦真正关心的选项组合,而不是把两道题的全部选项一次性拖入。
什么时候不要用它
- 只有一边是多选题,另一边是单选题:分组变量只有一个且想看各人群的选择率,用「交叉分析【单选&多选】」;分组变量有多个或想看构成比,用「交叉分析【多选&单选】」。
- 两边都是单选题:不涉及多重响应,一个行变量批量扫多个列变量用「列联(交叉)分析」;只做一对且需要逐格期望频数与 Cohen's w 用「卡方检验」。
- 只关心一道多选题内部各选项之间的关系:同一道题内的两两比较是相关样本问题,用「多选分析」,它给 Cochran's Q 与 McNemar 精确检验。
- 数据是“一行一条勾选记录”的长表(一笔订单占多行、一个病例占多行):本模块要求宽表、一行一位受访者,长表结构的项目共现请用「关联分析」,它按支持度、置信度、提升度挖关联规则。
- 目的是挑出覆盖人数最多的选项组合:共现关系强弱不等于组合覆盖,净触达要去重计算,用「TURF触达频次分析」。
容易误读的地方
- 卡② 的第一张共现表只能看、不能拿去做卡方。 表注写明:它是描述性共现汇总,同一受访者会被重复计入多格,各格之和远大于 N(示例行变量总响应 293 次、列变量 307 次,而 N=200)。把这张表复制出去再跑一次独立性卡方,等于人为放大样本量、夸大 χ² 与显著性,得到的 p 不可解释。全部显著性都来自下面那张逐对 2×2 表。
- 共现人数最多的组合往往不是关联最强的。 示例里“购买考虑-外观时尚”ד期望改进-价格下调”共现 62 人、Jaccard 0.388,都排在前列,φ 却只有 0.013,几乎完全独立;而共现只有 51 人的“购买考虑-价格实惠”ד期望改进-服务提升”φ=0.115。原因在表注里:Jaccard 不扣除两个选项各自的普及率,两个都很热门的选项即便彼此独立,共现人数与 Jaccard 也会很高。要看关联,必须看 φ 与 2×2 检验。
- φ 全为正且无一显著,正确的读法是“没发现搭配也没发现互斥”。 示例 9 对的 φ 介于 0.013~0.128,方向列全部写着“正向(倾向搭配选择)”,但 Holm 校正后 0 对显著,偏倚校正 V 有 6 对直接归 0。此时把“方向列全是正向”写成“这些选项倾向被一起选择”,是把噪声的符号当成了结论。同理,V 的 95%CI 下限全部是 0.000(区间由非中心 χ² 反解并截断到 0),也不构成“弱关联”的证据。
- 本模块的缺失处理与另外两个交叉模块不一样:整行剔除。 它的使用说明写明,含非 0/1 取值或缺失的记录会被整行剔除,剔除数量在卡① 如实列出(示例剔除 0 条)——为的是让每一对 2×2 表的合计都等于同一个 N。而「交叉分析【单选&多选】」与「交叉分析【多选&单选】」是把非 0/1 与缺失一律按“未选中”处理。同一份不干净的数据在三个模块里会得到不同的样本量,比对结果前先看卡① 的剔除数。
- 检验次数是行选项数乘列选项数,很容易把真实的弱关联淹掉。 示例 3×3 只有 9 次,最小的未校正 p 是 0.095,Holm 后变成 0.859。若把两道各 8 个选项的题全部拖入就是 64 次检验,Holm 的第一步阈值是 0.05/64。这不是校正过严,而是提醒:多选 × 多选天然是大规模比较,应当先按业务假设选定要看的选项,再进来做检验。
报告里有什么
- 输出结果一:样本、编码合规性与期望频数前提
- 输出结果二:共现列联表与逐对独立性检验(主结果表)
- 输出结果三:交叉汇总图与共现残差热力图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
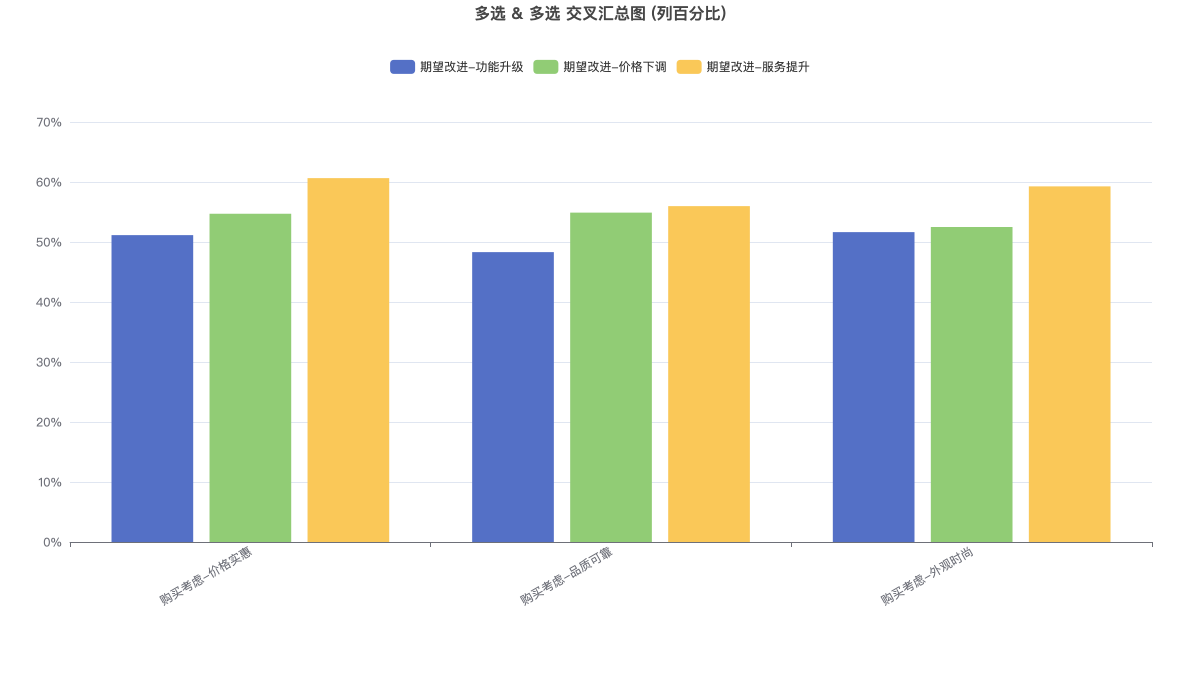
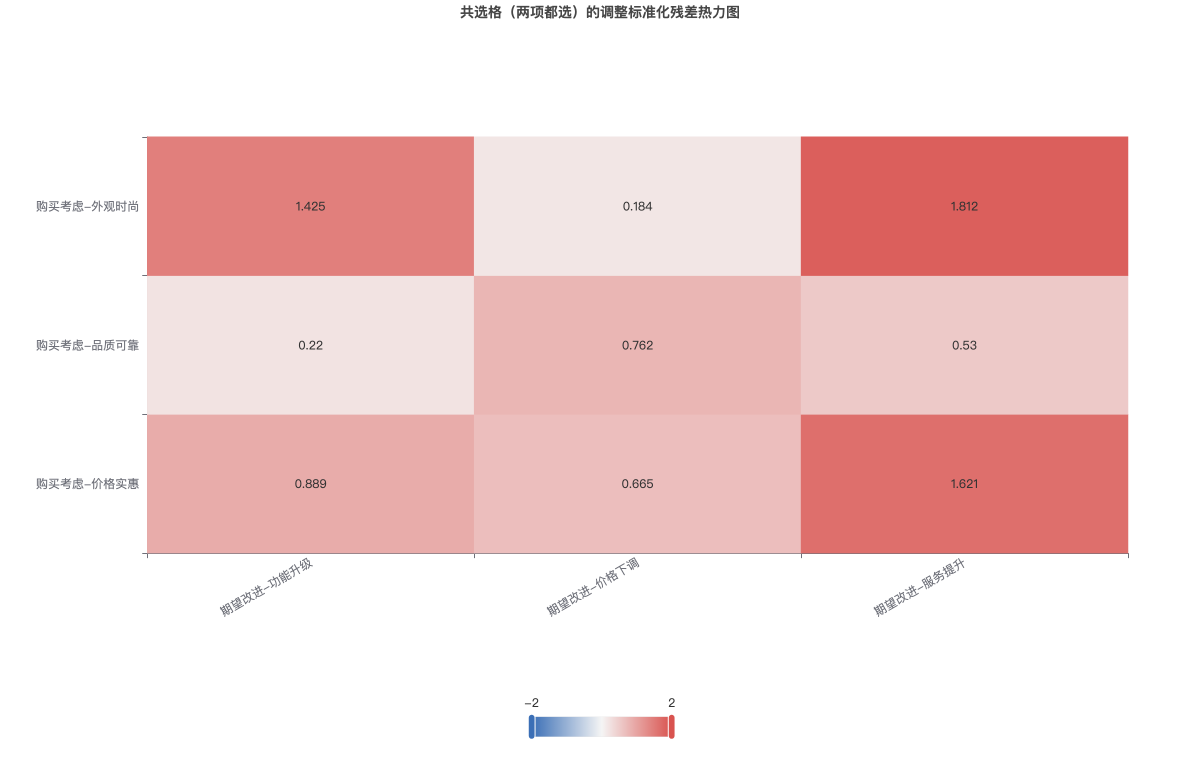
上图可通过下拉框切换指标(列百分比/行百分比/频数)与图表形态,也可用右上角视图切换器在柱状图、条形图、折线图、雷达图与表格之间切换。下图为每一对选项「两项都选」格子的调整标准化残差热力图,直接反映搭配(红)或互斥(蓝)的方向与强度。