
多准则妥协解排序法(VIKOR)
这个方法是做什么的
VIKOR 也给一份综合名次,但它把“综合表现”拆成了两个视角。负向指标先取反同向化,再以各指标的最优值 f* 与最劣值 f⁻ 构造规格化距离;群体效应 S 是这些距离的加权求和,代表“整体上离理想有多远”;个体遗憾 R 取其中的最大项,代表“最短的那块板有多短”。二者按决策机制系数 v 合成利益比率 Q = v·(S 的归一化) + (1−v)·(R 的归一化),S、R、Q 都是越小越优。v 默认 0.5,可在顶部改:v 越大越看重整体表现,越小越看重不出短板。
它真正区别于其他排序法的地方在第四张卡:Opricovic & Tzeng 的两个可接受性条件。C1 要求第一名与第二名的 Q 差值不小于 DQ = 1/(方案数−1);C2 要求第一名同时在 S 或 R 上也最优。只有两条同时成立才能宣布唯一最优折中解,否则报告会给出一个“妥协解集合”——把所有与第一名 Q 差距小于 DQ 的方案列出来,视为无法区分优劣。演示数据上 C1 不满足、C2 满足,于是集合里有 3 个方案。同一张卡还给权重 ±20% 扰动、等权对照,以及 v 从 0 到 1 取 5 档的排名敏感性。因此读这份报告的正确顺序是倒着来:先翻到第四张卡看 C1、C2 判成了什么,再回第二张卡决定那份名次能拿来说到什么程度——直接从名次表开始读,等于把这个方法最有价值的那道约束跳过去了。
需要准备什么数据
- 正向指标 (越大越好)(可选):至少 0 个,定量变量(数值)
- 负向指标 (越小越好)(可选):至少 0 个,定量变量(数值)
- 索引项 (可选, 用于标识对象)(可选):不限
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 决策要落到“选哪个方案”,而且你需要一个说得清的标准来判断第一名的领先是否够大
- 关心短板:某个方案总分不错但有一项特别差,希望这件事在结论里体现出来
- 决策者对“整体最优”与“不出短板”的偏好本身不确定,想看这个偏好变化时名次会不会翻
- 指标里同时有效益型与成本型,需要系统完成同向化
前提是至少 2 个定量指标与 2 个有效方案,且方案数不少于 3——数据要求里写明 DQ=1/(方案数−1) 只在方案数≥3 时才有判别力。常数指标在规格化后各方案取值相同,对 S/R/Q 没有区分作用。权重默认用熵权法,也可以在顶部改成“权重相同”;无论用哪种,权重都只反映数据的离散结构,不反映业务上的轻重。
什么时候不要用它
- 你就是要一个明确的第一名,不接受“妥协解集合”这种结论:用「优劣解距离法(TOPSIS)」,它按贴近度直接给唯一名次。
- 结论要落在分档而非名次:用「秩和比综合评价法(RSR)」,它用 Probit 回归外推出分档临界值。
- 只需要一套指标权重:用「熵值法」或「CRITIC权重法」,本模块的赋权只是排序的中间步骤。
- 要评的是投入产出效率、还想知道该削减哪一项投入:用「数据包络分析(DEA)」。
- 被评对象只有一个,要判断它落在哪个等级:用「模糊综合评价」。
- 两个子系统之间的协调程度才是研究问题:用「耦合协调度」。
容易误读的地方
- Q=0.0000 不是“完美”,它是归一化的产物。 Q 用本批方案的 S、R 极值做归一化,一个方案只要同时在 S 和 R 上取到最优,Q 就恰好是 0——演示数据里“华东区”正是如此(S=0.0714=S+,R=0.0306=R+),报告里的“成渝区”Q=1.0000 同理落在另一端。这两个数字不含任何绝对水平信息,也不因此说明第一名领先得多。要判断领先幅度,看的是第二名的 Q 与 DQ 的比较。
- C1 不满足时把第一名写成“最优方案”,就是越过了方法自己设的门槛。 演示数据上前两名的 Q 只差 0.0346,而 DQ=0.0714,报告明确写着应报告妥协解集合而非唯一最优方案。这是 VIKOR 相对 TOPSIS 最有价值的地方,跳过它等于把它降级成了一个普通排序法。
- S 和 R 会给出不同的名次,这不是矛盾。 S 是加权求和,高度相关的指标会被重复计入;R 只取最大的一项,对指标冗余相对不敏感。所以第一张卡报出 |r|≥0.9 的指标对时,受影响的主要是 S 那一列。两列名次分歧大,说明“整体表现”与“短板”指向了不同的方案,正是需要写进结论的信息。
- v 是决策者的偏好,不是可以调到“结果好看”为止的参数。 第四张卡把 v=0、0.25、0.5、0.75、1 五档的名次都算了出来;演示数据上 v=0(纯个体遗憾)时与基准排名的 Spearman ρ 掉到 0.9643、有 9 个方案名次变动。v 必须在方法部分写明并给出依据,改完 v 再回头挑一个满意的名次是不成立的做法。
- Q 的排序是相对的,增删方案会改变全部结果。 f* 与 f⁻ 由本批方案的极值确定,DQ 还直接依赖方案个数——多加一个方案,阈值本身就变了,原来满足 C1 的结论可能不再成立。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:指标权重与 VIKOR 排序主结果表
- 输出结果三:可视化(评价对象排序图)
- 输出结果四:妥协解可接受性与敏感性分析
- 输出结果五:结论与学术表述
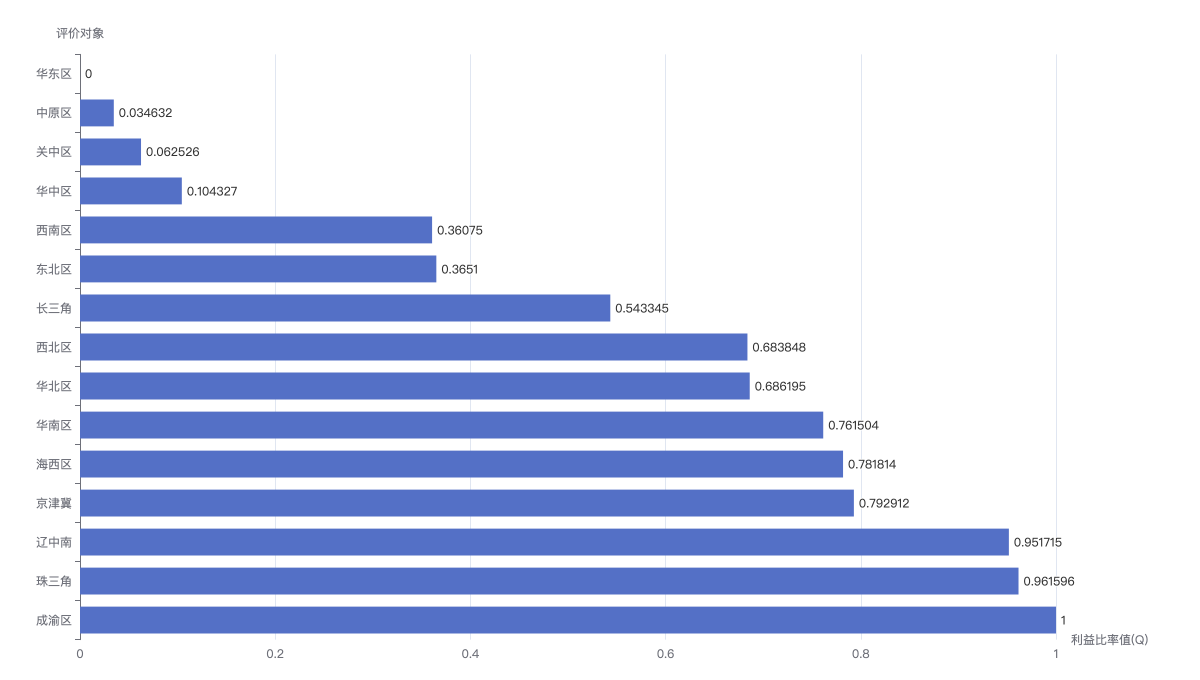
该图以横向条形展示各评价对象的利益比率值(Q)。VIKOR 中 Q 值越小越优,为便于阅读,条形按 Q 值由大到小(由劣到优)排列,最优对象(Q 最小)显示在最顶端;可切换为柱形图/折线图/表格视图,表视图按 Q 由小到大列出。