
Tobit回归
这个方法是做什么的
用于因变量在某个阈值处堆积的数据:一大批家庭的医疗自付支出恰好是 0、一批学生的分数顶到满分、捐款额不能为负。这类数据直接做普通回归会同时算歪斜率与截距,因为它把“堆在边界上的那些观测”当成真的就等于那个值。Tobit 假设背后存在一个不受限的潜变量 y*,你只观测到它被截断后的版本,用极大似然同时估计回归系数与尺度参数 σ。左侧受限值与右侧受限值由你在控件里填写,至少填一个——两个都留空时端点直接返回 400“必须至少提供一个左侧或右侧受限值。”
报告有两个必须分清的口径:系数 β 是对潜变量 y\* 的效应,而实际要报的往往是对观测到的 y 的平均边际效应 APE = β × 平均 P(未删失)。卡④ 把两列并排给出,并单独印出缩放因子(演示数据 0.7116,即 APE 约为潜变量系数的 71.2%)。卡① 给删失结构表与前提检验,卡② 给似然比检验与系数表(含尺度参数 Sigma 那一行),卡③ 是略去截距的系数森林图,卡④ 另给 McFadden 伪 R² 与 AIC/BIC。
需要准备什么数据
- 放入因变量 (Y) [定量]:1 个,定量变量(数值)
- 放入自变量 (X) [定类/定量]:1~50 个,定量或定类变量
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 因变量有一批观测恰好等于某个边界值,且这个边界是“不能再低 / 不能再高”造成的:自付支出、加班时长、广告投放额、捐款额
- 量表或评分出现天花板/地板效应,一批人顶格或垫底
- 你想知道“如果没有这道限制,X 的效应有多大”(潜变量口径),或者“实际观测到的 Y 平均变化多少”(APE 口径)——报告两者都给
- 删失比例不高不低:太低时 Tobit 与普通回归趋同,太高(如超过 80%)时可识别的信息太少、估计不稳
因变量须为定量;自变量可为定量或定类,定类会自动做哑变量编码,因此不能是常数列。必须填写左侧或右侧受限值至少一个。声明的行数下限是 30,样本过小或存在严重共线时观测信息阵可能奇异而给不出可靠标准误。
什么时候不要用它
- 因变量的 0 表示“这件事没发生”而不是“被截断”(一年就诊 0 次、投诉 0 件):那是计数问题,用「计数数据回归」;0 特别多时用「零膨胀计数回归(ZIP/ZINB)」——它能把“根本不会发生”与“会发生但这次是 0”分开,Tobit 做不到这个区分。
- 删失来自样本自选择而不是取值被截断(只有申请过的人才观测到贷款额):需要一个选择方程,用「Heckman两步法」。卡⑤ 明写本模块不含样本选择机制。
- 被删失的是持续时间、且删失来自随访终止(生存时间右删失):删失机制与 Tobit 不同,用「Kaplan-Meier生存分析」或「Cox比例风险回归」。
- 因变量其实没有堆积:删失比例接近 0 时 Tobit 退化为普通回归,用「线性回归 (最小二乘法)」;报告会在卡① 直接给出这个建议。
- 因变量是二分类或有序等级:用「逻辑回归」或「有序逻辑回归」。
- 你只是想压住几个极端值的影响:那是离群问题不是截断问题,用「稳健回归(Huber M估计)」或「缩尾处理(Winsorize)」。
容易误读的地方
- 受限值是你填进去的数,模块不会从数据里认出来——填错了它照跑不误。 实测:把左侧受限值从 0 改成 −1(低于数据最小值),模块照常出报告,卡① 老实写出“删失观测 0/300(0.00%)”并提示“Tobit 会退化为普通 OLS,建议改用线性回归”;但系数已经变了——“家庭年收入”的系数从 0.234 掉到 0.157,缩放因子从 0.7116 变成 0.9213。拿到报告的第一件事是核对卡① 的删失结构表:左删失、右删失的个数与占比是否与你对数据的理解一致。
- 别把系数 β 直接读成“X 每增加 1 单位,支出平均增加 β”。 β 是对潜变量 y* 的效应;对观测到的 y 而言要乘上未删失概率。演示数据 β=0.2345 而 APE=0.1668,差了近三成。卡④ 的图注把这句写死了:“二者方向相同、量级不同,混用会显著高估效应”。论文里必须写明报告的是哪个口径。
- 前提被违反时,Tobit 坏的是系数本身,不只是标准误。 普通最小二乘在异方差下点估计仍然无偏、失真的只是标准误;Tobit 的极大似然以“潜变量误差同方差且正态”为前提,违反时估计是不一致的。卡① 的图注和卡⑤ 都点名了这层区别。演示数据的 Shapiro-Wilk p=0.0003、Breusch-Pagan p=0.0003 双双拒绝,报告如实建议改用变换或半参数方法——这种情况下照抄系数表并不安全。
- McFadden 伪 R² 不能按线性 R² 的直觉去读。 演示数据 0.1166 看着很低,但卡④ 的说明写着“0.2~0.4 通常视为拟合良好(不可与线性 R² 直接比较)”。同理,AIC/BIC 只在同一份数据的不同模型之间可比,其绝对数值本身没有意义,跨数据集抄过来对比是无效的。
- APE 的置信区间是近似的,边缘显著的结论要留余地。 卡④ 表注写明:该区间按 delta 法在“缩放因子视为常数”的假定下给出,未计入 σ 与 β 的估计不确定性交互;而标准误本身又由数值 Hessian 求逆得到,属渐近近似。两层近似叠加的方向都是让区间偏窄,所以 p 略小于 0.05 的那一档结论不宜写得太肯定。
报告里有什么
- 输出结果 一:数据概览与前提检验
- 输出结果 二:模型整体检验与系数估计
- 输出结果 三:回归系数森林图
- 输出结果 四:效应量与事后分析
- 输出结果 五:结论与学术表述
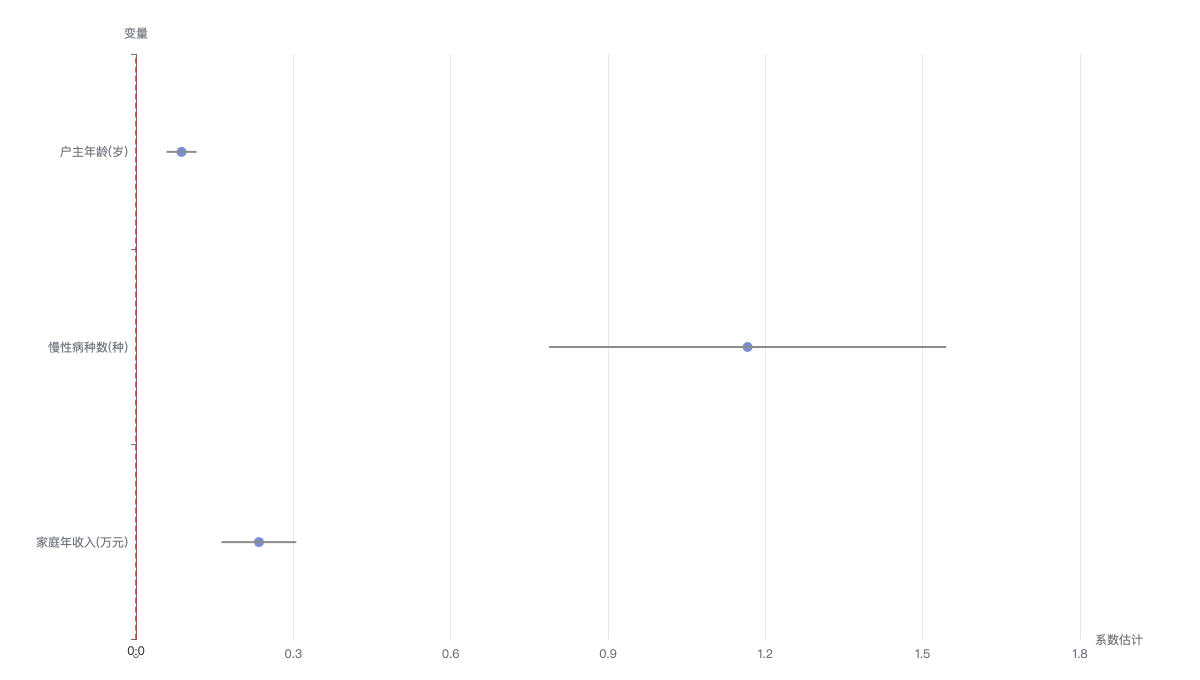
上图为 Tobit 回归各自变量系数的森林图(点=系数估计,横须=95%置信区间,口径与上方“输出结果 二”系数表一致:系数 ± 1.96 × 标准误)。为避免截距(const)量级过大压扁其余系数的置信须,本图已略去截距,仅展示各自变量斜率系数。