
门槛回归(Hansen)
这个方法是做什么的
检验一段回归关系是不是在某个变量跨过一条线之后“换了个样子”。你指定一个定量的门槛变量 q,模块在 q 的 15%~85% 分位带内逐个试候选门槛,取使两区制残差平方和之和最小的那个作为门槛估计 γ*,再把样本切成 q≤γ* 与 q>γ* 两段,各自做一次含常数项的普通最小二乘。这是 Hansen 的单门槛模型:只搜一个门槛,不搜双门槛或多门槛。
报告围绕两个问题展开:门槛效应是不是真的,门槛位置有多准。卡② 给门槛效应 F=[(SSR线性−SSR(γ*))/k]/[SSR(γ*)/(n−2k)] 与近似 p 值,并列出线性模型与分区制模型的残差平方和;卡③ 画 SSR 随候选门槛变化的曲线,最低点即 γ*;卡④ 给 ΔR² 与 Cohen f²、Hansen(2000) 似然比反演的门槛置信区间(临界值 c(0.95)=−2ln(1−√0.95)≈7.352,注意这不是卡方分位数),以及一张把两区制的同一系数逐个做 Welch 近似 t 检验的对照表。
需要准备什么数据
- 放入[定量]因变量 Y:不限
- 放入[定量]自变量 X:至少 1 个
- 放入[定量]门槛变量 q:不限
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 有理论理由相信关系是分段的:规模超过某点后边际效益下降、负债率越过某线后融资成本跳升、客流超过某量后转化率改变
- 想让数据告诉你分界点在哪,而不是自己拍一个中位数去切样本
- 你需要一个能写进论文的门槛估计值及其置信区间,而不只是“高低两组差异显著”
- 两段的样本量都撑得住,门槛变量取值足够分散
因变量、自变量与门槛变量都必须是定量非常数列。门槛变量去重取值少于 3 个时无法搜索;候选门槛只在 q 的 15%~85% 分位带内取值,以保证切开后两侧都有足够观测。每个区制的样本量必须不少于“自变量个数+2”,合计至少 2×(自变量个数+2) 条。
什么时候不要用它
- 门槛位置是制度或政策事先规定好的(起征点、准入线、评级分界):不需要搜索,用「断点回归(RD)」——它专为“跨过这条线就被处理”的设计而设;比较政策前后用「双重差分(DID)」。
- 关系是平滑变化而不是突然折断:用「调节作用分析」检验交互项,或用「限制性立方样条(RCS)」「拟合工具箱」直接拟合非线性形状。
- 怀疑存在两个以上门槛:本模块只估单门槛,卡⑤ 的模型局限写明了这一点。可行的替代是按理论先切分样本再分别建模,或用「C&RT决策树」探索多个分割点。
- 用来分段的变量本来就是定类的(地区、行业、等级):没有门槛可搜,直接把它当分组因子做「协方差分析」,或在「线性回归 (最小二乘法)」里加交互项。
- 数据是个体×时期的面板结构:本模块按截面处理,同一个体的多期记录会被当作互相独立的观测参与门槛搜索与两段回归。用「面板模型」。
- 门槛变量只有寥寥几个档位(去重取值少于 3 个时模块直接无法搜索):候选门槛不足,网格搜索没有意义。把这个档位变量当成定类因子,用「协方差分析」比较各档的截距差异,或在「线性回归 (最小二乘法)」里放它的哑变量与交互项来检验斜率是否随档位变化。
容易误读的地方
- 那个 p 值是 F 分布近似,不是门槛检验的正确分布。 在“无门槛”的原假设下,γ 这个参数根本不存在(Davies 问题),F 统计量并不服从标准 F 分布。卡② 表注与卡⑤ 都写明“严格的门槛显著性推断需自助法(bootstrap)”,而本模块未实现自助法。所以近似 p<0.0001 只能作参考,不能像普通回归的 p 一样引用;论文里必须一并说明这个 p 值是怎么来的。
- 联合 F 显著而逐系数全不显著,是常态而非矛盾。 演示数据联合 F=15.374(近似 p<0.0001),卡④ 的 Welch 逐系数检验却是 0/4 个显著。报告自己解释了口径差别:逐系数表是边际检验,每行只看一个参数、不计入同一区制内截距与斜率之间的协方差;F 检验是“所有系数联合相等”的整体检验,会计入这一协方差。差异分散在多个参数的组合上时就会呈现这种样子。解读以联合检验为主,逐系数表只用来定位差异来源。
- 门槛置信区间塌成一个点,不等于门槛精确到小数点后四位。 演示数据 γ* 的 95% 区间是 [36.9000, 36.9000]。这个区间只能取候选门槛网格上的值,而候选门槛只在 q 的 15%~85% 分位带内取(本次带内 69 个候选),其中只有 1 个满足 LR_n(γ)≤7.352,于是区间就塌成一点。它的分辨率上限是相邻候选值之间的间距。要判断门槛稳不稳,还得看卡③ 那条 SSR 曲线在最低点附近平不平——报告自己也提示:曲线平坦说明门槛位置的不确定性其实很大。
- 两区制的系数是在两个互不重叠的子样本上各做一次最小二乘得到的,标准误没有异方差稳健校正。 卡② 表注写明它们是“对应子样本 OLS 的经典统计量(t 分布区间,未做异方差稳健校正)”。所以一旦卡① 的 Breusch-Pagan 检出异方差,门槛效应 F 与区制系数的 t 都会偏乐观——卡① 的文案专门提示了这一条。演示数据 BP p=0.7374 未检出,才可以照读。
- 门槛是从同一份数据里搜出来的,再用同一份数据检验它,结论天然偏乐观。 网格搜索做的事情就是挑“让拟合改善最大”的那个切点,所以 ΔR²=0.1675 里有一部分来自这次挑选本身,而不是真实的结构变化。这正是 Hansen 坚持要用自助法的原因。把 γ* 当成有实质含义的临界点写进结论之前,先用理论或外部数据核对它是否落在讲得通的位置上。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:门槛估计与两区制回归系数
- 输出结果三:SSR 随门槛候选 γ 变化曲线
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
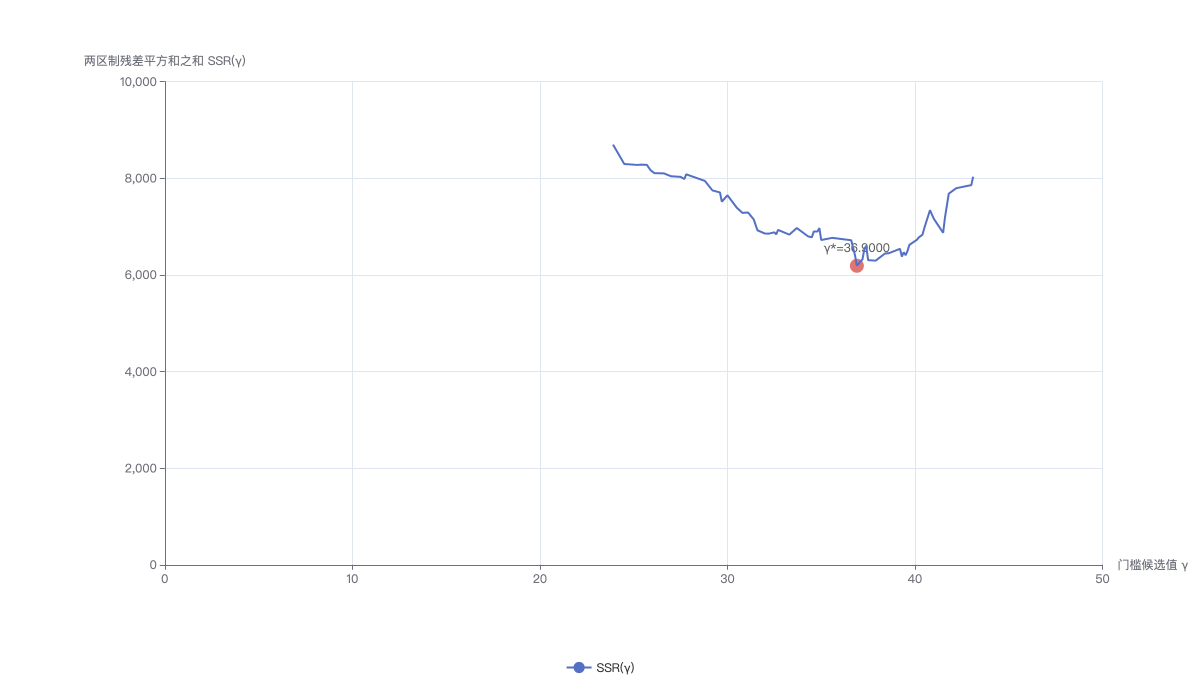
曲线最低点(红点)对应的横坐标即门槛估计 γ*。切换到「表格」视图可同时查看每个候选门槛的 SSR(γ) 与似然比 LR_n(γ)=n·[SSR(γ)−SSR(γ*)]/σ̂²。