
Ridit分析
这个方法是做什么的
比较若干组在有序等级结局上的分布优劣,典型场景是“无效 / 好转 / 显效 / 痊愈”这类疗效等级。做法是先定一个参照分布,把每个等级换算成它在参照分布中的中位位置分位(Ridit 得分 = (累计频数 − 本等级频数/2) / n_ref),再把各组的频数按这套得分加权平均,得到该组的平均 Ridit。
平均 Ridit 本身就是效应量,而且带天然的概率解释:从该组随机抽一例、从参照分布随机抽一例,前者等级更优的概率(等级相同各计一半)。0.5 表示与参照无差别,参照分布自身恒为 0.5。整体检验用 χ² = 12·Σ nᵢ(R̄ᵢ − 0.5)²,自由度 k−1。除此之外报告给出参照分布与各等级得分的完整中间表(这是全部结果的共同刻度,值得先看一眼)、各组构成比、各组相对参照的 z 检验,以及事后成对比较的概率指数 A 与 Cliff's δ(Holm 校正)。
需要准备什么数据
- 分组变量X (定类):不限
- 有序变量Y (定序):不限
- 频数权重 (非必选)(可选):定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 「分组变量X (定类)」的类别数需在 2~20 之间。
- 「有序变量Y (定序)」的类别数需在 2~15 之间。
- 「分组变量X (定类)」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 两种治疗方案在四级疗效上的优劣比较
- 不同科室、不同分期患者在“轻 / 中 / 重”上的构成差异
- 问卷里五点量表题在若干人群间的分布比较
- 需要一个能直接写成“甲组优于乙组的概率是 70.4%”的效应量,而不是只报 p 值
分组变量需 2~20 组、每组至少 5 条记录,等级 2~15 个,总行数不少于 20。等级变量既可以是文字也可以是 1,2,3… 的数值编码,方向一律按取值的自然排序(数值升序,非数值按字符排序)确定。参照分布可在“全体求和”与“样本量最大组”之间切换,它决定整套 Ridit 刻度。频数权重区只在表格本身行数够多时才用得上:一张 2×4 的“组别×等级×频数”汇总表只有 8 行,实测被“当前数据表共 8 行,少于Ridit分析所需的至少 20 行”直接挡下,常规做法仍是上传逐例数据。
什么时候不要用它
- 结局是无序分类(科室、渠道、品牌):等级之间没有优劣可言,Ridit 的整个前提不成立,用「Pearson卡方检验」。
- 结局是连续数值(评分、化验值):不要人为切成等级再做,那会丢信息;两组用「独立样本T检验」,三组及以上用「单因素方差分析」,分布明显偏态时用「多独立样本Kruskal-Wallis检验」。
- 同一批对象前后两次的等级评定(配对资料):独立性前提不成立,两次用「配对样本Wilcoxon检验」,三次及以上用「多配对样本Friedman检验」。
- 需要在比较等级的同时校正协变量、并给出可解释的效应量:Ridit 容不下协变量,用「有序逻辑回归」,它给的是比例优势比。
- 论文要求报告标准的秩和检验统计量:两组用「独立样本 Mann-Whitney U 检验」,多组用「多独立样本Kruskal-Wallis检验」——它们与 Ridit 在等级资料上高度等价,只是表达方式不同。
- 两列是两位评价者对同一批对象的等级判定,你问的是他们判得一致不一致:用「Kappa一致性检验」的加权版本。
容易误读的地方
- 等级的先后由取值的排序决定,不是由你拖入的顺序、更不是你心里的顺序。 实测把示例的“1-无效 / 2-好转 / 3-显效 / 4-痊愈”去掉数字前缀,模块按字符顺序把等级定成“好转 < 无效 < 显效 < 痊愈”——“好转”被排到了“无效”前面。后果是整体 χ² 从 29.819 掉到 22.640,概率指数 A 从 0.704 变成 0.677、Cliff's δ 从 0.407 变成 0.355。第一张卡有一行明写“由劣到优:…”,每次分析先核这一行;文字排序靠不住时,把等级编成 1,2,3… 再拖进来。
- 顺序整体搞反时,整体检验一个数字都不会变,只有优劣判读全部反向。 实测把四个等级的编号整体倒过来:χ² 仍是 29.819、p 仍是 <0.001,纹丝不动;可常规治疗的平均 Ridit 从 0.398 变成 0.602、判读从“显著劣于参照分布”变成“显著优于参照分布”,概率指数 A 从 0.704 翻成 0.296、δ 从 +0.407 翻成 −0.407。指望 p 值替你发现顺序搞反是不可能的,这一条只能靠人核对。
- 参照组选“最大值”时,参照组自己的平均 Ridit 恒等于 0.500、p 恒为 1.000,那不是“这组没有差异”的证据。 实测切到最大值模式:参照变成样本量最大的常规治疗,它的 R̄=0.500、z=0.000、p=1.000,判读栏写着“与参照分布无显著差异”——这是定义决定的,换哪一组当参照都会得到同一行。同时整体 χ² 从 29.819 变成 59.638,因为刻度换了。两种模式的数值不能混着报,组间结论请以第四张卡的成对比较为准。
- 平均 Ridit 是一个概率,不是平均等级,也不是百分比。 示例联合治疗的 0.602 意思是“从该组抽一例、从参照分布抽一例,前者等级更优的概率约 60.2%”,不能读成“疗效提高了 60%”。判断某组是否异于参照,要看 95% 置信区间含不含 0.5(示例 [0.550, 0.654] 不含 0.5),而不是含不含 0——这是最容易顺手读错的一处。
- 整体显著只说明“至少有一组与其他组不同”。 组数多于两个时,具体谁与谁不同必须看第四张卡的成对比较,那里已按 Holm-Bonferroni 逐步法控制族系错误率。另外“全体求和”模式下各组本身也是参照分布的一部分,因此单组相对 0.5 的那个 z 检验偏保守,表注对此有说明;组间比较不要拿两组各自的单组 p 去凑。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Ridit 分析主结果表
- 输出结果三:Ridit 值与等级构成可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
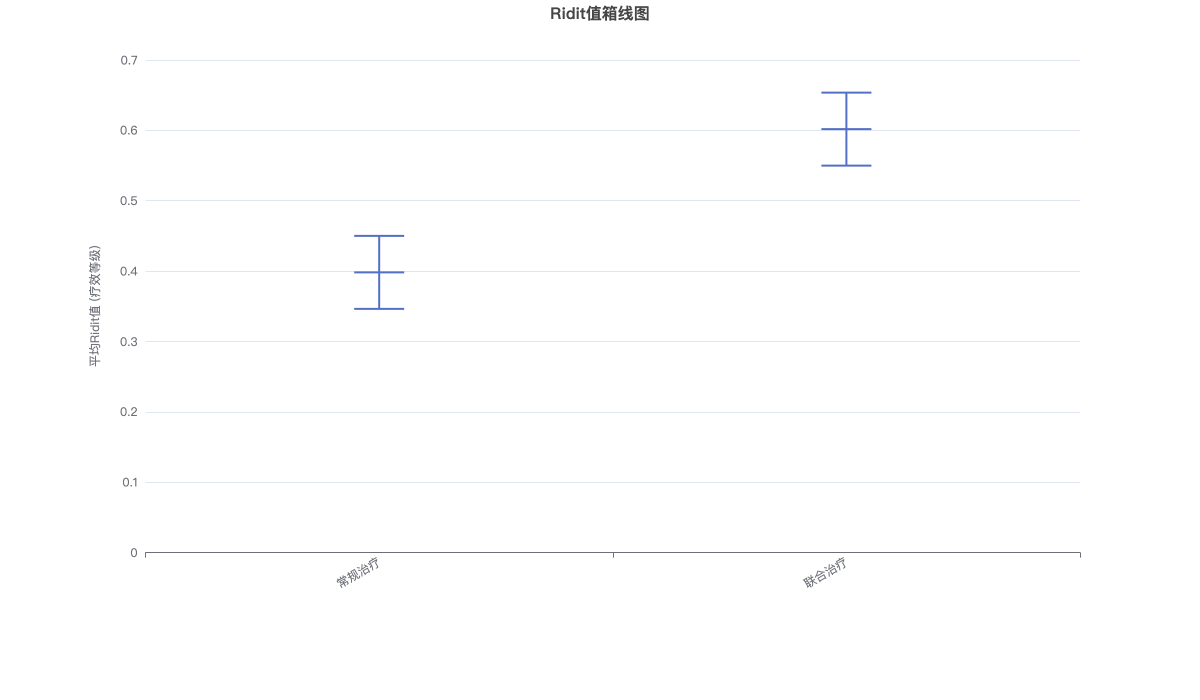
上图通过箱线图的形式可视化了各组的平均Ridit值及其95%置信区间。每个箱体的中线代表平均Ridit值,箱体的上下边界代表95%置信区间的范围。
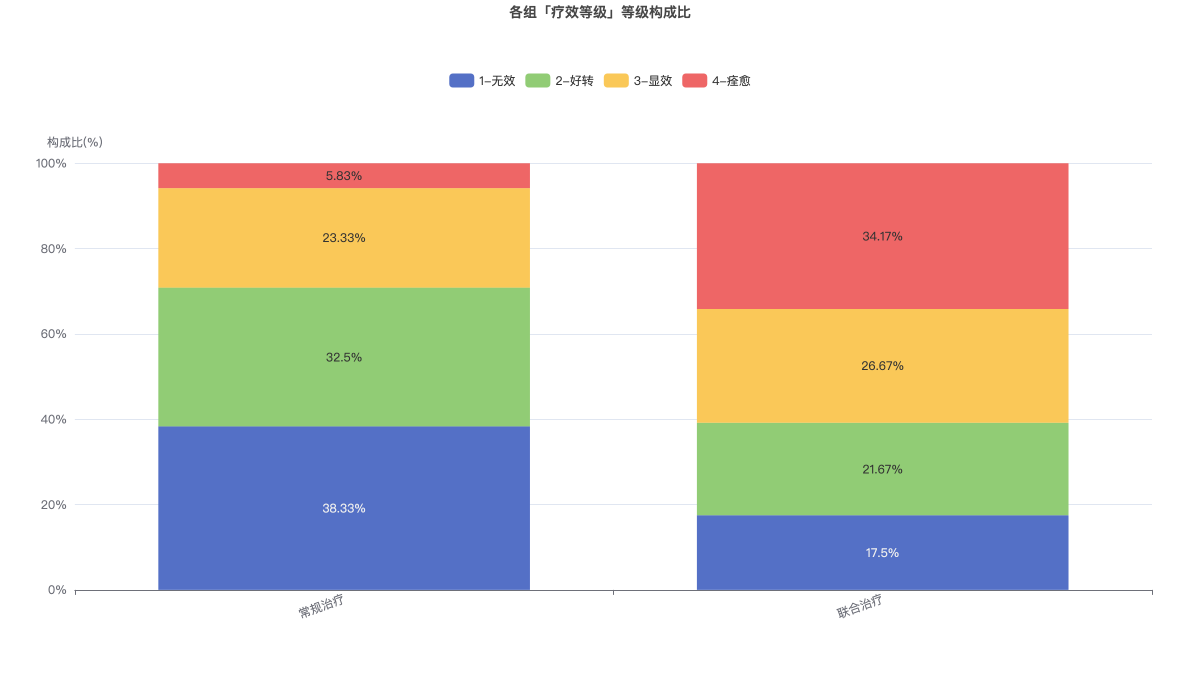
堆积柱形图展示各组在「疗效等级」各等级上的构成比(行百分比,合计 100%)。它是平均 Ridit 值的原始依据——构成比越向「优」的等级集中,该组的平均 Ridit 越高。可用右上角的视图切换器在「柱状图 / 条形图 / 折线图 / 表格」之间互切。