
分类汇总
这个方法是做什么的
按一个分组变量把若干个定量变量拆开,逐组给出统计量。主表输出的是你在“统计方式”控件里选中的那一个量——计数、均值、中位数、标准差、最大值、最小值、求和,七选一,默认是计数;同一张卡的第二张表则不管你选了什么,都把每组的 N、均值、标准差、中位数、最小值、最大值与求和一次给全。卡① 还会附一张不分组的全样本描述统计,用来和分组结果对照。
它不执行组间差异检验,因此没有 p 值,任何组间差距都不能被写成“显著”。卡④ 本该放效应量的位置换成了两组描述指标:一组衡量落差——组均值极差、组均值最大/最小比、分离度(组均值极差 ÷ 总体标准差)、组内变异系数的范围与均值;另一组衡量分组本身是否均衡——组容量最大/最小比与归一化 Shannon 熵。
需要准备什么数据
- 分组变量(分类字段):不限
- 汇总变量(可多选):至少 1 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 50%。
- 「分组变量(分类字段)」的类别数需在 2~50 之间。
- 「分组变量(分类字段)」的每一组至少 1 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 各门店、各科室、各渠道在销售额、住院天数、转化金额上的对比摸底
- 试验组与对照组在基线变量上的描述表,也就是论文里的表 1
- 做差异检验之前先看一眼各组的 N、均值与离散度是否合理,有没有只剩几个人的组
- 需要把一批定量变量按同一个分组变量批量汇总,而不想逐个变量重复操作
分组变量必须是定类或定序列,类别数在 2~50 之间;汇总变量必须是定量列,文本单元格会被静默转成缺失,所以某个变量的缺失率异常高时要回查原始数据。分组变量缺失的记录无法归入任何组,会被整行剔除;分组变量与汇总变量不能是同一列;总行数至少 10 行。
什么时候不要用它
- 要判断组间差异是否具有统计学意义:两组用「独立样本T检验」,三组及以上用「单因素方差分析」;不满足正态时两组用「独立样本 Mann-Whitney U 检验」、多组用「多独立样本Kruskal-Wallis检验」。
- 汇总变量本身是分类的(想看各组里各类别的占比):本模块只接受定量列,用「列联(交叉)分析」。
- 不分组,只想看每个定量变量自身的完整分布(百分位数、置信区间、离群栅栏):用「描述性统计」;只想先看整张表每列的概况,用「数据概览」。
- 想按两个分组变量交叉拆开(部门 × 性别):本模块只接受 1 个分组变量,可先用“公式”把两列拼成一个组合变量再回来跑;若目的是判断两个因素对定量结果的影响,直接用「双因素方差分析」。
- 各组的缺失情况差别很大,怀疑缺失与分组有关:本模块只按变量剔除缺失、不诊断机制,用「缺失模式分析表」。
容易误读的地方
- “统计方式”默认是计数,主表第一眼给的是样本量而不是均值。 示例报告的主表里“对照组 60 / 试验组 60”,那是每组有多少条有效记录,三个汇总变量的数字还完全一样——因为它们都没有缺失。把这张表当成均值来读,会得出“两组毫无差别”的荒谬结论。要看均值,要么在控件里改选“均值”,要么直接读同一张卡的“各组完整描述统计”表,它不受该控件影响。反过来说,计数那一行出现差异恰恰是缺失的信号,值得回查。
- “分离度”既不是效应量,也不代表显著。 它等于组均值极差 ÷ 总体标准差(示例中“门店面积”为 0.24),作用只是把落差换算成标准差的倍数、方便跨量纲变量比较。它没有抽样分布,不做多重比较,不能当成 η² 来引用,更不能据此写“组间差异显著”。要显著性必须换到检验类模块重做。同一张表里的“组均值最大/最小比”还有个额外限制:均值有正有负或接近 0 时,这个比值没有意义。
- 各统计量按变量成对删除缺失,同一组在不同变量上的 N 可以不同。 分组变量缺失的记录整行剔除,但汇总变量的缺失是逐列处理的。于是“对照组”可能在广告投入上有 60 人、在门店面积上只有 52 人,两个组均值实际来自不同的人群,直接放在一起比较跨变量的落差就不严谨。卡① 的“汇总变量最小有效N”一列就是给这件事用的。
- 组内样本量小的组,均值和标准差都不可信,但图上看不出来。 卡① 会逐组标注是否满足 n≥3,n<2 时标准差干脆没有定义、显示为占位符。分成几十类的分组变量很容易造出一堆只有一两个人的组,而这些组在柱状图上和 n=60 的组画得一样高、一样“确定”。读图前先看卡① 的每组 N,再看卡④ 的组容量均衡度——归一化 Shannon 熵为 1 表示各组样本量完全相同,越小越失衡。
- 组内变异系数在均值接近 0 时会失控,而失控的组已经被悄悄剔除了。 组内变异系数 = |组内标准差 ÷ 组内均值|,示例里三个变量都落在 26%~28%。但收益率、温差、盈亏这类有正有负的变量,均值趋近 0 会让这个比值爆成一个巨大且不稳定的数,模块的做法是把这些组从统计中剔除。这意味着卡④ 给出的“组内变异系数范围”可能只是在剩下的少数几组上算出来的,不能当作全部组的情况来读。
报告里有什么
- 输出结果一:分组结构与前提检验
- 输出结果二:分组描述统计三线表
- 输出结果三:分组分布可视化
- 输出结果四:组间离散度与均衡度指标
- 输出结果五:结论与解读
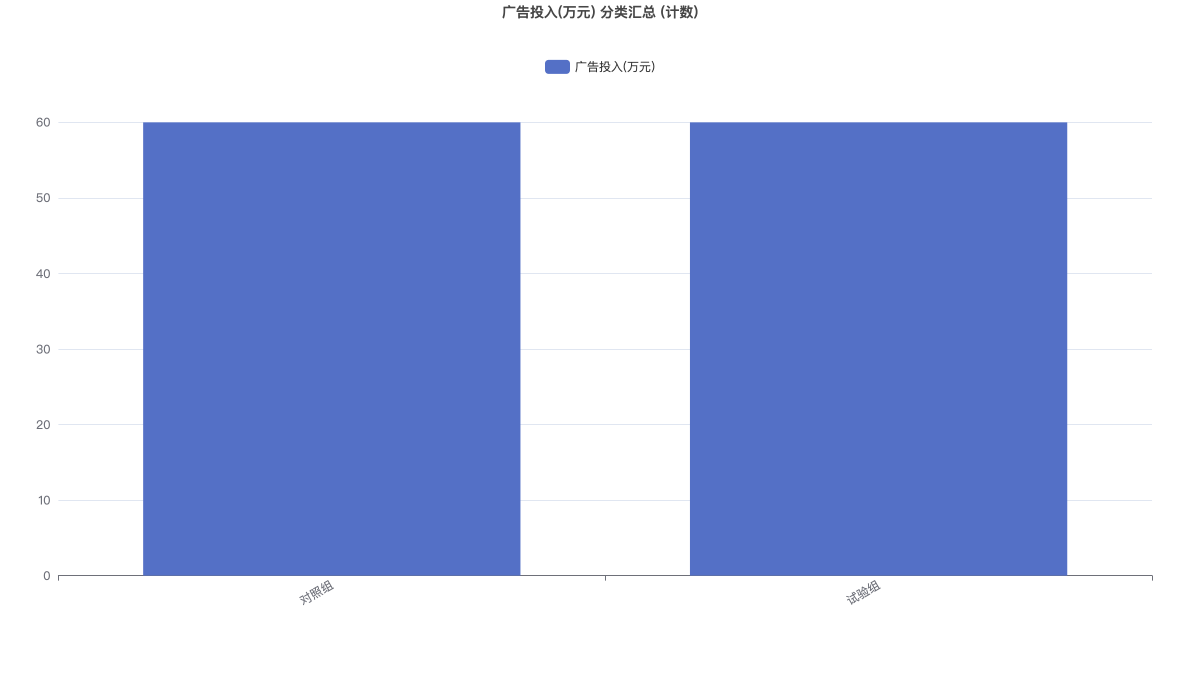
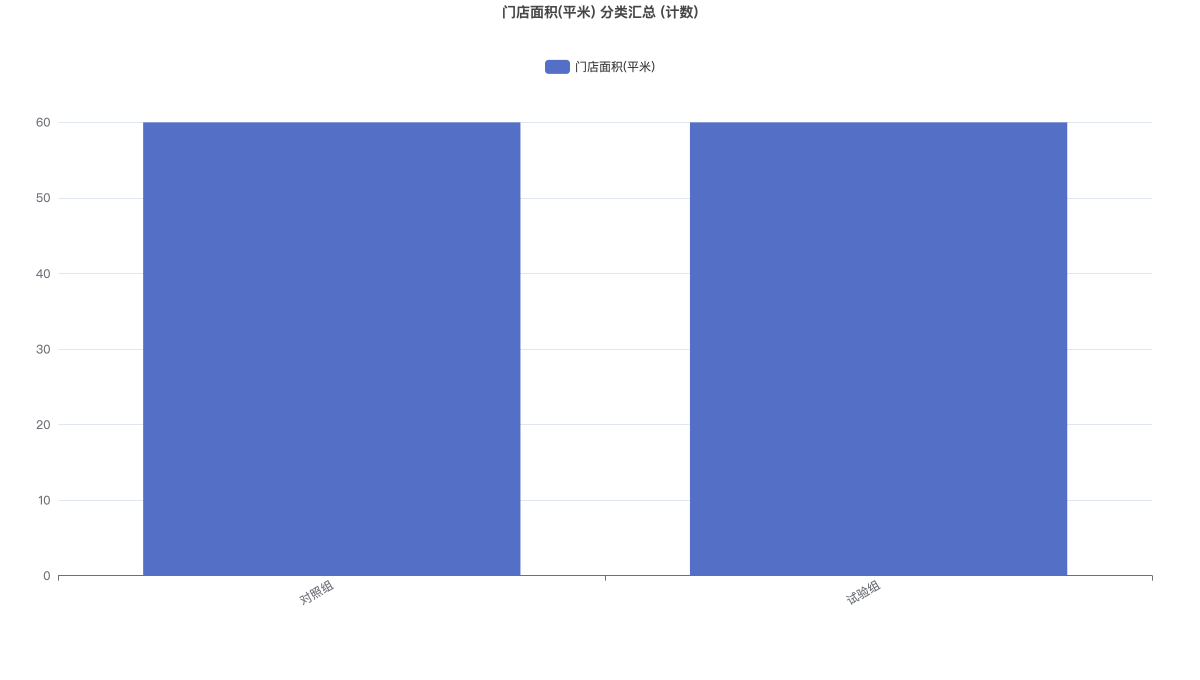
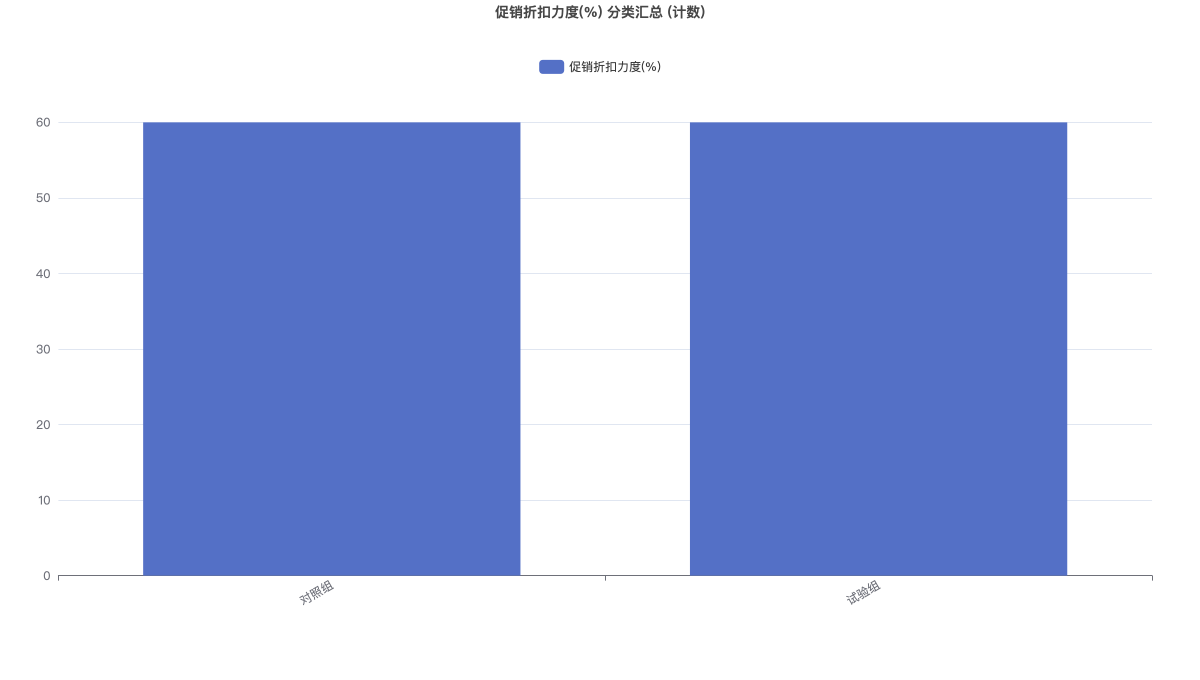
上图直观地展示了按“组别”分组后,各汇总变量的“计数”统计结果。每个图表对应一个汇总变量,您可以通过各图表上方的下拉框切换其展示类型。