
优劣解距离法(TOPSIS)
这个方法是做什么的
把每个评价对象看成多指标空间里的一个点,用本批数据的极值构造出“各指标都最优”的正理想解与“各指标都最劣”的负理想解,再算每个对象到这两点的加权欧氏距离 D+ 与 D−,按贴近度 C = D−/(D+ + D−) 排序,C 越接近 1 越优。指标方向由拖拽区决定:正向区是效益型,负向区是成本型,两区的列分别按 (x−min)/(max−min) 与 (max−x)/(max−min) 映射到 [0,1] 的“越大越优”尺度,同向化与无量纲化一步完成,因此原始量纲不影响结果。
除了名次,报告还给三样东西。一是权重的来源:默认熵权法,表里逐指标列出信息熵 e、信息效用 d 与权重百分比,顶部可改成“不设置权重”走等权。二是 D+ 与 D− 两列真实距离(未做任何缩放),两者要一起看——D+ 小且 D− 大才是真优者,两者同时偏大说明该对象在不同指标上表现分化,单看 C 会把这种内部不均衡抹掉。三是第四张卡的权重敏感性:对每个指标各施加 ±20% 扰动、再加一个等权对照,每个情景都用与主结果完全相同的归一化矩阵与距离公式重算一遍,报告与基准排名的 Spearman ρ、首位是否易位、最大名次变动与名次发生变动的对象数。综合评价没有经典意义上的显著性检验与效应量,这张卡就是它的替代物——它回答的不是“差异是否显著”,而是“换一套权重,这份名次还成立吗”。
需要准备什么数据
- 放入正向指标 [定量]:定量变量(数值)
- 放入负向指标 [定量]:定量变量(数值)
- 放入 [定类] 变量(可选):定类变量(分组/标签)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 有一批可比对象和一套方向明确的指标,需要一份能写进论文的综合名次
- 指标里同时有“越大越好”和“越小越好”,希望同向化由系统一步完成
- 需要拿出“换一套权重,结论还成立吗”的证据,而不只是一张排名表
- 想同时看到“离最优有多远”和“离最劣有多远”,而不是只有一个总分
前提是评价对象彼此可比,且至少 2 个有效对象——只有 1 个时正负理想解重合、贴近度无定义。第一张卡会顺带做冗余诊断,列出 |r|≥0.9 的指标对。
什么时候不要用它
- 只想要一套指标权重、不需要排名:改用「熵值法」「CRITIC权重法」或「变异系数法」,它们只产出权重表。
- 不愿宣布唯一第一名,想要一组难分伯仲的备选:用「多准则妥协解排序法(VIKOR)」,它有两个可接受性条件专门判断第一名的领先幅度够不够。
- 医学与卫生管理场景,结论要落在分档而非精确名次:用「秩和比综合评价法(RSR)」。
- 要评的是“投入多少换来多少产出”的效率:用「数据包络分析(DEA)」。
- 被评的只有一个对象,你要判断它属于哪个等级:用「模糊综合评价」。
- 指标高度相关,你更想先压缩指标体系:用「VIF共线性诊断」或「Pearson相关性分析」把冗余列定位出来,自己挑掉其中一列再重跑本模块。别指望“先用「主成分分析(PCA)」降维再回来”——它的成分得分只印在报告里、写不回数据集,拿不到成分列当本模块的输入;PCA 只能整体替代本模块、出它自己那套综合得分与排名,而那要求指标全部“越大越好”——它没有成本型指标区,有成本型指标就只能留在本模块。
容易误读的地方
- 贴近度 C=0.72 不是 72 分。 正负理想解由本批对象的极值构成,C 只说明该对象在本批内比负理想解更靠近正理想解,不代表绝对水平。换一批对象,全部得分与名次都会变,跨批次、跨年度不能直接比较;把去年的 C 和今年的 C 放进同一张折线图看“进步了多少”,是这个方法上最常见的硬伤。同理,全体对象的 C 一起偏低不等于大家都差,只说明这批里最好的那个也离正理想解不近。
- 换一种赋权方式,末尾名次会变。 同一份演示数据实测:熵权法下“西南区”第 14、“中原区”第 15;切到“不设置权重”后两者对调,其余 13 个名次分毫不动。第四张卡等权对照那一行(ρ=0.9964、2 个对象名次变动)报的正是这次对调。名次相邻的对象之间,别宣称谁强谁弱。
- 欧氏距离会把高度相关的指标重复计权。 第一张卡在演示数据上报出“科研经费”与“医护比”的 r=0.915:两列携带的是同一份信息,距离公式却各算一次,等于给这份信息偷偷加了倍权。看到这条提示应先精简指标,而不是照抄名次。
- 增删评价对象会改变已有对象之间的相对次序。 这是 TOPSIS 的逆序现象,卡⑤的方法学局限已写明。报告时必须交代对象集合如何构成,更不要中途往表里补对象、再说“名次只是略有变化”。
- 同为熵权法,不同排序方法只在前段一致。 把同一份数据分别喂给本模块、「多准则妥协解排序法(VIKOR)」与「秩和比综合评价法(RSR)」,前 8 名完全相同,分歧全在中后段:本模块把“东北区”排第 11、VIKOR 排第 9;本模块末两名是“西南区”“中原区”,RSR 正好对调。头名可以放心报,中后段的精确名次不要当结论。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:指标权重与 TOPSIS 评价得分主结果表
- 输出结果三:可视化(评价对象排序图)
- 输出结果四:权重敏感性与排名稳定性
- 输出结果五:结论与学术表述
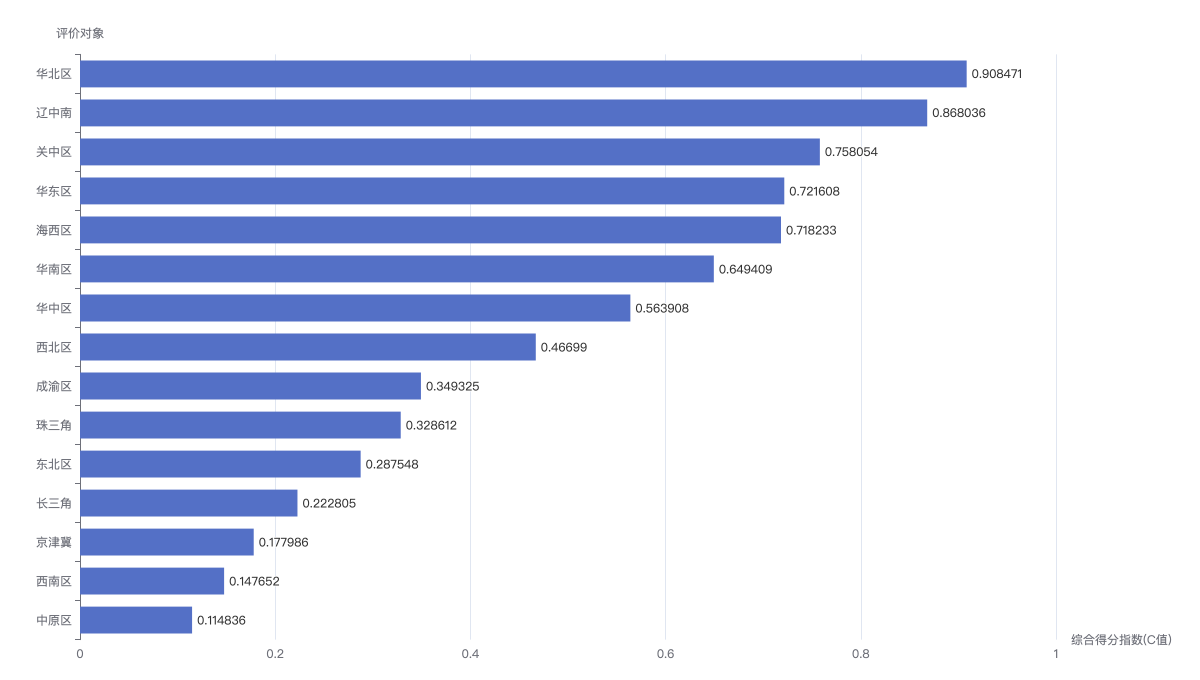
横向条形图按综合得分指数排序(最优在最顶端);可切换为柱形图/折线图/表格视图,表视图按得分从高到低列出。