
寿命表
这个方法是做什么的
寿命表用的是精算表法:把整个随访期切成等长的时间区间,按区间汇总事件数与删失数,再逐区间算“终止比例”并连乘成累计生存比例。它和逐事件时点的乘积极限法的关键差别在于对删失的处理——区间内的删失被假定均匀发生在区间中点,于是有效风险数 = 期初人数 − 0.5 × 区间内删失数。这一条既是它能处理“只知道区间频数”的原因,也是它精度低于逐事件方法的原因。
除了寿命表本身,报告给累计生存比例的 Greenwood 标准误与对数-对数 95% 置信区间、按在险人数加权的 Breslow(Generalized Wilcoxon) 整体检验、两两 Breslow 事后比较(同时给 Holm 与 Bonferroni 校正 p)、以分组变量为唯一协变量的 Cox 风险比 HR、限制平均生存时间 RMST 及其组间差,并另画一条 Kaplan-Meier 曲线作对照。第三张卡有一张“各时间区间的条件事件概率 q”曲线,数值直接取自寿命表的终止比例列。区间的起始、结束、间隔三个参数在顶部设置,默认是 0、30、5。
需要准备什么数据
- 放入[定量]生存时间 T:1 个,定量变量(数值)
- 放入[定类]结局事件 E:1 个,定类变量(分组/标签)
- 放入[定类]分组变量 (可选)(可选):定类变量(分组/标签)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 30%。
- 「放入[定类]结局事件 E」必须正好是 2 个类别。
- 「放入[定类]分组变量 (可选)」的类别数需在 2~12 之间。
- 「放入[定类]分组变量 (可选)」的每一组至少 10 个样本。
- 「放入[定类]结局事件 E」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 手上只有按时间段汇总的随访资料(年度登记表、报表数据)
- 样本量很大、事件时点密集,逐事件的阶梯曲线读起来过于琐碎
- 想看风险随时段怎么变化——终止比例 q 就是“在该区间起点仍存活者中、于该区间内发生事件的比例”
- 要按固定区间报“5 年 / 10 年生存率”这类结果
数据要求:至少 10 行,一列非负的随访时长、一列 0/1 结局,事件与删失各至少 10 例;分组变量每组至少 10 例。除通用的删失非信息性外,精算法还多一条自己的假定:删失在每个区间内均匀分布,第一张卡用 Kolmogorov-Smirnov 检验查它(示例 D=0.1393、p=0.207)。另外各区间的期初人数经验上应 ≥10,卡①会统计有多少个“组×区间”单元不达标。
什么时候不要用它
- 事件时点已知到个体、样本量又不算大:用「Kaplan-Meier生存分析」,它不需要划区间,也不需要“删失均匀”这条额外假定。
- 卡①的 K-S 检验提示删失在区间内不均匀:有效风险数的 0.5 校正失效,改用「Kaplan-Meier生存分析」。
- 要同时调整多个协变量:本模块只能按一个变量分组,用「Cox比例风险回归」。
- 存在竞争事件:把竞争事件当删失会高估累积发生率,用「竞争风险模型」。
- 结局没有时间维度、只有发生与否:用「逻辑回归」;只比两组的事件比例则用「卡方检验」。
容易误读的地方
- “时间段结束”默认只到 30,随访更长的部分根本不会进表——这是本模块最容易出错的一处。 示例数据最长随访 69.60,默认参数下寿命表只覆盖到 35.0,有 39 条记录(19.5%)落在覆盖范围之外;此时末行“常规化疗”的累计生存比例是 0.185、“靶向治疗”是 0.535。把“时间段结束”改成 70 之后,同一份数据的末行变成 0.066 与 0.256。也就是说,末行不是随访终点,它只是你设定的区间边界。卡①有一整行“区间设置覆盖随访期”的判定,每次先看它,不满足时按它的提示把结束时间调大。
- 卡④的 HR 与 RMST 不受区间参数影响,只有卡②的寿命表受影响。 上面那两次运行里,HR 都是 0.421(95%CI [0.290, 0.611])、RMST 差都是 15.774(τ=68.00)——它们用的是全部随访数据、与区间划分无关。所以当卡②的末行生存率和卡④的效应量看上去对不上时,先怀疑区间没设够,而不是怀疑统计量算错。
- 组间检验用的是 Breslow(Generalized Wilcoxon),不是未加权的 Log-Rank。 表注写明它按在险人数加权,因而对早期生存差异更敏感;如果研究关注的是长期差异,这个选择会低估你关心的那部分证据,结论应保留余地。卡④的两两比较同样是 Breslow。
- “风险数”不等于期初人数,不要拿它当分母去复核事件率。 它是期初人数减去区间内删失数的一半,示例中“常规化疗”第二个区间期初 92、区间内删失 5,风险数是 89.5。这个 0.5 正是精算法的核心校正,也正是 K-S 检验在查的那条假定。
- 区间划得越细并不越好。 区间过粗会掩盖风险随时间的变化,过细则各区间样本量不足、终止比例 q 会剧烈跳动。卡①专门统计期初人数 <10 的单元数(示例 0 个,最小期初人数 16),卡③的文案也提示读 q 曲线时要结合期初计入数一起看。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(寿命表与整体差异检验)
- 输出结果三:生存曲线与区间风险可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
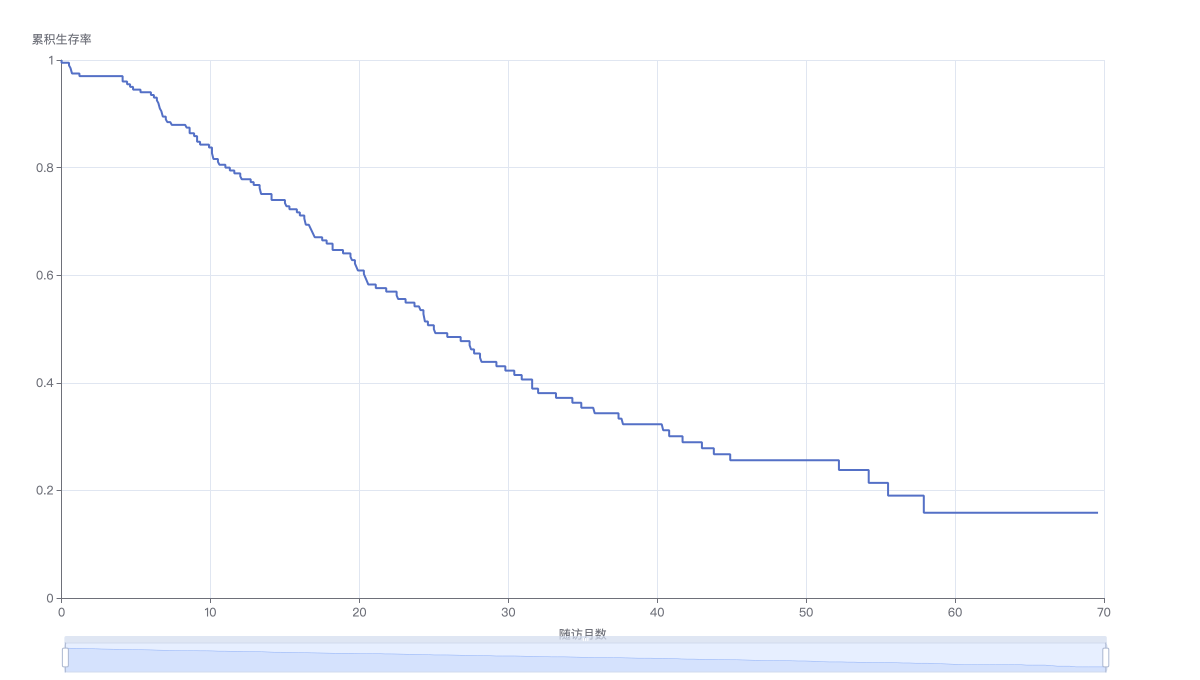
上图展示了全体研究对象的总体生存函数曲线。该曲线基于Kaplan-Meier法(也称乘积极限法)生成,它在每个“事件”发生的时间点重新计算生存概率,因此比固定区间的寿命表法更为精确,是生存分析中最常用的方法。可切换为「表格」查看等距时点的生存率。
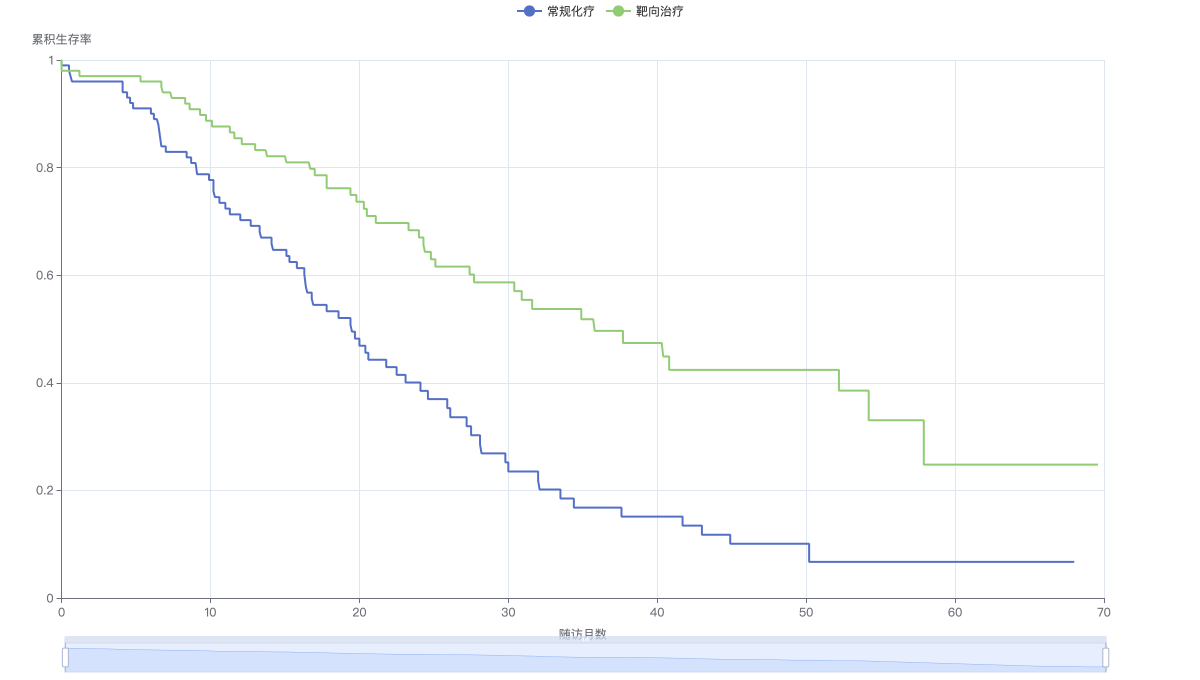
上图根据分组变量“治疗方案”的不同取值,分别绘制了各组的Kaplan-Meier生存曲线。这使得我们可以直观地比较不同组别之间生存模式的差异。
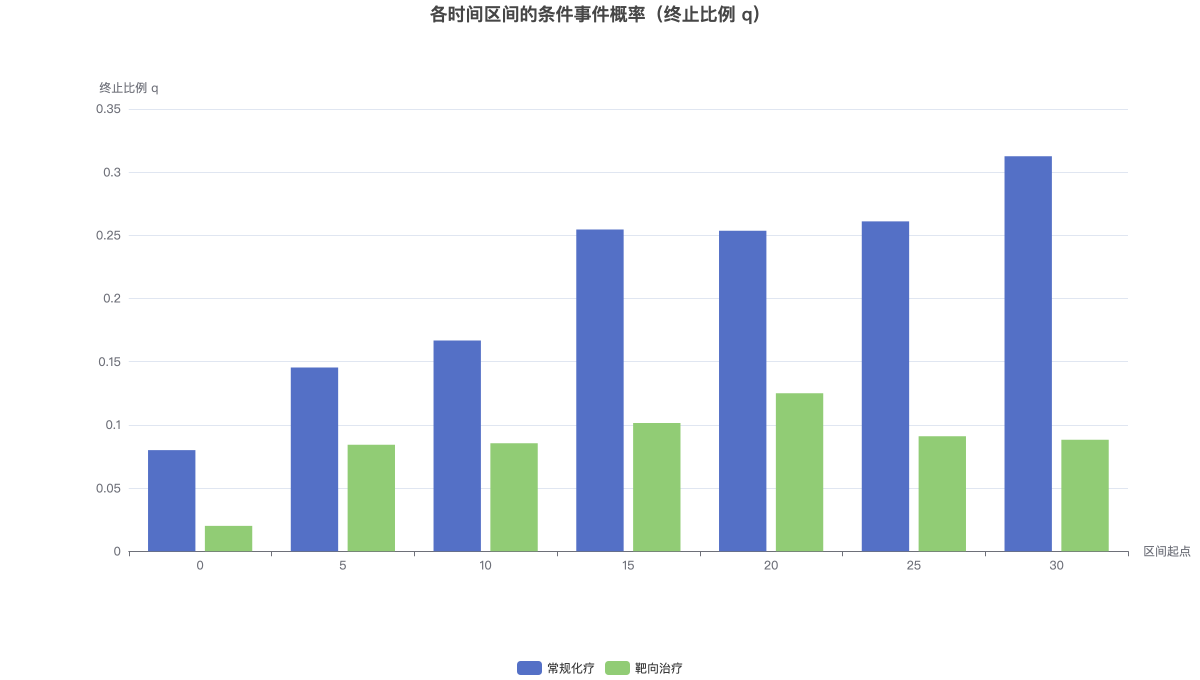
上图为寿命表各区间的条件事件概率 q(在区间起点仍存活者中、于该区间内发生事件的比例),数值直接取自寿命表的「终止比例」列。