
灰色关联分析
这个方法是做什么的
灰色关联分析衡量的是几条序列的折线形状有多接近。你要指定一条母序列(参考序列,不指定时取各特征序列的逐时点均值),其余的是特征序列(比较序列)。序列先做无量纲化,再逐时点算关联系数 ξ(t) = (Δmin + ρ·Δmax)/(Δ(t) + ρ·Δmax),各时点取算术平均即得邓氏关联度,取值域 (0, 1],越大表示与母序列越贴合。
注意本模块排的是特征序列,不是评价对象——它回答“哪个指标与这条综合指数走得最近”,不回答“哪个地区综合表现最好”。除了邓氏关联度,第二张卡还给逐时点的关联系数矩阵(可以看出关联在哪些时点强、哪些时点弱),以及广义关联度三件套:绝对关联度看原始折线的几何相似度、相对关联度看变化速率、综合关联度取两者各半。第一张卡额外放了一张 Pearson r、Spearman ρ 与邓氏关联度的对照表——它们不是同一个概念,演示数据上“人均GDP”的 Pearson r 高达 0.985 却只排关联度第 2(0.686),“医护比”r=0.907 反而以 0.772 排第 1。
需要准备什么数据
- 放入特征序列 [定量] 变量(可选):至少 2 个,定量变量(数值)
- 放入母序列 [定量] 变量(可选):1 个,定量变量(数值)
- 放入索引项 [定类] 变量(可选):1 个,定类变量(分组/标签)
数据要求
- 数据表至少 4 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 想知道一组指标里哪几个与某个总量/综合指数的走势最贴合,用来筛选后续建模要放哪些变量
- 样本量很小、时点很少,做不了需要抽样分布的推断方法
- 数据信息不完全、只想要一个可解释的相似度排序,不追求显著性结论
- 需要同时从“折线形状”和“变化速率”两个角度交叉验证同一个结论
前提是每条序列的首个观测值不得为 0(初值化与相对关联度以首值为基准),选“均值化”时还要求均值不为 0;序列长度建议不少于 4 个时点。第一张卡会把这两个条件逐条打勾核给你看。
什么时候不要用它
- 你要排的是评价对象而不是指标:用「优劣解距离法(TOPSIS)」「多准则妥协解排序法(VIKOR)」或「秩和比综合评价法(RSR)」,它们的输出才是对象名次。
- 你需要 p 值、置信区间或“显著相关”这样的结论:改用「Pearson相关性分析」或「Spearman相关分析」,本方法没有原假设,也没有抽样分布。
- 你要的是一套可用于加权求和的指标权重:用「熵值法」「CRITIC权重法」或「变异系数法」。
- 你想量化一个变量对另一个变量的影响大小并做检验:用「线性回归 (最小二乘法)」。
- 数据是等间隔时间序列,你要做的是外推预测:用「灰色预测模型GM(1,1)」或「时间序列分析(ARIMA)」。
- 你想按走势把序列分成几组,而不是排序:用「聚类分析(K-Means)」。
容易误读的地方
- 换一种无量纲化方式,第一名会换人。 同一份演示数据实测:均值化下“医护比”以 0.7717 居首;改成“不处理”后“人均GDP”以 0.9174 反超,医护比退到第 2。第四张卡的对照行也报了这次易位(Spearman ρ 掉到 0.5000)。三种方式的含义不同——初值化强调增长倍数、均值化强调相对水平、不处理保留原始量级——必须按研究问题选,并在文中写明,不能试到顺眼为止。
- 分辨系数 ρ 改的是数值刻度,不是次序。 演示数据上 ρ 从 0.5 降到 0.1,“科研经费”的关联度从 0.6536 掉到 0.2418,看着像“关联变弱了”,但五档 ρ 的排序 Spearman 全是 1.0000。ρ 越小各序列被拉得越开、越容易区分,这是尺度效应。所以关联度的绝对数值跨研究不可比,能拿去比较的只有同一份设定下的相对排序。
- 关联度高不等于相关系数高,反过来也一样。 灰色关联度比的是折线的逐点接近程度:一条与母序列完全平行、只是整体高出一截的序列,Pearson r 可以是 1,关联度却不会高。第一张卡把两套指标并排放在一起,就是为了让这种分歧显形;看到分歧不要挑对自己有利的那个报。
- 邓氏关联度与综合关联度的排序可能不一致。 演示数据上两者的 Spearman ρ 只有 0.5000。这不是算错:前者看逐点差异,后者看整体几何形状与变化速率。分歧说明序列之间“接近的方式”不同,应结合第二张卡的关联系数矩阵与曲线一起解读,而不是只报其中一个。
- 不指定母序列时,量级最大的那个指标几乎注定夺冠。 母序列区留空,系统会用各特征序列的逐时点均值合成一条“均值母序列”,而这条均值取自原始值、未做无量纲化:演示数据里“科研经费”的均值是 180,另两个是 9.5 和 0.95,合成序列基本就是科研经费本身——实测它与母序列的 Pearson r=1.000、关联度 0.9634 稳居第一。这不是发现,是算术。母序列必须由你按研究问题指定,并把选取依据写进方法部分。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:灰色关联度主结果表
- 输出结果三:可视化(关联度排序图与关联系数曲线)
- 输出结果四:分辨系数与无量纲化方式的敏感性分析
- 输出结果五:结论与学术表述
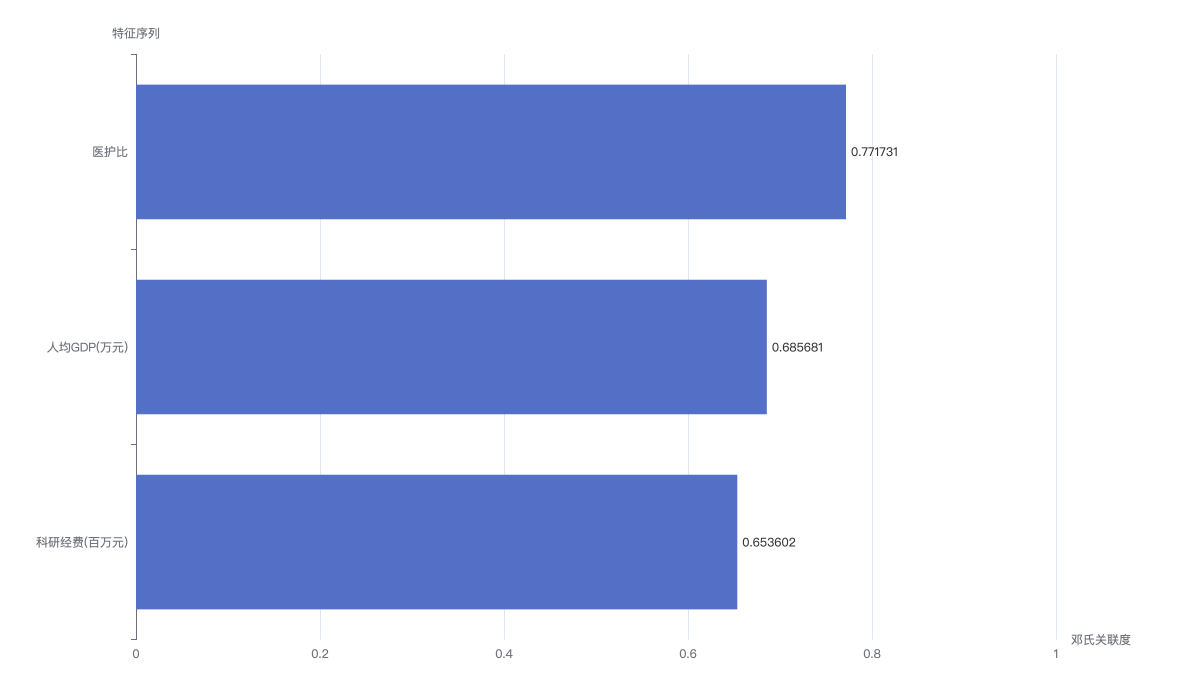
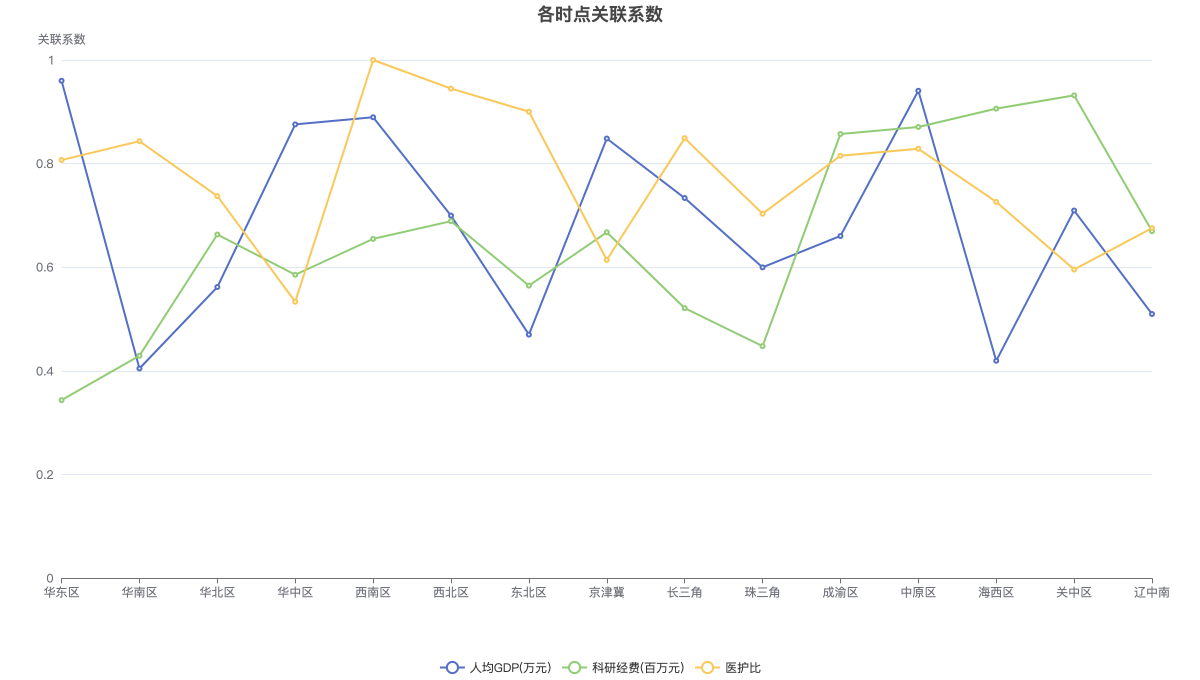
上图按邓氏关联度排序(关联最强的序列位于最顶端,可切换柱形图/折线图/表格视图);下图展示各特征序列的关联系数随时点的变化。