
典型相关分析
这个方法是做什么的
回答“一组 X 变量与一组 Y 变量之间的整体关联有多强”。做法是在 X 组里找一个线性组合、在 Y 组里也找一个线性组合,让这一对组合之间的相关最大——这就是第 1 对典型变量,它们的相关系数记作 r_c;然后在“与前面各对都不相关”的约束下再找第 2 对,依此类推,最多能提取 min(p, q) 对,p、q 是两组各自的变量个数。
除了各对的 r_c 与 r_c²,报告给出 Wilks' Λ 序贯检验(决定该保留几对)、r_c 的 Bootstrap 95% 置信区间、用于解释各典型维度含义的结构矩阵(载荷)与交叉载荷,以及两个方向的冗余度 Rd(Y|X) 与 Rd(X|Y)——它们才回答“一组变量能解释另一组多少方差”。前提部分逐变量做 Shapiro-Wilk 检验,分别给出两组各自相关矩阵的行列式、条件数与最大 VIF,并用 Mahalanobis 距离筛查多元异常值。
需要准备什么数据
- 集合 Y 变量:至少 2 个,定量变量(数值)
- 集合 X 变量:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 一组工作环境指标与一组心理健康指标之间的整体关联
- 问卷里两个多维量表(各自三五个维度)之间的关系,不想做几十次两两相关
- 一组生理指标与一组行为指标之间是否存在若干条同步变化的通道
- 需要给“X 组的哪几个特征与 Y 组的哪几个特征一起变”这条通道命名
两组都必须是定量变量,每组至少 2 个,且两组不能重叠——同一个变量同时放进 X 和 Y 会人为制造出完美的典型相关,这一条在入口就被拦住了。因为要对两组各自的相关矩阵求逆,组内不能有常数列或完全共线的变量。样本量必须大于两组变量数之和,经验规则是 N ≥ 10 × (p + q),卡① 会直接把这个比值算给你;比值太低时典型相关系数会被严重高估,载荷也复制不出来。
什么时候不要用它
- Y 组只有一个变量:此时典型相关分析退化为多元回归,直接用「线性回归 (最小二乘法)」,结果更好读也更好报告。
- X 组其实是分组变量的哑变量(想比较几组人在一批指标上的差别):那是组间差异问题,用「多变量方差分析」或「线性判别分析」。
- 你只想知道某两个具体变量之间的关系强度:用「Pearson相关性分析」,它一次拖入多个变量会把所有两两组合都算一遍,并对这些检验做多重比较校正。
- 你想控制住某几个变量之后再看两个变量的关联:用「偏相关分析」。
- 目的是用 X 组预测 Y 组,而变量多、样本少或组内共线严重:用「偏最小二乘回归(PLSR)」。典型相关分析要对相关矩阵求逆,共线一严重,典型系数就会剧烈波动。
- 你只有一组变量、想把它压成几个综合维度:用「主成分分析(PCA)」或「因子分析(探索性)」。
容易误读的地方
- 它不是“把两两相关做很多次”,而且比后者更容易高估。 两两相关是拿现成的变量去算;典型相关是先在两组里各自搜索出一个让相关最大的线性组合,再报告这个最大值。这个最大化过程本身就会把噪声吃进去——样本量不足时,即使两组毫无关系也能凑出很高的 r_c。所以判断“有没有关联”一律以 Wilks' Λ 序贯检验为准,并对照卡① 给出的 N/(p+q) 是否达到 10。反过来,如果你真正关心的只是某几对具体变量之间的关系,做两两相关加多重比较校正更直接,也更容易讲清楚。
- 这里的 Bootstrap 置信区间不能用来判断显著性。 r_c 按定义非负、又是取最大值得到的,它的重抽样分布几乎不可能覆盖 0,所以“区间不含 0”在这里不构成任何证据。示例把这一点演示得很清楚:第 1 对 r_c = 0.265,Bootstrap 95%CI 是 [0.215, 0.450],不含 0,而 Wilks' Λ 检验的 p = 0.404,完全不显著。区间的用途只是刻画估计精度——越宽说明典型结构越不稳定。
- 序贯检验要从第一行往下读,在第一个不显著处停止。 第 i 行的 Wilks' Λ 检验的是“第 i 对及其之后的所有典型相关是否全部为 0”,而不是单独检验第 i 对。所以不能挑着看,更不能因为第 3 对的 p 小就说第 3 对有意义。第 1 对就不显著时,后面的载荷与冗余度只能当探索性描述,不能写进结论。也正因为这些假设是层层嵌套而非并列的,报告里没有做 Holm 或 Bonferroni 校正——那类校正针对的是并列假设,用在这里是错的。
- r_c 高不等于一组能解释另一组多少。 r_c 只说明两个综合维度之间相关,而这两个综合维度各自可能只代表本组的一小块方差。真正回答“解释了多少”的是冗余度:Rd(Y|X) = 该典型变量的组内自解释率 × r_c²。r_c 很高而冗余度极低是常见现象,它说明关联只发生在两组各自的一小块方差之间。冗余度还是不对称的,Rd(Y|X) 与 Rd(X|Y) 必须分别报告——只报 r_c 不报冗余度,是典型相关分析最常见的报告缺陷。
- 解释典型维度要看载荷,不要看典型系数。 典型系数是权重,组内变量存在共线性时极不稳定,换一批相似的数据连符号都可能翻;载荷(结构系数)是原始变量与本组典型变量的 Pearson 相关,稳健得多,惯例上 |载荷| ≥ 0.30 才算对该维度有实质贡献。还有一层边界:典型相关分析是对称的关联分析,不区分自变量与因变量,“集合 X”“集合 Y”只是两个拖拽区的名字,对调之后 r_c 不变,因此它更不能用来推断因果方向。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:整体模型检验(主结果表)
- 输出结果三:典型相关可视化
- 输出结果四:效应量、载荷与冗余度分析
- 输出结果五:结论与学术表述
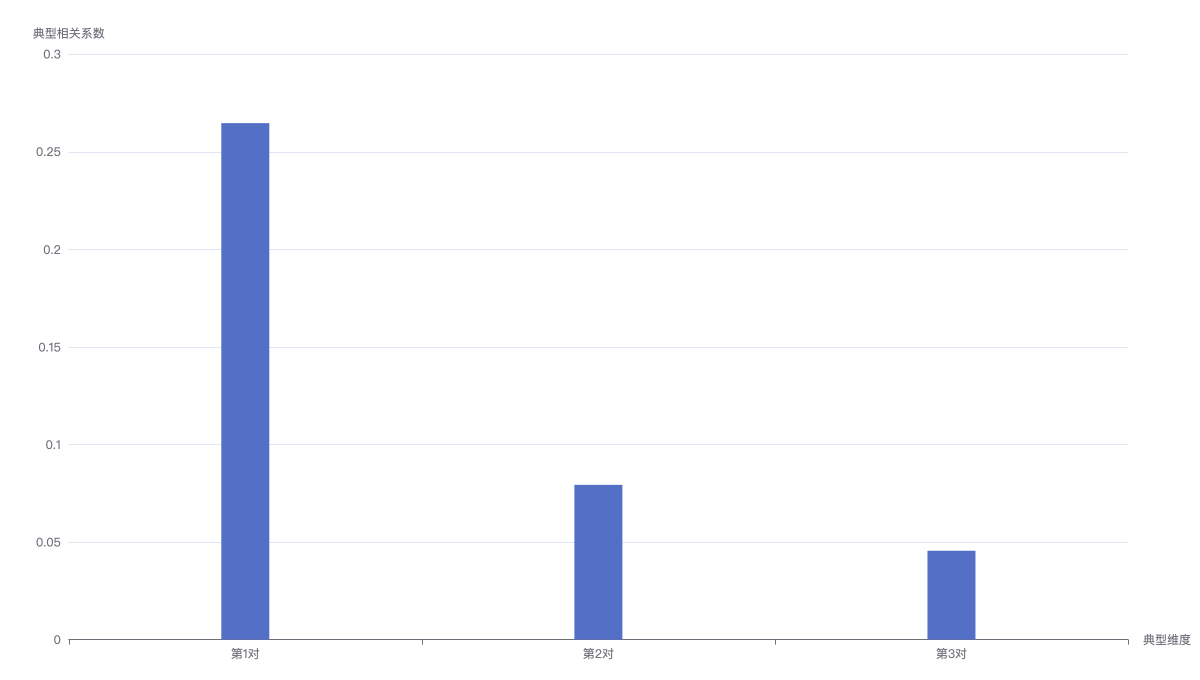
每根柱为该对典型变量之间的典型相关系数 r_c(第 1 对最强,依次递减)。
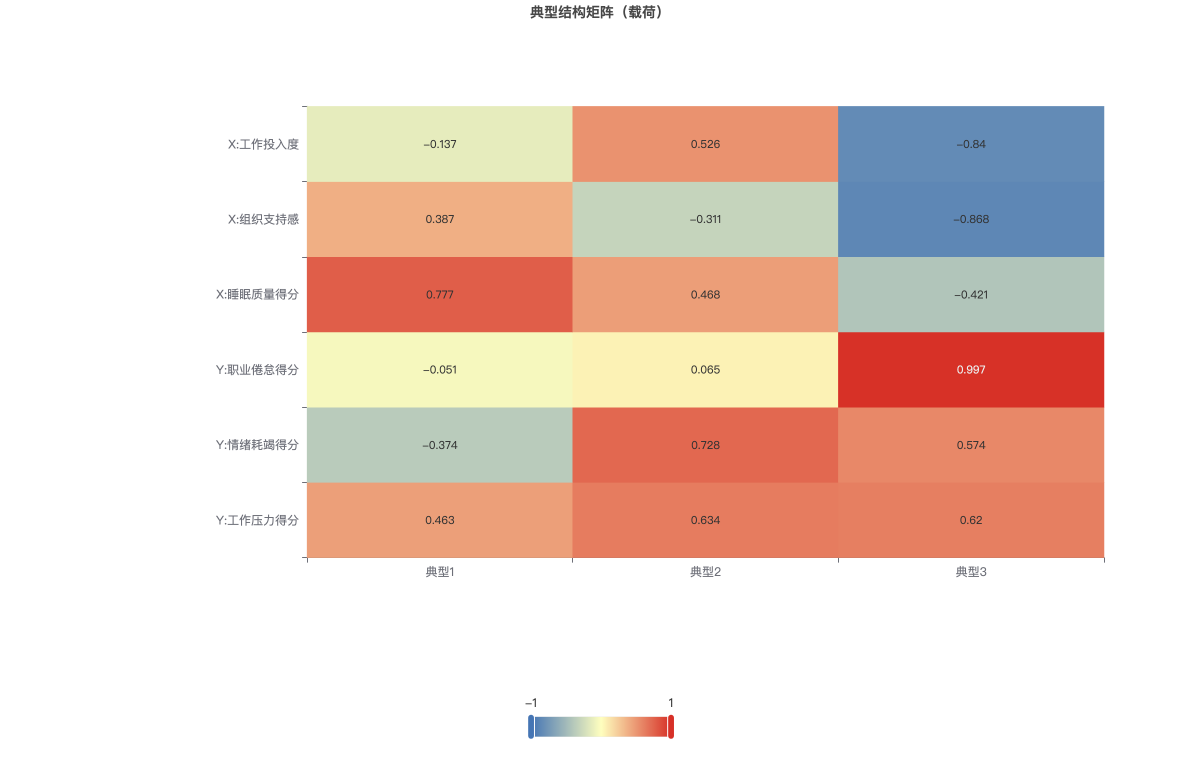
该热力图为典型结构矩阵:Y 组变量显示其与 Y 典型变量的载荷,X 组变量显示其与 X 典型变量的载荷;颜色越红/越蓝表示正/负载荷越强。