
优序图法 (TOPSIS)
这个方法是做什么的
这是“优序图赋权 + TOPSIS 排序”的组合。名字里虽然带 TOPSIS,权重却不是熵权算出来的:它把各指标的平均值两两比较,A 的均值大于 B 就给 A 记 1 分、小于记 0 分、相等或与自身比较记 0.5 分,行和就是该指标的 TTL 得分,归一化后即为权重。随后进入 TOPSIS:先做向量归一化 x/√(Σx²)(注意不是 min-max),加权后计算各对象与正、负理想解的欧氏距离 D+、D−,按贴近度 C = D−/(D+ + D−) 排序。
报告里最该先看的不是名次,是第二张表的优序矩阵——它把“权重从哪来”摊开给你看。由于矩阵里每一格只能取 0、0.5、1,作为行和的 TTL 落点也很有限(3 个指标时 TTL 只能是 0.5、1.5、2.5,对应权重 11.1%、33.3%、55.6%),而且它只由均值的大小次序决定,不反映均值差距有多大:两个均值相差 1% 和相差 100 倍,在这个矩阵里得到的是同一个 1 分。第一张卡还会算出各指标均值绝对值的最大/最小比(演示数据上是 189.47)并给出警示:本方法的权重来自均值比较,量纲大的指标会自动拿到高权重。第四张卡做权重 ±20% 扰动与等权对照的排名稳定性检验。报告页顶部的标题写的是“均值比较赋权TOPSIS分析报告”,与菜单里的名字不同,指的是同一个方法,不必怀疑点错了模块。
需要准备什么数据
- 分析项(定量):至少 2 个,定量变量(数值)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 指标已经化到同一尺度(都是百分制、都是比率、或都已无量纲化),只想用一个极简、可手算复核的规则定权重
- 希望权重的来龙去脉一眼看得懂,方便向非统计背景的评审解释
- 全部指标都是“越大越好”,不需要区分成本型
- 想在贴近度之外,用优序散点图同时看到每个对象的 D+ 与 D− 结构
前提有两条,程序都无法自动验证,只能在第一张卡里显式声明并提醒:所有指标已同向化为正向;各指标均值处于可比尺度。报告不会替你识别指标方向,也不对方向的正确性作任何保证。分析项区至少要放 2 个定量指标,零方差的常数指标会被自动剔除。
什么时候不要用它
- 指标里有成本型(越小越好):本模块没有负向指标区,一律按效益型处理;改用「优劣解距离法(TOPSIS)」,它有独立的正向区与负向区。
- 各指标量纲差异悬殊:均值大的指标会凭量纲拿走高权重,报告本身也建议改用不依赖均值尺度的客观赋权法,如「熵值法」或「CRITIC权重法」。
- 需要在报告里用名称标识评价对象:本模块只按“行索引”标识,要带对象名称请用「优劣解距离法(TOPSIS)」或「秩和比综合评价法(RSR)」,它们有索引项拖拽区。
- 希望权重反映指标的区分能力而不是平均水平:用「变异系数法」或「独立性权系数法」。
- 不想只报一个第一名,而要给出妥协解集合:用「多准则妥协解排序法(VIKOR)」。
容易误读的地方
- 权重高不代表这个指标重要,只代表它的均值大。 演示数据里“科研经费”拿到 55.556% 的权重,仅仅因为它的均值是 180、比另两个指标都大;把它除以 100 换个单位,权重立刻会掉下来。这条不是使用不当,是方法本身的定义——所以进本模块之前必须先把指标化到可比尺度。
- 向量归一化不会把数据压进 [0,1]。 与「优劣解距离法(TOPSIS)」的 min-max 不同,x/√(Σx²) 只保持列内比例关系,对极端值更敏感:一个特别大的对象会同时压低同列其他所有对象的归一化值。两个模块名字都叫 TOPSIS,贴近度却不可互相比对。
- ±20% 权重扰动检验不到“均值次序判错了”。 第四张卡的表注专门说明了这一点:扰动检验回答的是“权重略有偏差时名次会不会翻”,而权重的真正来源是均值的大小次序。若某两个指标的均值非常接近,它们的优序判定本身就在临界上,这时要重点看等权对照那一行——演示数据里等权对照的 Spearman ρ 掉到 0.9036、有 8 个对象名次变动,是全部 7 个情景里唯一明显的偏离。
- C 恰好等于 0,说明该对象在每一个指标上都垫底。 演示数据里第 12 行的 D− 是 0.000000、C 是 0.0000——回原始表可以核到,它的三项指标同时是本批最小值,于是与负理想解完全重合。这是相对位置而非绝对评分:只要有对象样样垫底,它的 C 就必然是 0,与它的真实水平高低无关。同理,最优对象的 C 也未必是 1(本次是 0.9841),因为它并非在每一项上都拿到最大值。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:权重与综合评价主结果表
- 输出结果三:可视化(贴近度排序图与优序散点图)
- 输出结果四:权重敏感性与排名稳定性
- 输出结果五:结论与学术表述
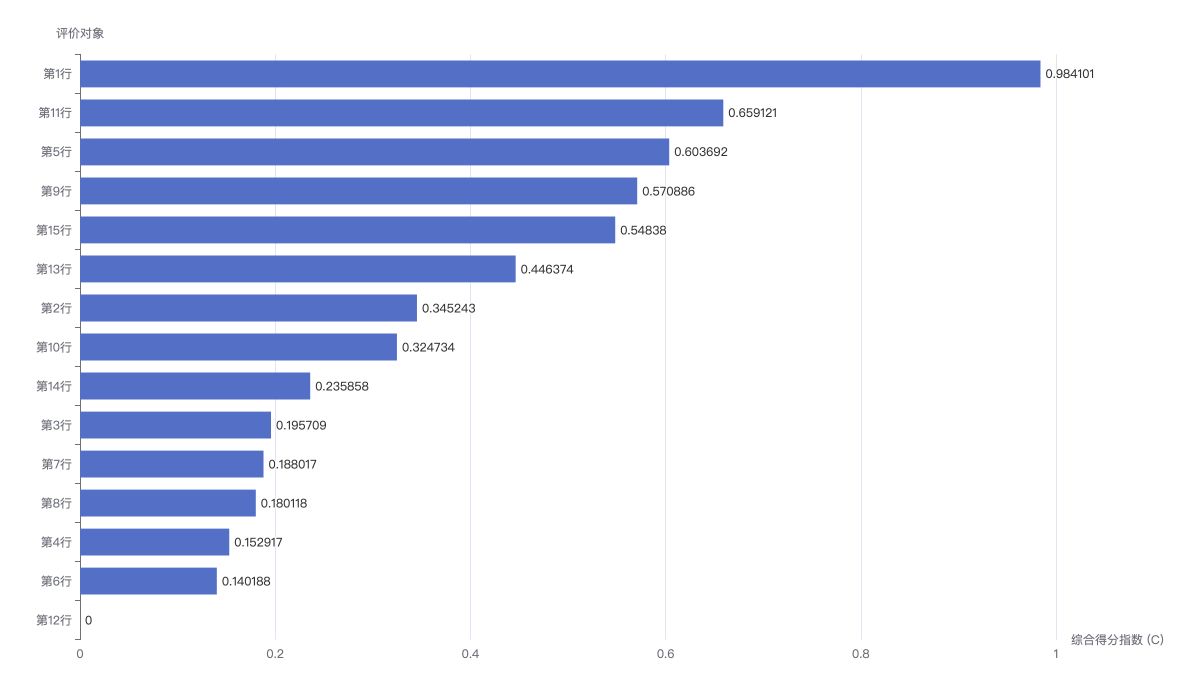
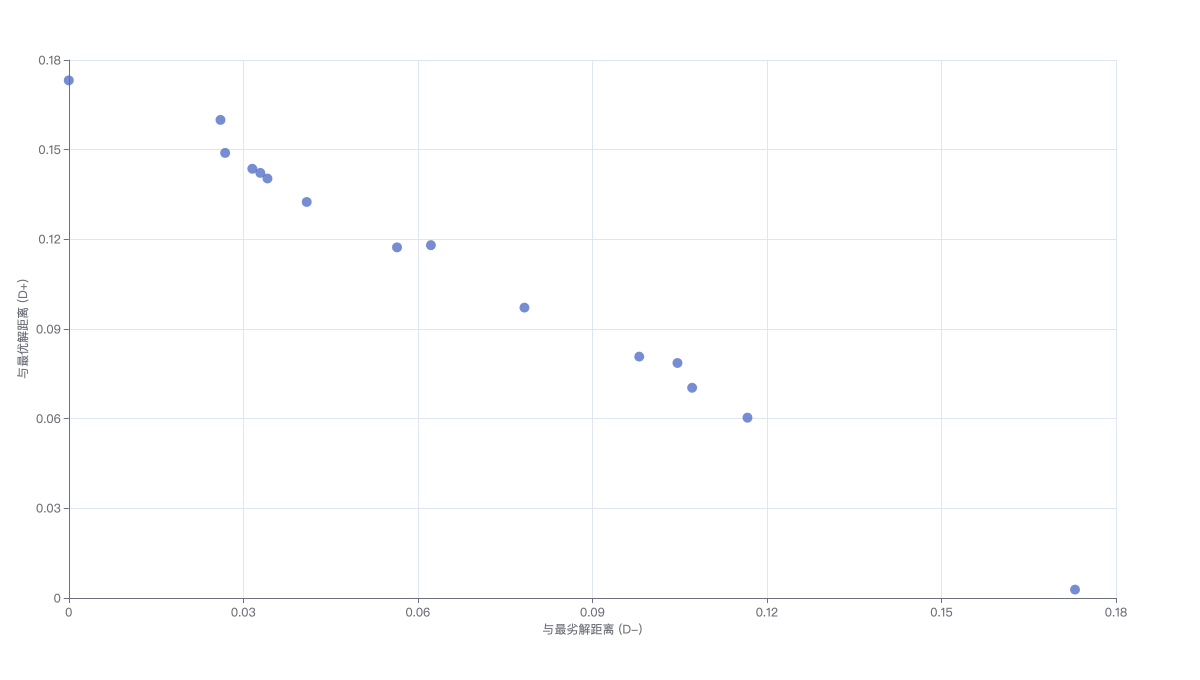
上图为贴近度排序(最优在最顶端,可切换柱形图/折线图/表格视图);下图为“优序图”,每个点由与最劣解距离(D−)和与最优解距离(D+)确定。