
MaxDiff最大差异分析
这个方法是做什么的
在一组项目里反复给受访者看几个,每次要求同时挑出“最重要的一个”和“最不重要的一个”,据此得到项目之间的相对偏好次序。它的价值在于强制取舍:直接用重要性量表打分时,人人都把所有项目打成 4 分 5 分,什么都排不出来;两端选择把这个天花板拆掉了。本模块用的是计数法(counting):每个项目一列,单元格只能填 +1(本轮被选为最好)、−1(被选为最差)、0(展示了但没被选中),净计数得分 =(最好次数 − 最差次数)÷ 出现次数,取值域 [−1, 1]。
除了排名,报告给这几样:每个项目净得分的标准误、95%CI(截断到定义域内)与“是否显著偏离中性 0”的 t 检验;缩放效用 =(净得分 + 1)÷ 2 × 100,把得分线性映射到 0–100(50 为中性);Friedman 配对秩检验回答“项目之间整体上是不是真有偏好差异”,Kendall's W 衡量受访者彼此的排序有多一致;以及 Wilcoxon 符号秩加 Bonferroni 校正的项目两两比较,附秩二列相关 r。卡① 先查四件事:编码是否合法、各项目展示次数是否均衡(χ² 拟合优度)、Best 与 Worst 总数是否平衡(二项检验)、完全区组样本够不够做配对检验。
需要准备什么数据
- 放入[定量]待测项目列:至少 3 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 从十几条卖点、功能或诉求里挑出最该主推的那几条
- 重要性量表打分全挤在高分段、分不出优先级时,改用强制取舍
- 需求排期、内容选题、权益清单这类“必须排个先后”的场景
- 已按 Best-Worst 设计做好问卷、回收后需要汇总的分析
前提:至少 3 个项目列,每列取值只能是 +1/0/−1,数据不少于 30 行。最关键的一条是各项目的展示(出现)次数应近似均衡——净得分的分母就是出现次数,展示次数不同的项目之间没有可比性,卡① 用 χ² 拟合优度专门检验它。缺失被当作“该项目本行未展示”处理,不计入分母。
什么时候不要用它
- 需要个体级效用或份额模拟(share of preference):计数法只给总体层面的相对排序,不产生每个人的效用值,卡① 和卡⑤ 都写明了这一点。要处理人群内部的偏好分化,先用「聚类分析(K-Means)」或「二阶聚类」把受访者分群,再按群逐一汇总净得分;想看偏好差异是否与年龄、渠道这类人群变量有关,用「列联(交叉)分析」。
- 想知道各选项被多少人选中的绝对比例:MaxDiff 给不出“多少人喜欢它”,只给相对次序。选项分布与勾选比例用「多选分析」或「频数分析」。
- 要比较的是属性水平之间的取舍(价格 199 还是 299、64G 还是 128G):那是水平层面的效用,用「联合分析(Conjoint)」。
- 想给功能做需求属性归类(不做会挨骂 / 做了才有惊喜):用「Kano模型」;想找几个项目组合起来覆盖最多人,用「TURF触达频次分析」。
- 数据是李克特打分而不是 +1/0/−1 三值编码:本模块只认三值编码,量表分会被判为非法取值。想比较同一批人对几道题的平均分,用「多配对样本Friedman检验」或「重复测量方差分析」。
容易误读的地方
- 净计数得分是相对量,读成“绝对重要性”就错了。 示例里“续航时间”得 0.42,只说明它在这份清单的 5 个项目中更常被选为最好。往清单里加一个更差的项目,其余项目的得分会集体上移;删掉最差的那个,全体下移。所以 MaxDiff 的数字不能跨问卷比较,也不能说“续航的重要性是售后的两倍”——它连比例尺度都算不上。缩放效用那一列看着像百分制,其实只是净得分的线性变换,同样是相对量。
- 排名相邻的两项未必真有高下。 主结果表按净得分排序,但排序本身不带不确定性。要判断谁更受偏好,得看两项的 95%CI 是否重叠,以及卡④ 里 Bonferroni 校正后的 Wilcoxon 结果。示例中“拍照质量 vs 屏幕素质”未校正 p=0.2792、校正后 p=1.0000——这两项在数据上分不出先后,尽管它们的排名一个第 2、一个第 3。按名次切一刀说“前三名做、后两名砍”,很可能是在切噪声。
- Friedman 显著和 Kendall's W 很低可以同时成立,而且后者更该管你的决策。 示例里 Friedman χ²(4)=141.45、p<0.001,但 W 只有 0.177,判定写的是“几乎无一致性”。这不矛盾:Friedman 说项目之间确有差异,W 说受访者内部对次序的意见分歧很大。W 低的时候,总体排名代表的是一个并不存在的“平均人”,照它做决策会同时得罪几个偏好相反的细分人群。此时应先看卡③ 里 Best 和 Worst 两根柱都很高的那些“两极分化”项目,再按人群细分重跑。
- 展示次数不均衡时,净得分不能横向比。 分母不同会让各项目的估计精度差一大截,卡① 的 χ² 拟合优度就是为此而设。示例里五个项目都出现 200 次、p=1.0000,所以可以直接比;如果这一项报“不均衡”,正确动作是回去修实验设计,而不是硬读排名,因为此时的名次里混着设计造成的偏差。
- Best 与 Worst 总数不相等是数据问题,不是发现。 示例的二项检验给出 Best=287、Worst=226、p=0.0080,判定写的是“提示部分轮次只选了一侧或数据录入不完整”。理论上每一轮都各选一个最好、一个最差,两者总数应大致相等。这条红了要回去查问卷逻辑或导出脚本——把它读成“大家更愿意选最好的”,等于把一个录入缺陷写成了一条结论。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:项目重要性排名与净计数得分检验
- 输出结果三:可视化(效用排序与 Best/Worst 构成)
- 输出结果四:效应量与事后多重比较
- 输出结果五:结论与学术表述
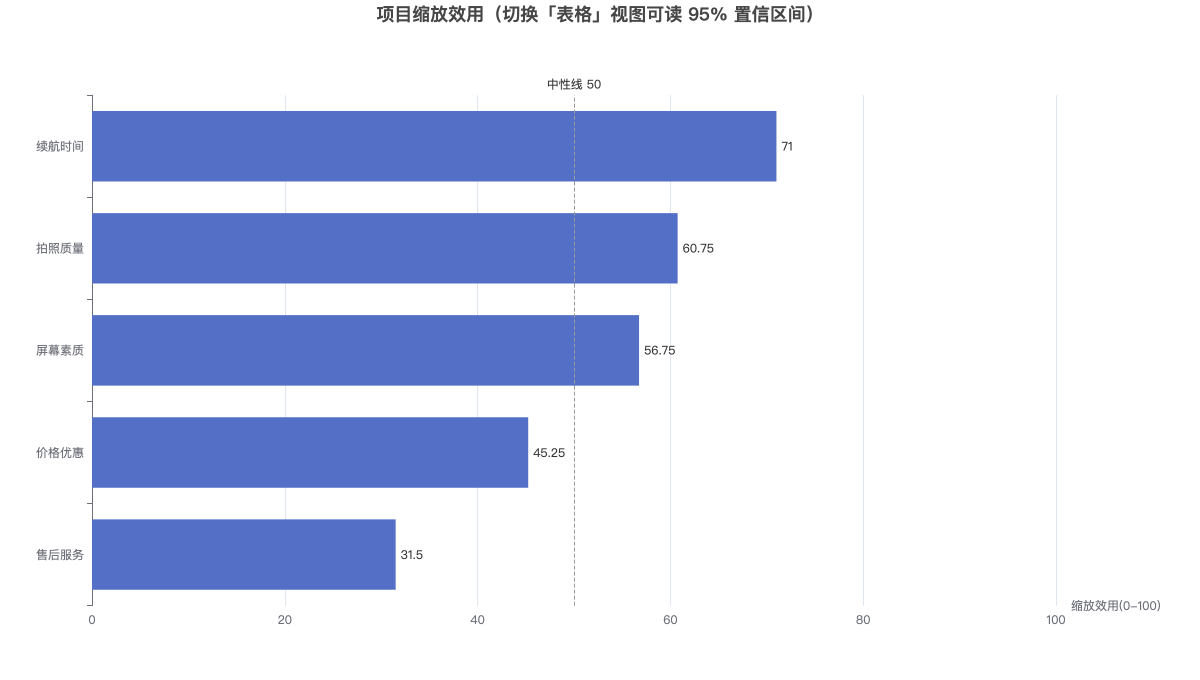
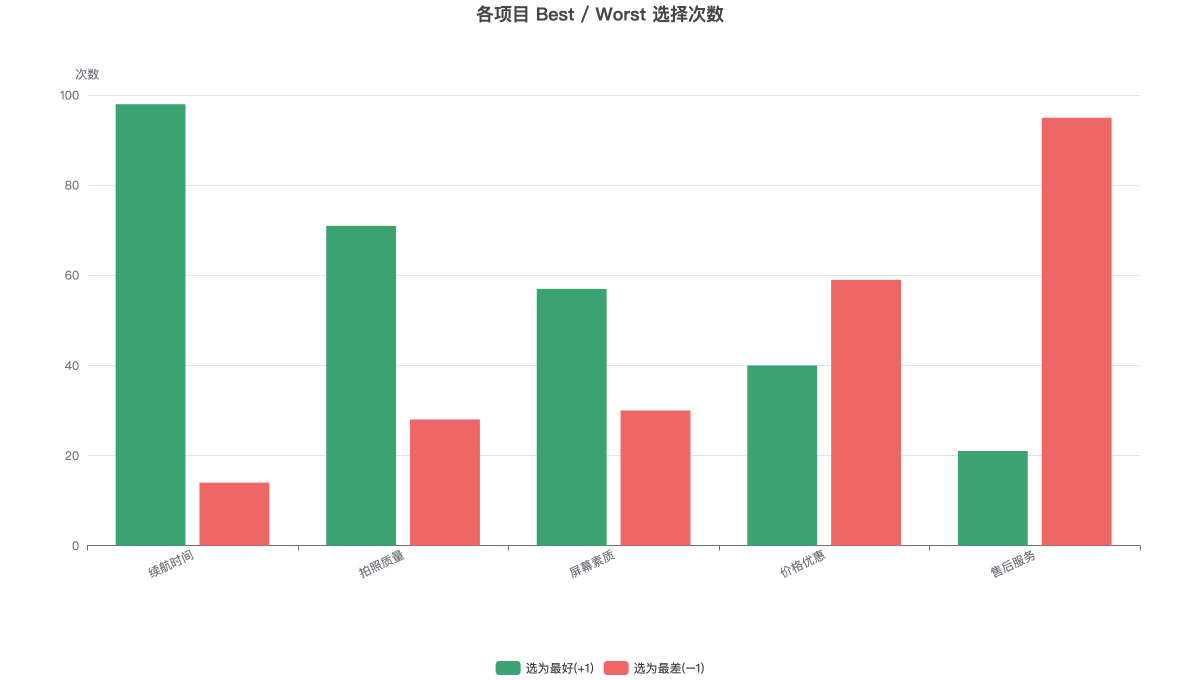
上图为项目缩放效用条形图(切到「表格」视图可读取每个项目的 95% 置信区间上下限),下图为 Best/Worst 选择次数的对照。