
莫兰指数(全局+局部LISA)
这个方法是做什么的
回答“这个变量在地图上是不是扎堆”。每行是一个带坐标的空间单元,本模块先按 K 近邻构造空间权重矩阵 W 并作行标准化,再算全局 Moran's I:它本质上就是“标准化观测值 z”对“邻居加权平均值 Wz”的回归斜率,所以 Moran 散点图那条拟合线的斜率恰好等于 I。I 显著高于其期望值即为正空间自相关(高值挨着高值、低值挨着低值)。
全局 I 只说“整体有没有聚集”,局部 LISA 回答“聚集在哪里”:每个点各做一次 999 次条件置换检验,按局部 I_i 的符号与自身取值归入高-高、低-低、高-低、低-高四个象限。报告同时给出未校正与 Benjamini-Hochberg 校正两套显著点计数、|I_i| 最强的显著点清单、按象限着色的地理散点图与 Moran 散点图,以及 Geary's C 作对照。本模块特有的着眼点是:同一个原假设它并排给了三套推断——999 次条件置换(不依赖分布假设,是主推断)、正态近似、随机化近似——三者一致时结论才最稳。
需要准备什么数据
- 放入[定量]分析变量:不限
- 放入[定量]经度/X坐标:不限
- 放入[定量]纬度/Y坐标:不限
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 15%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 房价、发病率、人均 GDP 这类带经纬度或投影坐标的空间数据,先判断有没有空间聚集
- 定位热点、冷点,以及“高值被低值包围”这种空间异常单元
- 上空间计量模型之前的第一步诊断
- 想要一个无量纲、可跨研究比较的空间聚集强度指标
前提是分析变量、经度/X、纬度/Y 三列必须是三个不同的定量列,且至少要有 2 个坐标互不相同的点、不能全部重合,否则邻接关系建不起来。分析变量不能是常数列(无空间变异则 I 无定义)。经纬度须为十进制度(本模块对经纬度按大圆弧距求近邻);若用投影坐标(米 / 千米),两列量纲必须一致。
什么时候不要用它
- 要估的是空间溢出效应而不只是描述格局:邻居的因变量影响本地用「空间滞后模型(SLM/SAR)」;溢出体现在误差项里用「空间误差模型(SEM)」;邻居的自变量也有溢出用「空间杜宾模型(SDM)」。
- 只有行政区名、没有坐标:先补上质心坐标再回来;若只想比较各地区取值的高低,用「分类汇总」。
- 关注的是时间上的自相关而不是空间上的:用「(偏)自相关分析」。
- 想按取值把空间单元分群:普通聚类不使用邻接结构,用「聚类分析(K-Means)」;要按密度找簇用「密度聚类(DBSCAN)」。
- 想看两个变量在空间上是否同涨同落:本模块的分析变量区只收 1 列,先用「Pearson相关性分析」看整体关联,再分别跑两次莫兰指数。
容易误读的地方
- 置换检验的 p 值有地板,0.0010 是它能给出的最小值,所以主推断那一行永远拿不到三颗星。 伪 P 值 = (置换中不低于观测 I 的次数 + 1) / (999 + 1),最小就是 1/1000。按报告采用的三档星号,0.001 落在 p<0.01 这一档。实测同一份数据里,条件置换那一行写的是 0.0010(两颗星),正态近似那一行写的是 <0.001(三颗星)——星数不同不是两种推断结论冲突,只是置换法的分辨率到 0.001 为止。引用时应写“伪 P 值 = 0.001(999 次置换)”,不要写成“p 恰为 0.001”。
- 换一个空间权重矩阵,I 值与热点数量都会变,而本模块只提供一种 W。 第一张卡的表注逐字写着“空间权重矩阵是空间自相关分析的核心设定:换一种 W(如距离阈值、Queen 邻接)结果会变,报告时必须写明 W 的构造方式”。本模块固定用 K 近邻、k = min(8, n−1)、行标准化,没有可调开关。所以论文里必须写清“KNN(k = 8) 行标准化”而不能只写“计算了莫兰指数”;要做 W 的敏感性分析,本模块给不了,得换空间计量模块或外部工具。
- I 的期望值不是 0,判正负自相关要跟 E[I] 比而不是跟 0 比。 行标准化之后 E[I] = −1/(n−1) 恒成立,实测 n = 100 时 E[I] = −0.0101。所以一个略小于 0 的 I 仍可能落在正自相关一侧。第二张卡的“空间自相关方向判定”那一行把依据写了出来:同时列出 p_sim、I 与 E[I],正是提醒你比较的对象是 E[I]。
- LISA 一口气做了 n 次检验,未校正的热点数会明显偏多。 实测 n = 100 时未校正 55 个显著点、BH 校正后 48 个,结论文案据此说“未校正显著 55 个点中,有 7 个在控制 FDR 后不再显著,说明其中相当一部分可能是多重检验带来的假阳性”;表注还提醒纯随机数据也会有约 5%(约 5 个)点“显著”。报告热点数时必须写明用的是哪一种口径——两种口径下的数量可以相差很多,尤其在 n 大而信号弱的数据上。
- Moran's I 说得了“扎堆了”,说不了“为什么扎堆”。 第五张卡的解释边界写明:它不能区分“真实的空间交互(溢出)”与“共同的空间趋势/遗漏变量”。相邻城市房价都高,可能是彼此带动,也可能只是都靠海、都在同一条经济带上。要把这两种机制分开,必须转到空间计量模型去估溢出参数,全局 I 本身不构成任何因果解释。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:全局空间自相关检验
- 输出结果三:LISA 空间聚集分布图与 Moran 散点图
- 输出结果四:效应量与局部事后分析
- 输出结果五:结论与学术表述
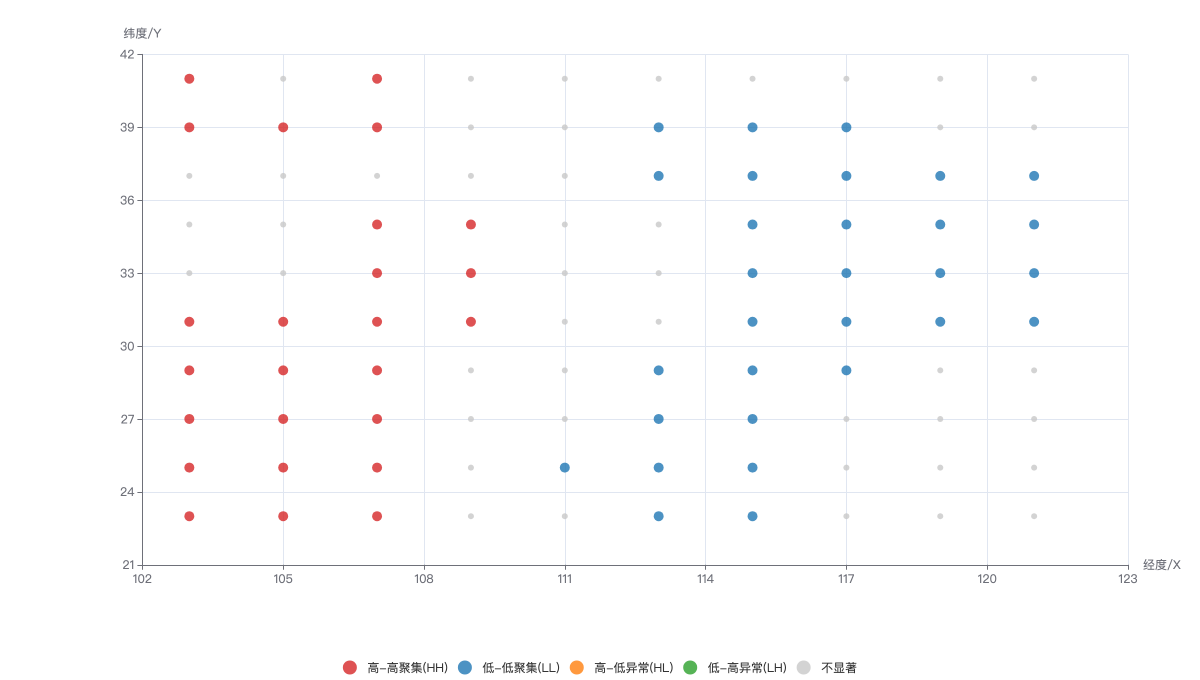
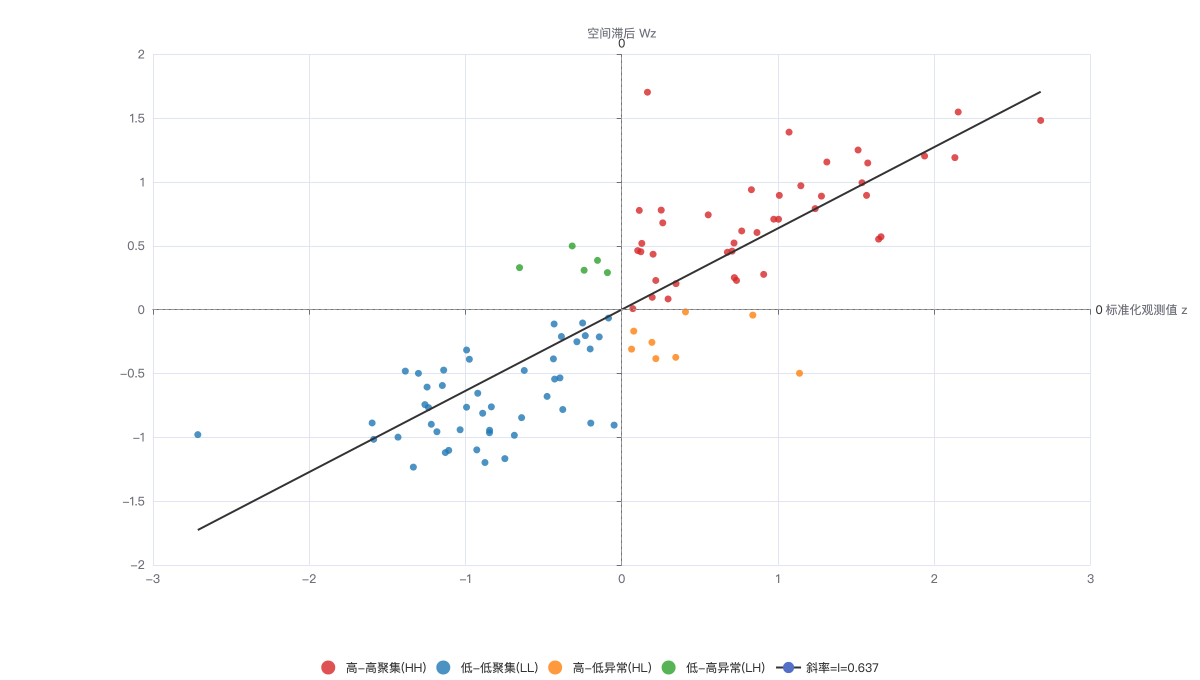
上图为按 LISA 象限着色的地理散点(红=高-高热点、蓝=低-低冷点、橙=高-低、绿=低-高、灰=不显著);下图为 Moran 散点图(横轴标准化观测值 z、纵轴空间滞后 Wz,拟合线斜率恰等于全局 Moran's I)。两图均可用右上角切换器切到「表格」视图,逐点读取坐标、取值、所属象限与伪 P 值。