
Kaplan-Meier生存分析
这个方法是做什么的
研究“从起点到事件发生要多久”的数据时用它。这类数据的特点是:观察结束时总有一部分人还没发生事件,或者中途失访了——他们不是缺失值,而是携带着“至少活到了这个时点”的信息,统计上叫删失。Kaplan-Meier 乘积极限法在每一个事件真实发生的时点重算一次条件生存概率再连乘,得到那条阶梯形的生存曲线;删失例会一直计入风险集,直到它离开为止。
除了组间比较的 p 值,报告还给出中位生存时间及其 95% 置信区间、25% 与 75% 分位生存时间;分组比较同时给 Log-Rank、Breslow 与 Tarone-Ware 三种加权检验;第四张卡给以分组变量为唯一协变量的单因素 Cox 风险比 HR、限制平均生存时间 RMST 及其组间差、以及在随访时间 25%/50%/75% 分位处的累积生存率。第一张卡逐条核对前提:时间是否非负、随访是否足以估出中位数、Schoenfeld 残差的比例风险检验,以及删失非信息性的粗筛。
需要准备什么数据
- 放入[定量]生存时间 T:1 个,定量变量(数值)
- 放入[定类]结局事件 E:1 个,定类变量(分组/标签)
- 放入[定类]分组变量 (可选)(可选):定类变量(分组/标签)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 30%。
- 「放入[定类]结局事件 E」必须正好是 2 个类别。
- 「放入[定类]分组变量 (可选)」的类别数需在 2~12 之间。
- 「放入[定类]分组变量 (可选)」的每一组至少 5 个样本。
- 「放入[定类]结局事件 E」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 比较两种治疗方案的生存时间,且到研究结束仍有相当一部分人未发生事件
- 结局是“首次发生某事件的时间”:复发、再入院、拔管、设备首次故障
- 各人的随访长度参差不齐,有人中途失访
- 需要一张能直接放进论文的生存曲线,并报告中位生存时间及置信区间
数据要摆成一行一个对象:一列非负的随访时长(不能是日期文本)、一列 0/1 结局(1=事件,0=删失),事件与删失各至少 10 例;要做组间比较再加一列分组变量,每组至少 5 例。真正的关键假设是删失非信息性——失访与预后无关,这条由研究设计保证,统计上无法严格检验。
什么时候不要用它
- 要同时调整年龄、分期等多个混杂因素:本模块只能按一个变量分组,用「Cox比例风险回归」。
- 存在竞争事件(研究肿瘤特异死亡时的其他原因死亡、研究出院时的院内死亡):把竞争事件当删失会系统性高估主要事件的累积发生率,用「竞争风险模型」,它的 Aalen-Johansen 累积发生函数不会出现各类事件加起来超过 1 的悖论。
- 只拿得到按时间段汇总的频数,或需要按固定区间出表:用「寿命表」。
- 结局只有“发生 / 不发生”而没有时间信息:用「逻辑回归」;只想比较两组的事件比例则用「卡方检验」。
- 观测不独立(同一个体多次入组、按中心明显聚集):生存曲线的方差会被低估,改用「Cox比例风险回归」并把聚集因素放进它的分层变量区。
容易误读的地方
- 卡①那条“删失非信息性”检验显著,多数时候不是问题——要看的是方向。 示例里 Mann-Whitney p<0.001,但删失组的中位观测时间 25.55 反而长于事件组的 14.35,判定栏据此写明:固定随访终点的研究中这是行政删失的正常特征,通常不违背非信息性。真正该警惕的是反过来——删失组时间明显更短,那通常意味着早期失访与预后相关,生存率会被系统性高估。
- 中位生存时间显示 N/A 不是报错,是曲线没降到 0.5。 中位数定义为累积生存率首次降至 0.50 的时间,随访不够长时它根本不存在。卡①专门有一行“随访充分性”:示例中最长随访 59.50 处的估计生存率是 0.1637,所以判“可估”。真遇到不可估,规范做法是改报若干固定时点的生存率及其置信区间,而不是拿最后一个观测时间充数。
- 三种检验不能事后挑 p 最小的那个报。 示例 Log-Rank 12.029、Breslow 15.360、Tarone-Ware 14.543,差别来自权重:Log-Rank 对所有时点等权(比例风险成立时效能最优),Breslow 以在险人数加权、更看重早期差异,Tarone-Ware 介于两者之间。表注明确要求依研究关注点在分析前选定主检验。
- 两条曲线交叉时,Log-Rank 可能给出“不显著”的错误印象。 交叉意味着风险比随时间反转,比例风险被破坏,而 Log-Rank 会把前后相反的差异互相抵消。此时应改看 RMST 差值,它不依赖比例风险假定,单位与生存时间相同、可直接讲成“τ 时间内平均多活了多久”。但要注意 τ 的取法:模块取各组最长随访时间的最小值(示例 τ=59.00,由“常规化疗”组决定,而全样本最长随访是 59.50),所以换一批数据 τ 就变,RMST 不能跨研究直接比较。
- p 值只说明曲线不同,说不出差多少。 示例 p<0.001,而回答“差多少”的是 HR=0.530(95%CI [0.368, 0.763])与 RMST 差 10.210 个月(95%CI [4.444, 15.976])。中位生存时间之差虽然直观,却只用到曲线上的一个点,信息利用率低于这两者。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(生存时间估计与差异检验)
- 输出结果三:生存曲线可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
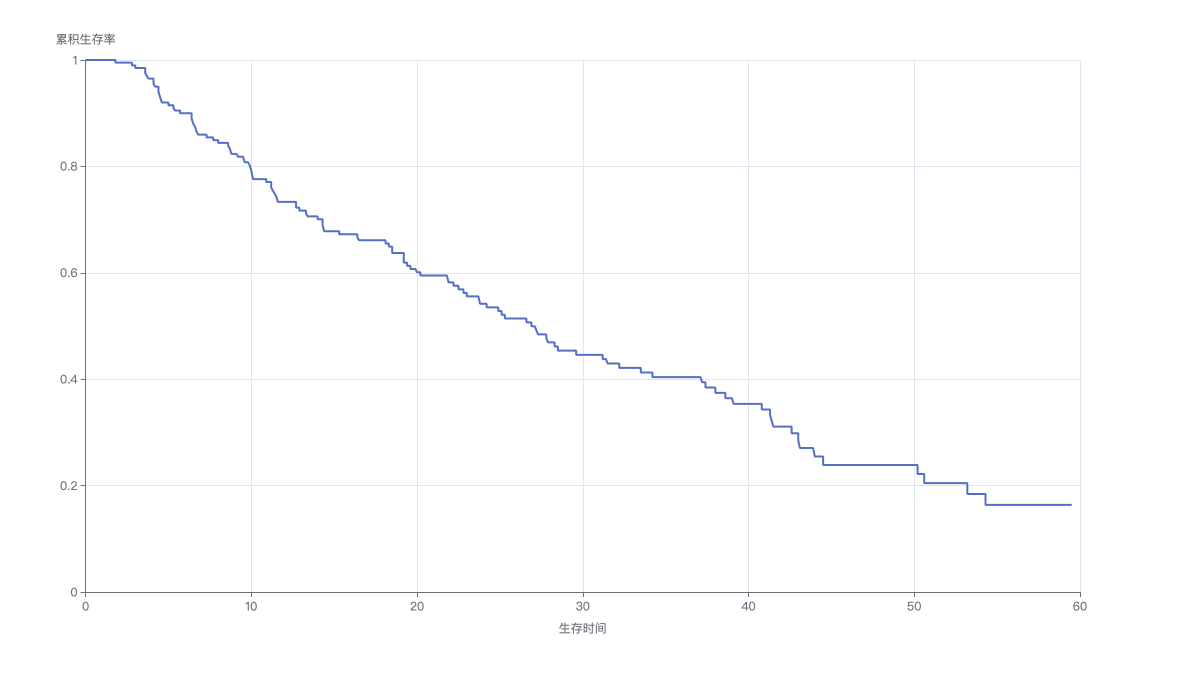
上图展示了全体样本的Kaplan-Meier生存曲线,Y轴为生存概率,X轴为时间。曲线的阶梯状下降代表在某个时间点发生了结局事件。可切换为「表格」查看等距时点的生存率。
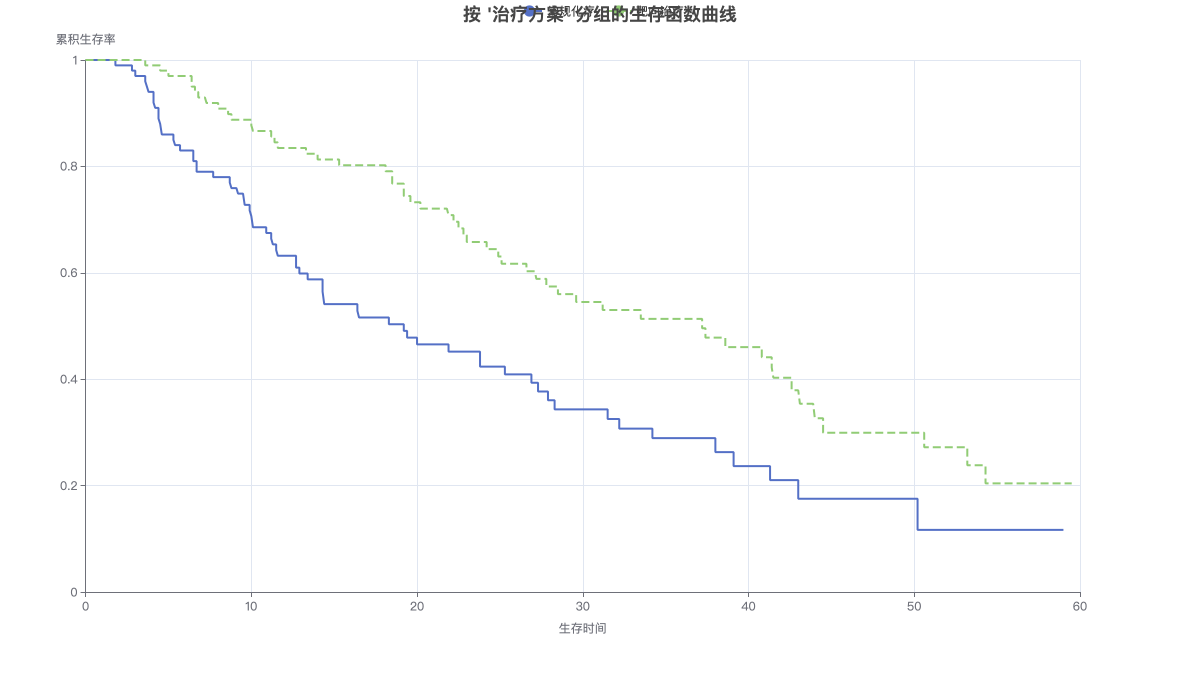
上图将不同组别的生存曲线绘制在一起,便于直观比较。曲线在上方的组别,其生存状况通常更优。可切换为「表格」查看各组在等距时点的生存率。