
断点回归(RD)
这个方法是做什么的
当“能不能得到处理”由一个连续变量是否越过某个阈值决定时,阈值两侧紧挨着的个体几乎没有差别——差 0.5 分录取和差 0.5 分落榜的两个人,除了处理状态之外几乎可以互换。断点回归就利用这一点:估计结果变量在断点处的跳跃,把它当作局部的因果效应。清晰断点回归假定过线即处理;若过线只是提高了被处理的概率,在处理变量 D 区放入实际处理状态即为模糊断点回归,此时估到的是被断点影响的那部分个体上的局部平均处理效应。
主结果表给三行:Conventional 是传统局部多项式估计,Bias-Corrected 做了偏误修正,Robust 在偏误修正基础上又调整了推断,表注写明 Robust 是应优先报告的结果(Calonico, Cattaneo & Titiunik, 2014)。围绕它还有:卡① 的密度操纵二项检验与前定协变量连续性检验;卡③ 的断点拟合图与带宽敏感性曲线;卡④ 的标准化跳跃(以带宽内 Y 的标准差为尺度)、七个倍数带宽逐个真跑一遍的敏感性表,以及安慰剂断点与 Donut-hole 两组稳健性检验。
需要准备什么数据
- 放入 [定量] 结果变量Y (变量数=1):1 个,定量变量(数值)
- 放入 [定量] 分组变量X (变量数=1):1 个,定量变量(数值)
- 放入 [定量] 协变量 (变量数≥0)(可选):定量变量(数值)
- 放入 [定量] 处理变量D (变量数≤1)(可选):定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 分配规则是明写的门槛:录取线、低保线、评级档位、年龄资格、补贴起征点
- 断点两侧、特别是带宽之内两侧都有足够观测(经验上每侧不少于十几个)
- 手上有前定协变量可以放进来——协变量连续性检验要有变量才做得起来,模块也建议至少放一个
- 你要的结论就是“刚好过线的这批人受了多大影响”,而不是全人群的平均效应
断点位置必须自己填,且必须落在分组变量的实际取值范围内。控件默认值是 500.0 这个与数据无关的死值,忘了改会被直接拦下:实测在演示数据上填 500,返回的是“您设置的断点位置 (c = 500.0) 不在分组变量 (X) '入学考试分数' 的实际数据范围 [21.25, 100.0] 之内”。带宽留空则按 rdrobust 的 MSE 最优准则自动选取。
什么时候不要用它
- 处理与否由个体自选、没有任何阈值规则:没有断点就没有 RD,改用「倾向得分匹配 (PSM)」在可观测协变量上构造可比对照。
- 有政策时点和对照组的面板数据:识别来自时间与分组两个维度,用「双重差分(DID)」;两组基线差得多时用「PSM-DID」。
- 分组变量是定类的,或只有寥寥几个取值:断点搜索无从谈起。若你真正想问的是“X 超过某个值之后斜率变了”,那是分段回归问题,用「门槛回归(Hansen)」,它会自动搜索门槛值并检验其显著性。
- 关心的是整体人群的平均效应:RD 只识别断点邻域的局部效应,演示数据里 400 个观测只有 166 个进入估计。要谈全人群就得换一个覆盖全样本的识别来源——手上另有一个与门槛无关的外生工具时用「两阶段回归」,否则用「线性回归 (最小二乘法)」并如实写明它只是关联。
- 有证据表明个体能精确操纵分组变量(老师给差一分的学生补分、申请人自己填报收入):断点两侧的可比性从根上被破坏,RD 救不回来。有前后期与对照组时改用「双重差分(DID)」,重新论证一条不依赖“无法操纵”的识别路径。
容易误读的地方
- 换拟合阶数不只是换一条曲线,它会连带换掉带宽、样本和结论精度。 实测把阶数从 1 阶改到 4 阶:MSE 最优带宽由 6.9978 变成 17.6730,带宽内样本由 166 变成 313,Robust 跳跃由 7.7022 变成 6.8903,区间由 [4.9938, 10.4106] 变宽到 [3.0921, 10.6884]。控件给到 4 阶,但卡① 的说明引 Gelman & Imbens (2019) 建议一般不超过 2 阶——高阶多项式最容易在断点附近拟合出虚假跳跃。阶数应当先定、再看结果,不能挑一个跳跃最漂亮的阶数报上去。
- 密度检验通过,不等于没有操纵。 卡① 的结论文案讲得很清楚:协变量连续只能增强、不能证明“个体无法精确操纵分组变量”,后者原则上不可被证实。这里的二项检验只看断点邻域两侧的计数是否对称(演示数据 ±1 倍带宽内 90 比 76,p=0.313),对“所有人都往上挪一点点”这种平滑的操纵是查不出来的。
- Donut-hole 那几行“与基准同号”是很弱的判据。 演示数据剔除断点附近 |X−c|≤1.5750 的 44 个观测后,跳跃降到 0.6976、p=0.934;再往外挖到 |X−c|≤3.9375(丢掉 106 个观测),点估计飙到 23.6303、p=0.700。两行的判读都写着“与基准同号但不显著”,但第二行的数值已经离谱到不能用了——洞挖得越大,被挖空的正是识别所依赖的断点邻域,剩下的是外推。读这张表要连点估计的量级一起看,不能只数符号。
- 三行估计不能挑区间最窄的那一行报。 演示数据 Conventional 8.1731、Bias-Corrected 7.7022、Robust 也是 7.7022,但标准误由 1.1900 放大到 1.3819。表注写明三行区间宽度不同是正常的,Robust 更宽是因为它纳入了偏误修正带来的额外不确定性。它们是同一份数据的三种推断,不是三个可供挑选的结果。
- RD 的结论只对断点附近的人成立。 演示数据最优带宽 6.9978,真正参与估计的是分数落在 53 到 67 之间的 166 名学生。“过 60 分能让升学成绩提高 7.7”这句话不能推到 90 分或 30 分的人身上,更不能当成“把分数线取消掉大家都能涨 7.7”。模糊断点回归下还要再退一步:估的是因为过线才被处理的那部分人的效应,不是全体的平均效应。
报告里有什么
- 输出结果一:数据概览与识别假设检验
- 输出结果二:断点效应估计
- 输出结果三:断点拟合图与带宽敏感性曲线
- 输出结果四:效应量与稳健性检验
- 输出结果五:结论与学术表述
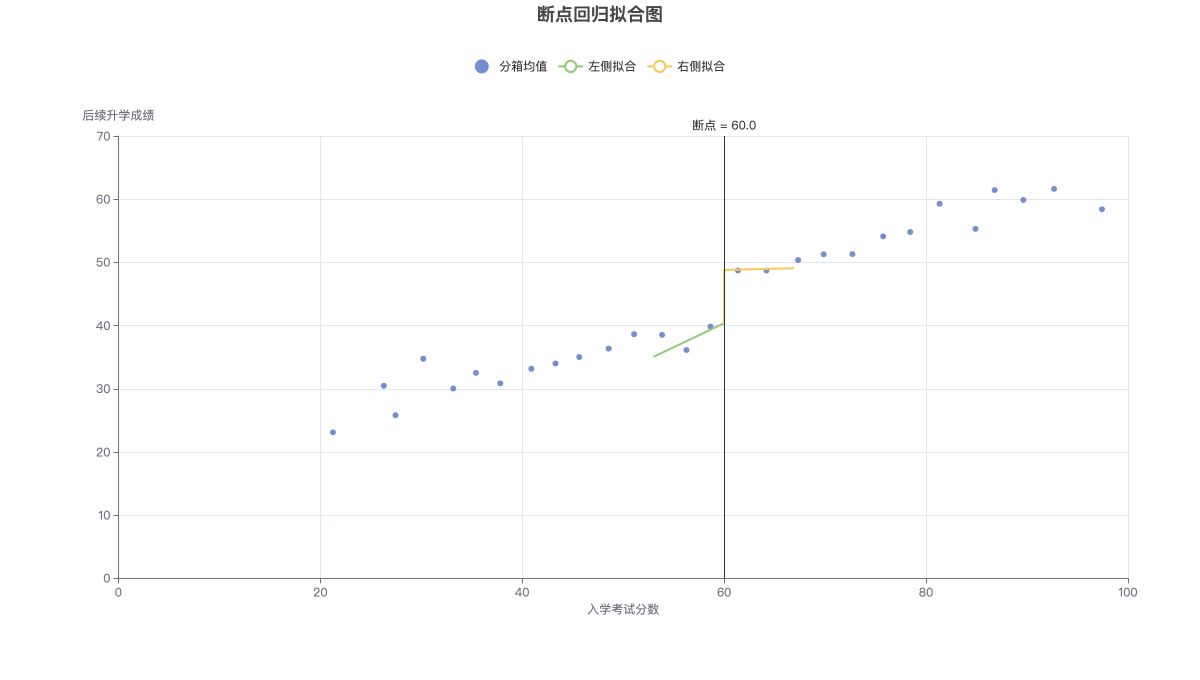
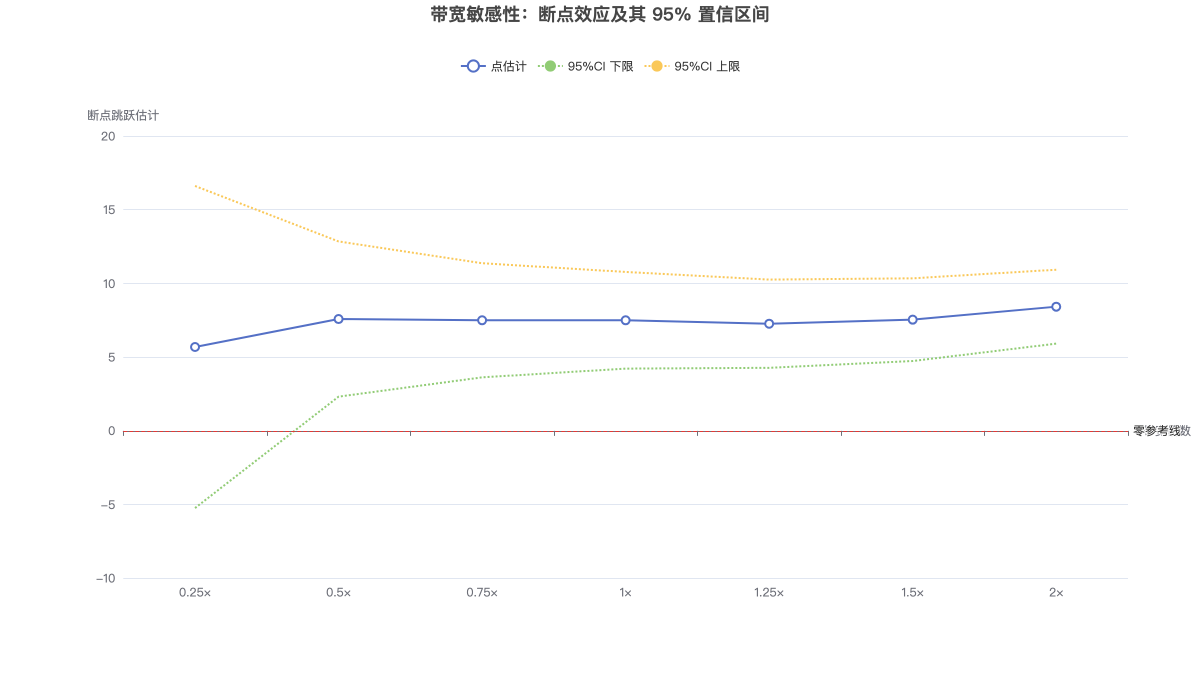
上图为断点回归拟合图:垂直线为断点 c = 60.0,散点是分箱后的局部均值(非原始数据点),两条曲线为断点两侧的局部多项式拟合;两条曲线在断点处的垂直距离即卡② 报告的跳跃幅度。 下图把不同带宽下的点估计与 95% 置信区间画在一起,曲线越平坦说明结论对带宽越不敏感。