
重复测量方差分析
这个方法是做什么的
让同一批对象在多个时间点或多种条件下反复测量同一个指标,再比较这些测量条件之间的平均水平有没有差别。它把“同一被试的多次测量彼此相关”显式建模,从误差里分离出个体差异,因此同样样本量下比被试间设计更灵敏。数据必须是宽表:一行一名被试,多个测量列一起拖进“重复测量变量”(至少 2 列,定量),另给一列“个案标识(ID)”。“组间变量”可选,放进去就成了混合设计。被试只要在任一测量条件上缺失,全部观测都会被整例剔除,卡① 会写明剔除了几名。
除了显著与否,主体内效应检验表对每个效应给四行——“假定球形度”“格林豪斯-盖斯勒”“辛-费尔德特”“下限”,四行的平方和与 F 相同,只有自由度与 p 不同。卡① 逐条件做 Shapiro-Wilk,混合设计再做一次基于被试均值的 Levene,水平数达 3 个时给出 Mauchly 球形度检验与三个 ε。卡④ 给偏 η²(附由非中心 F 反解的 95%CI)、广义 η² 与 Cohen's f;偏 η² 的分母只含该效应自身的误差项,在混合设计里会被抬高,实测同一组内主效应偏 η² = 0.652 而广义 η² 只有 0.173,跨研究比较该用后者。事后多重比较默认关闭,需在控件里打开并选 LSD / Bonferroni / Sidak。
需要准备什么数据
- 放入 [定量] 重复测量变量:至少 2 个,定量变量(数值)
- 放入 [定类] 个案标识(ID):定类变量(分组/标签)
- 放入 [定类] 组间变量 (可选)(可选):定类变量(分组/标签)
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入 [定类] 组间变量 (可选)」的类别数需在 2~20 之间。
- 「放入 [定类] 组间变量 (可选)」的每一组至少 2 个样本。
- 「放入 [定类] 个案标识(ID)」的每一组至少 1 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 同一批患者在治疗前、治疗后 4 周、治疗后 12 周的同一份量表得分
- 同一批被试在三种实验条件下的反应时(条件呈现顺序已做过平衡)
- 同一批门店在促销前、促销中、促销后的客单价
- 混合设计:两种康复方案(组间)× 三个时间点(组内),关心两组随时间的变化模式是否不同
- 想知道指标在多次测量间整体有无变化,而不愿拆成若干次两两比较
被试之间必须相互独立——同一被试的多次测量允许相关,不同被试之间不能有关联(同一个家庭、同一间教室的被试就不满足)。各测量条件下因变量近似正态,被试数较大时 F 检验对此较稳健;混合设计还要求各组的被试间方差齐性。球形度是重复测量特有的前提:任意两个水平之差的方差相等,2 个水平时恒成立。另有两条同样要紧:测量顺序若未平衡,时间主效应里混着练习与疲劳效应;被剔除的个案若与结局有关,会带来选择偏倚。
什么时候不要用它
- 只有两次测量:用「配对样本T检验」,结论等价而报告更干净;两个水平时球形度恒成立,那四行校正也没有意义。
- 数据是长格式、各被试测量次数不一致、或缺失多到不愿整例剔除:本方法只吃宽表且做列表删除,改用「混合模型」,它允许不平衡的观测数。
- 因变量是等级或严重偏态、被试又不多:用「多配对样本Friedman检验」;每次测量只有“是 / 否”两类时用「Cochran's Q 检验」。
- 那几列其实来自不同的人:这不是重复测量,独立性前提刚好反了,应用「单因素方差分析」或「双因素方差分析」。
- 想在比较各时点时扣掉基线等协变量的影响:别转「协方差分析」,它明确把重复测量挡在门外,两边互指只会把你推回原地。出口是「混合模型」或「广义线性混合模型(GLMM)」:时点作固定效应、被试作随机效应,协变量直接进模型,还不必整例剔除。
- 同时有多个因变量、并希望控制整体的一类错误:「多变量方差分析」同样不收重复测量数据,在两者间来回踢是同一个死循环。逐个因变量跑「混合模型」、再自行施加 Bonferroni 一类校正;因变量彼此高度相关时,先用「主成分分析(PCA)」压成少数综合指标再比。
容易误读的地方
- 球形度检验不显著不等于球形度成立,而它显著与否直接决定报告用哪一行。 判定规则是:Mauchly 的 p 大于 0.05 时,卡⑤ 的“p(报告口径)”与顶部摘要取未校正值;p 小于等于 0.05 才切换,切到哪种看 Greenhouse-Geisser 的 ε——ε 小于 0.75 用 GG,否则用较宽松的 Huynh-Feldt,并在括号里标出方法与 ε(实测 ε = 0.516 走 GG;ε = 0.855 时改走 HF,报出 ε = 0.880)。而 Mauchly 在被试少时检验力很低,“没检出违反”不是“不存在违反”。那四行永远都印,“表里有格林豪斯-盖斯勒行”并不说明这次用了它。
- 校正后的自由度是小数,而卡⑤ 速览表括号里的自由度仍是未校正的整数。 校正就是把分子分母自由度同乘 ε 再查 F 分布,平方和与 F 不动。实测 ε = 0.516 时,组内主效应的自由度由 (2, 176) 变成 (1.032, 90.835),残差均方随之从 2.920 变成 5.657——小数是正常的,别四舍五入。但卡⑤ 同一行里 p 已是校正后的、F 却仍印作 F(2, 176),报告校正结果时请回主体内效应检验表取那两个小数值。
- “校正”不是“惩罚”,它并不总是把 p 推大。 对 F 大于 1 的效应确实更保守(实测 F = 1.535,p 由 0.218 变 0.219);但对 F 小于 1 的效应反而把 p 变小(实测 F = 0.320,未校正 0.727,Huynh-Feldt 校正后 0.699,“下限”那行更低到 0.572)。校正改的是参考分布的形状,不是加罚分;真正被它改变结论的只有 F 落在临界值附近的效应。偏 η² 也不随校正变化——校正只动自由度与 p。
- 交互效应一显著,主效应就不能照字面读,而拆开看要你手动打开一个开关。 实测交互效应 F(2, 176) = 16.018、p < 0.001,摘要随即写明“应以简单效应分析的结果为准”,但简单效应表必须打开控件里的“是否进行事后多重比较”才出现。那张表分两截:上半截在每个组内部比较各测量条件(配对口径),下半截在每个测量条件下比较组间(Welch 口径)。方法选择会改变结论:同一组第 1 次与第 2 次的比较,LSD 下 p = 0.005、Bonferroni 下 p = 0.014;第 3 次测量上的组间比较则从 LSD 的 0.060 变成 Bonferroni 的 0.180。表注还提醒两截各自控制族系误差率,跨两截未统一控制。
- 柱图上的误差棒不能拿来判断组内差异。 卡①、卡③ 的标准误是各条件自身标准差除以 √n(本例 0.710、0.751、0.727),表注写明“未考虑被试内相关,仅作描述参考”。重复测量之所以灵敏,靠的恰恰是配对差值的变异——卡④ 事后表印的才是配对标准误(表注写明“标准误 = 配对差值的标准差 / √配对数”)。所以误差棒重叠而组内主效应高度显著是正常的,不是报告自相矛盾;要判断某两个条件差多少,看事后表的均值差与配对标准误。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
两条线平行时,B 的效果在 A 的两个水平上一致,可以单独报「B 有效」;两条线交叉时,B 的效果方向随 A 而变,此时说「B 平均有效」会同时误导两类人,必须分水平报告。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:方差分析主结果表
- 输出结果三:均值与交互作用可视化
- 输出结果四:效应量与事后多重比较
- 输出结果五:结论与学术表述
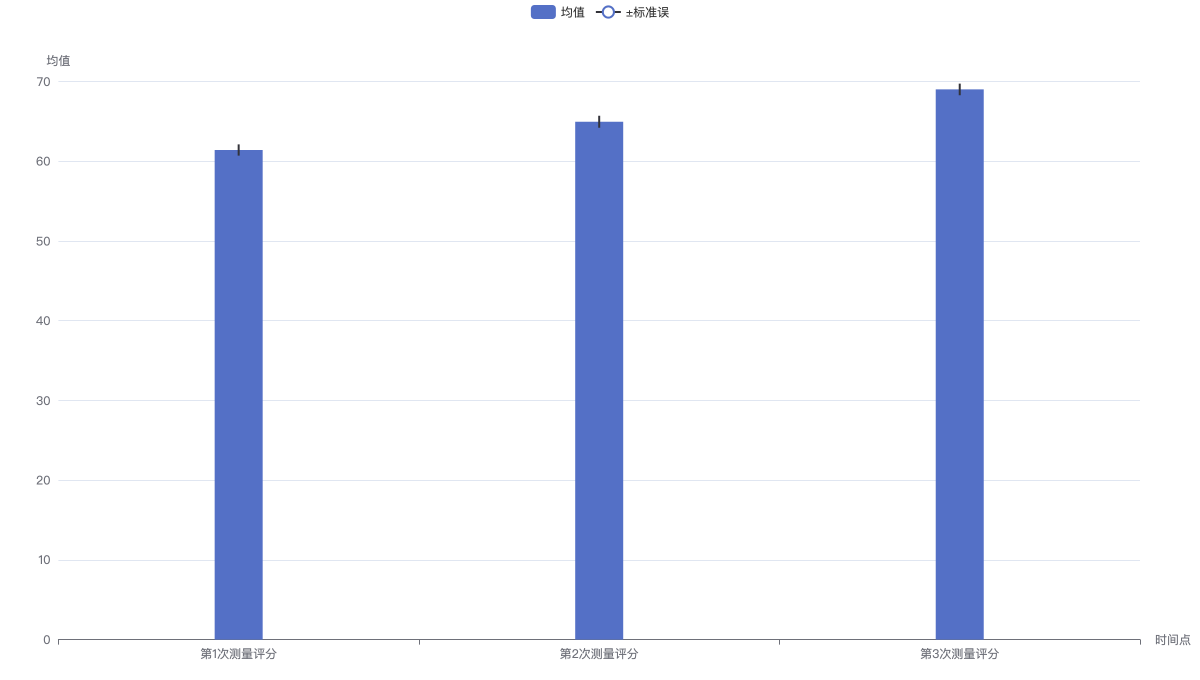
柱=各测量条件(时间点)的因变量均值,竖须=±标准误(也可视作 95%CI 的近似),用于直观比较组间差异(与方差分析 F 检验结论相互呼应)。
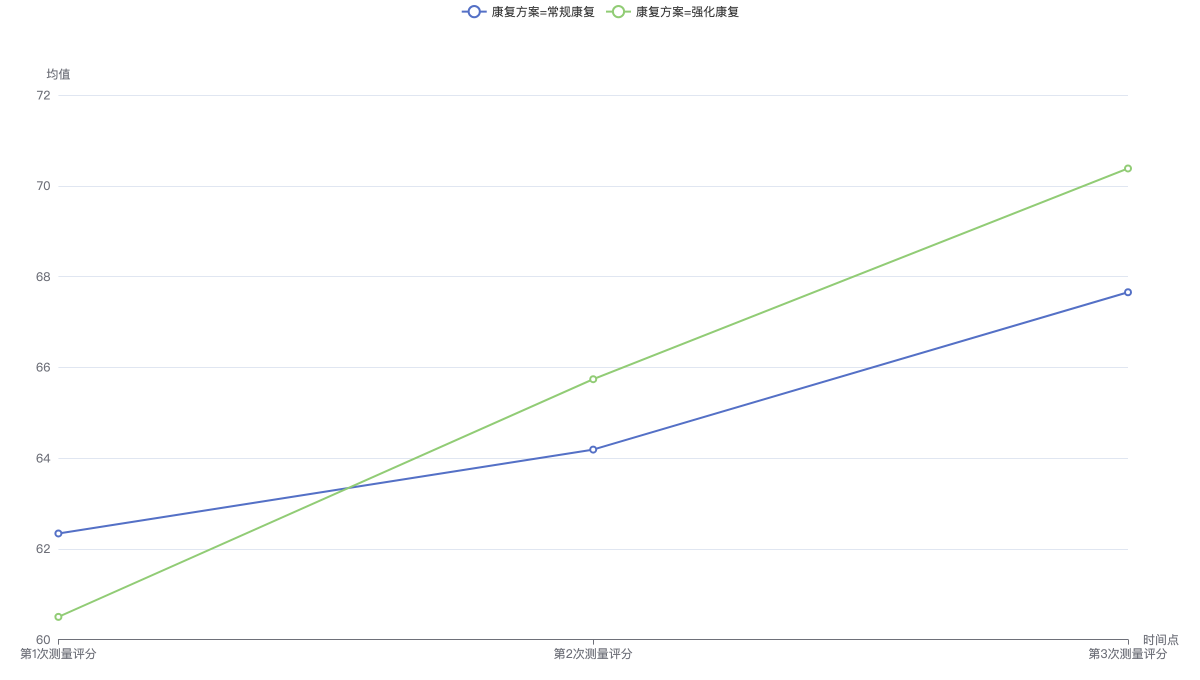
剖面图:横轴为「时间点」的各水平,每条折线代表「康复方案」的一个水平,纵轴为该单元格的均值。这是判读组内×组间交互效应最直接的图示。