
均值估计/回归插补
这个方法是做什么的
把定量变量的缺失格子用一个估计值填上,填完这些列就不再有缺失。两种方法二选一:“均值估计”把某一列的全部缺失填成该列非缺失样本的均值;“回归插补”用你放进预测变量区的其它定量变量拟合一个回归方程,按每条记录各自的预测值来填。卡② 会逐格列出填了什么值,方便人工核对是否落在合理范围。
它属于单一插补——每个缺失只被填一个值,后续分析会把这些估计值当成真实观测,因此必然低估不确定性。模块把这个代价量化在卡④:填入值分布与观测值分布的 KS 距离、方差比(插补后全样本方差 ÷ 插补前观测方差)、标准差变化与均值偏移,并按方差比分成良好、轻度、中度、严重四档判定。这一卡是判断本次插补能不能接受的核心依据,比“缺失已降为 0”重要得多。
需要准备什么数据
- 放入待插补变量:至少 1 个,定量变量(数值)
- 放入回归预测变量(可选)(可选):至少 0 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
- 单列缺失率不超过 60%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 缺失率很低(个位数),后续只做描述统计与作图,不报告置信区间与 p 值
- 需要一份没有缺失的完整数据,交给某个不接受缺失值的下游流程
- 手上有与目标变量强相关的预测变量(卡① 会逐对给出相关系数与信息量判定),用回归插补比直接填均值合理得多
- 作为正式插补结果的对照,看关键结论在不同处理方式下稳不稳
待插补变量必须是定量列,而且必须确实存在缺失——一格不缺时模块会直接拒绝执行。预测变量同样必须是定量列,且不能与待插补变量是同一列;整列全缺失的变量无法插补。缺失率超过 30% 时方差压缩会很严重,这已经超出本模块的适用范围。
什么时候不要用它
- 后续要报告置信区间、标准误或 p 值:用「多重插补」。单一插补把估计值当成真实观测,标准误会系统性偏小、区间偏窄,显著性被人为放大——这不是精度问题,是方向已知的系统偏差。
- 还没判断过缺失机制:先跑「缺失模式分析表」。只有在 MCAR 下直接填均值才不至于把中心也带偏;MCAR 被证伪时应优先考虑「多重插补」。
- 缺失率超过 30%:方差压缩会严重到让后续推断失去意义,用「多重插补」。
- 待插补的是分类变量:本模块与「多重插补」都只接受定量列。定类变量的缺失通常是把“缺失”当作单独一个类别参与分析,再用「频数分析」或「列联(交叉)分析」看它的分布是否与别的变量相关。
- 只是想知道每列缺了多少、哪些变量一起缺:不必插补,用「数据概览」看缺失率与完整记录数,用「缺失模式分析表」看模式与机制线索。
- 选了回归插补,但预测变量与目标变量几乎不相关:结果会退化成均值填补(卡① 的相关性表就是用来提前判断这件事的)。相关很弱时不如直接用「多重插补」,它靠链式方程同时利用所有变量的信息。
容易误读的地方
- 均值估计的方差比是由缺失比例算死的,跟数据本身无关。 示例里两个变量的方差比都是 0.8849,因为两者都缺 16 格、样本都是 140 行:均值填补后的方差恰好等于原来的 (124−1)/(140−1)=123/139。在这个口径下,数字只取决于缺了多少,不取决于填得“准不准”,两个毫不相干的变量算出同一个数并不是巧合。切到回归插补则不同——填入的是各自回归方程的预测值,方差压缩的幅度随该变量自己的拟合优度而变,不再是同一个数。看到 0.88 觉得“还行”是危险的:后续任何标准误都会按这个比例被缩小,而报告不会替你改回来。
- “均值偏移 0.0000”不是插补做得好的证据。 均值估计把缺失全部填成样本均值,全样本均值必然与观测均值完全相同,这一格恒等于 0,是算术恒等式而不是质量指标。同一张表里的 KS 距离则相反:填入值全是同一个数,D 必然很大(示例 0.508 与 0.540,p<0.001),表注也写明这是方法的固有属性、不是计算错误。这两列对均值估计几乎不含信息,真正要看的是方差比,以及后续到底要不要做推断。
- 回归插补不堆柱子,但一样低估方差,还会额外抬高相关性。 它填的是回归方程的预测值,缺了残差那一项,于是填入的点严格落在回归线上。后果有两个:目标变量的方差被压小;目标与预测变量之间的相关系数被人为抬高,而这个相关往往正是你接下来要报告的东西。R² 再高也解决不了——即便 R²=0.9,单一插补仍然不反映残差的随机性。要保留这份随机性只能用「多重插补」。
- 选了“回归插补”,跑出来的可能是均值估计。 预测变量区为空、或可用于训练的完整样本不足时,模块会自动回退为均值填补,并在卡② 的“实际方法”列如实标注。所以选完方法要回头核对那一列写的是什么,别把一份均值填补的结果当成回归插补写进论文。另外反过来也要注意:用均值估计时,你放进预测变量区的列完全不参与计算,卡① 的相关性表只在选择回归插补时才起作用。
- 所有质量指标只能说“填入值像不像观测值”,不能说“填得准不准”。 真值没有被观测到,任何模块都无法验证插补值离真值有多远——模块自己在卡④ 写明了这一点。所以不要把 KS 不显著、方差比接近 1 读成“插补是对的”,它只说明这次填补没有明显扭曲分布形状。要判断结论稳不稳,可行的做法是把完整案例(不插补)与插补后的分析结果并排比一遍,或者用「多重插补」看合并后的区间是否仍支持同一个结论。
报告里有什么
- 输出结果一:插补前样本量与前提检验
- 输出结果二:插补策略与插补结果
- 输出结果三:插补前后分布可视化
- 输出结果四:插补质量指标(分布偏移 / 方差压缩 / 拟合度)
- 输出结果五:插补充分性结论
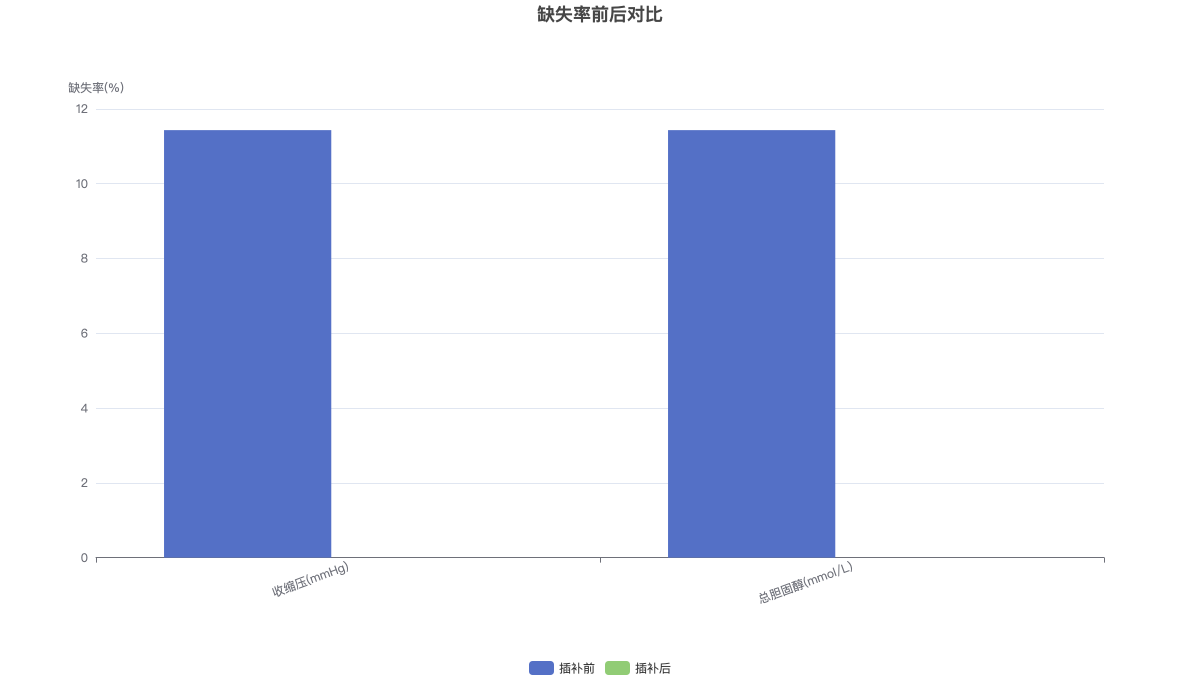
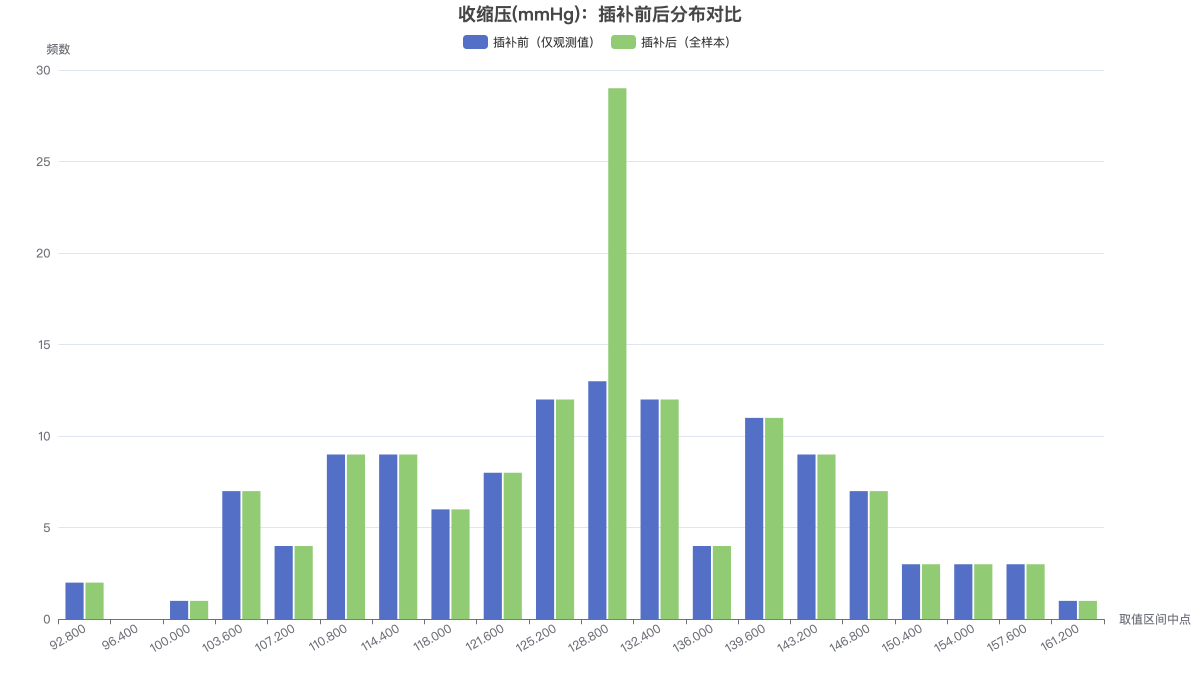
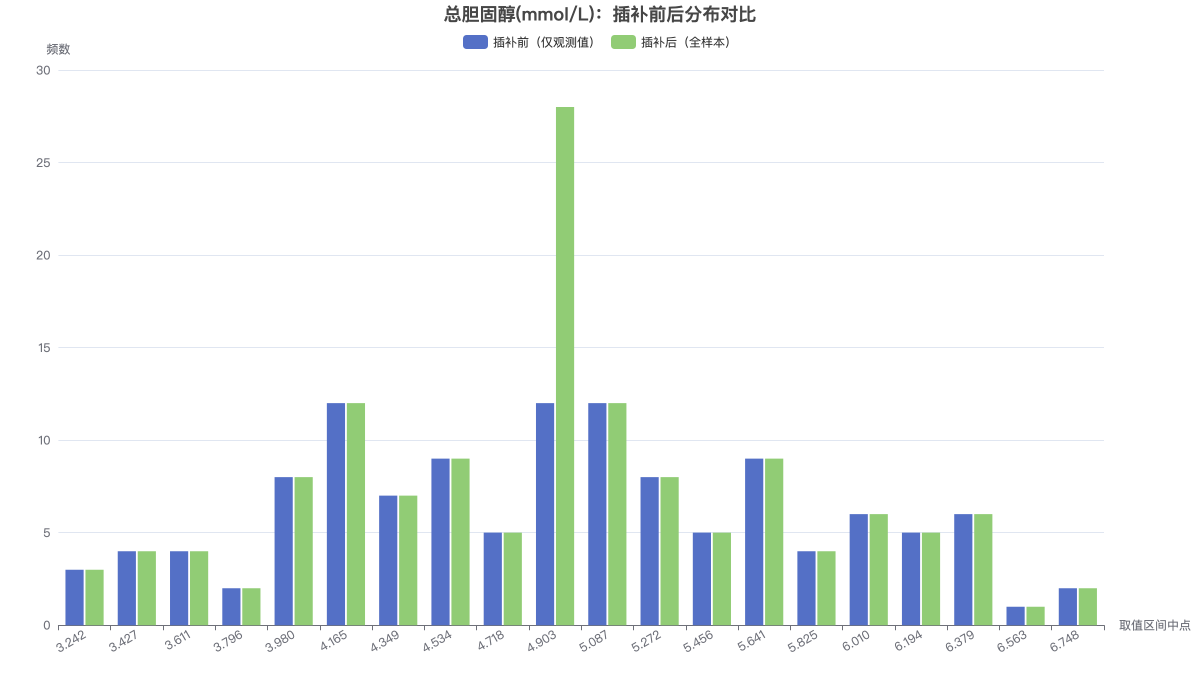
第一张图对比缺失率的下降,其余各图把「插补前的观测值分布」与「插补后的全样本分布」叠在一起看形变。