
Gamma 回归
这个方法是做什么的
因变量是严格大于 0 的连续量——住院费用、理赔金额、维修时长、生化浓度、销售额——而且右偏、方差随均值一起变大时用它。Gamma 回归用 Gamma 分布配对数链接拟合:系数 B 是对数期望上的加性效应,取指数后的 exp(B) 是乘性倍数,读作“该自变量每增加 1 个单位,因变量的期望变成原来的 exp(B) 倍”。分布族与链接函数都是写死的,页面上没有切换开关;也没有分组或簇变量的入口,观测必须彼此独立。
除显著性,报告给出模型整体的似然比检验、McFadden / Cox-Snell / Nagelkerke 三个伪 R²、AIC/BIC、Deviance 与 Pearson χ² 各自除以残差自由度、以及 Pearson 离散参数 φ̂。卡④ 另有一张逐变量 Type III 似然比检验:每一行都是真把该变量剔掉、重新拟合缩减模型再与全模型比似然,定类变量的多个哑变量在那里被当作一个整体检验。卡① 逐条核对前提:因变量的最小值、变异系数 CV 与偏度、数值自变量的 VIF、被自动剔除的常量变量。定类自变量可以直接拖进来,按参照编码自动展开为哑变量。
需要准备什么数据
- 放入因变量 (Y):不限
- 放入自变量 (X):至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 住院费用与年龄、病种、住院天数的关系,想说“贵百分之多少”而不是“贵多少元”
- 理赔金额、任务耗时、设备维修时长这类不可能取负、右边拖着长尾的指标
- 反应时、浓度、浓缩倍数等正值偏态测量的多因素建模
- 用最小二乘跑完发现残差随预测值增大而发散,想换一个方差随均值增长的模型
因变量含 0 或负值会在入口被直接拒绝(报错文案是“必须全部大于 0”),不会静默平移或截断。Gamma 假定的是“标准差与均值成正比”,即方差正比于均值的平方、各观测的变异系数大致恒定;卡① 把 CV 与偏度打出来供你核对,偏度接近 0 或为负时会打“注意”。极大似然是大样本方法,有效样本量要远大于参数个数。
什么时候不要用它
- 因变量含 0 或可能为负:用「线性回归 (最小二乘法)」;若只是右偏又含 0,先做「数据变换(Box-Cox/Yeo-Johnson)」再回到「线性回归 (最小二乘法)」。
- 因变量是非负整数计数(投诉件数、发病次数):用「计数数据回归」;0 特别多时用「零膨胀计数回归(ZIP/ZINB)」。
- 因变量是二分类或等级:用「逻辑回归」;等级用「有序逻辑回归」。
- 观测之间不独立(同一批对象反复测量、同一家医院内的病人):本模块没有簇变量入口,标准误会被低估。想要总体平均效应用「广义估计方程(GEE)」,它有 Gamma 族;因变量是计数或二分类、又要量化组间异质性用「广义线性混合模型(GLMM)」;因变量是正态连续的分层数据用「混合模型」。
- 自变量之间高度共线:系数会极不稳定。细查用「VIF共线性诊断」,严重时改用「岭回归(Ridge)」或「Lasso回归」。
- 只想比较几组正值偏态指标的高低,不需要回归:两组用「独立样本 Mann-Whitney U 检验」,三组及以上用「多独立样本Kruskal-Wallis检验」。
容易误读的地方
- McFadden 伪 R² 在这里不是量纲不变量,换个单位数字就变。 实测:把因变量从“万元”改记成“元”(乘 100),同一份数据、同一个模型,McFadden 由 0.0800 掉到 0.0378、AIC 由 917.768 涨到 2023.008,而似然比检验 χ²(3) = 79.064、Cox-Snell 0.4826、Nagelkerke、Deviance/df 全部纹丝不动。原因是因变量连续时对数似然是概率密度的对数,换量纲会给全模型和空模型同时加上一个常数,比值随之改变。所以伪 R² 与 AIC/BIC 只能在因变量单位完全相同的模型之间比。报告里“McFadden 在 0.2~0.4 之间通常即视为拟合良好”那条经验线出自二分类选择模型,照搬到连续因变量上会把一个不错的模型判成很差——本例同一个模型的 McFadden 是 0.0800、Nagelkerke 却是 0.4827。
- exp(B) 是乘性倍数,不是“增加多少”,而且绑死在自变量的单位上。 广告投入 B = 0.075、exp(B) = 1.0781 的意思是“每多投 1 万元,月销售额的期望变成原来的 1.0781 倍(约 +7.8%)”,不是“多 7.8 万元”。门店面积的 exp(B) = 1.0009 看上去几乎等于 1,那是因为它按“每 1 平米”算——换成每 100 平米就是 1.0009 的 100 次方、约 1.09。单位很小的变量(元、天、毫升、平米)要先换算成有意义的刻度,报告时写明 exp(B) 对应每增加多少。
- 卡① 的偏度告警指向“该不该用 Gamma”,不是“数据不合格”。 示例数据的因变量偏度 = -0.4141,模块打出“注意:接近对称或左偏;Gamma 主要适用于右偏的正值数据,此处可与正态/对数正态模型对照”,然后照样把整份报告算完。左偏或近对称的正值数据用 Gamma 不会报错,但“方差正比于均值平方”这条假定多半不成立,标准误会有偏。看到这一行就该拿「线性回归 (最小二乘法)」跑一遍作对照,而不是当它没出现。
- Deviance/df 与 Pearson χ²/df 在 Gamma 回归里不按“是否等于 1”判读。 这两个比值是泊松族与二项族的过离散判据,因为那两族的离散参数被固定为 1;Gamma 的离散参数本身就是要估的自由参数,Pearson χ²/df 正是它的矩估计——本例 0.0291 同时被当作 φ̂ 报出来,含义是条件变异系数约为 0.17(0.0291 的平方根),而不是“拟合差了 34 倍”。卡④ 那句“Deviance/df 明显大于 1 提示模型对数据的拟合不足或存在未纳入的异质性来源”是广义线性模型的通用话术,读 Gamma 的结果时要带着这个背景。
- 系数表的 Wald p 与卡④ 的 Type III 似然比 p 不一致是正常的,冲突时以后者为准。 卡⑤ 的速览把两套显著变量集合分成两行并列打出来,表注写明“小样本时以似然比结论为准”。差别的来源是:Wald 检验逐个哑变量做、且在系数很大时会失真;Type III 那一行是真剔真拟合,并把一个定类变量的全部哑变量当成整体检验。所以定类自变量只要有一个水平在卡② 里显著,别急着说“这个变量显著”,要看 Type III 的那一行。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Gamma 回归系数表
- 输出结果三:系数森林图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
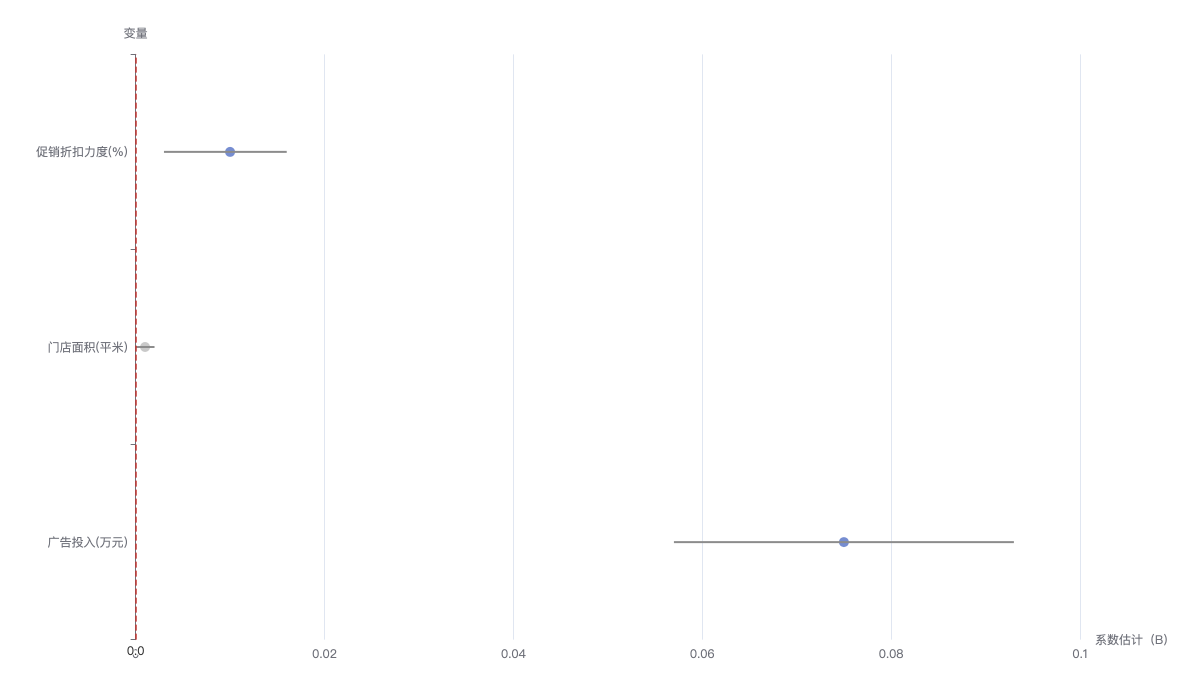
图形读法:圆点为各系数的点估计,横向须线为其 95% 置信区间;红色虚线为零参考线。置信区间跨越零线(含 0)表示该系数不显著(灰点),不跨越则显著(蓝点),须线越窄表示估计越精确。注:截距(常数)量级远超其它系数会压扁图形,本图已略去截距,仅展示各斜率系数。本图为表4的可视化,未改变任何数值;可用右上角切换器切到「表格」视图逐条读数。