
倾向得分匹配 (PSM)
这个方法是做什么的
处理组和对照组本来就不一样:去参加培训的人本身学历更高、工龄更长,直接比较两组的收入,比出来的是“谁去参加培训”而不是“培训值多少钱”。倾向得分匹配先用 Logit 把一组前定协变量压成一个数——被处理的概率,再给每个处理个体找一个得分相近的对照个体配成一对,ATT 就是这些配对差的平均。默认是 1:1 无放回最近邻匹配,并施加 0.2×SD(logit(PS)) 的卡钳(Austin 2011 口径),卡钳倍数与匹配方法都能在左侧控件改。
报告把“匹配得好不好”摊开给你看:卡① 给倾向得分模型、共同支撑区间、卡钳取值与被丢弃的处理单元数,以及每个协变量匹配前后的标准化偏差 SMD、方差比与 t 检验;卡② 除 ATT 外,还并排给出配对 t 与 Abadie-Imbens (2006) 样本/总体两种方差口径;卡④ 用四种估计量互相对照(配对 t、匹配样本上的双重稳健回归调整、全样本 OLS、逆概率加权 IPW);卡⑥ 是可下载的逐对匹配明细,含未匹配成功的样本。
需要准备什么数据
- 研究变量 (T):1 个,定类变量(分组/标签)
- 结果变量 (Y):1 个,定量变量(数值)
- 协变量 (X):1~50 个,定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「研究变量 (T)」必须正好是 2 个类别。
- 「研究变量 (T)」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 观察数据里“要不要接受处理”是个体自选的,两组基线特征差得明显
- 只有一期截面,没有政策前后两段观测
- 在估效应之前,先想看清两组到底可不可比(共同支撑与 SMD 就是干这个的)
- 需要向审稿人证明协变量已被平衡,而不只是“回归里控制了”
研究变量必须取 0/1;协变量必须是定量列,模块直接把它们送进 Logit、不做哑变量编码,定类列请先编码再拖进来;协变量只能放处理发生之前就已确定的前定变量,放入受处理影响的中间结果会造成坏控制偏误。对照组规模不宜小于处理组,否则可匹配的对象不够用。
什么时候不要用它
- 有政策前后两期:匹配只能吃掉可观测差异,差分还能再吃掉不随时间变的不可观测差异。用「PSM-DID」,两件事一起做。
- 有多期面板且你愿意论证平行趋势:不必匹配,直接用「双重差分(DID)」,它还能给事件研究的逐期动态效应。
- 是否受处理由一条分数线决定:分配规则已知,用「断点回归(RD)」,识别力比匹配强得多。
- 担心的是没测到的混杂,而你手上有一个只影响处理、不影响结局的外生变量:匹配对未观测混杂无能为力,这种情况用「两阶段回归」。
- 偏误来自“结果变量只在部分样本上看得到”(只有在职者才有工资),而不是“谁接受了处理”:这是样本选择问题,用「Heckman两步法」。
- 你其实只想在回归里控制一组协变量,并不关心两组可不可比:那就用「线性回归 (最小二乘法)」。卡④ 的全样本回归调整行(演示数据 0.699)与匹配后 ATT(0.703)几乎相同时,匹配这一步并没有带来额外信息。
容易误读的地方
- 均衡性检验通过,只证明“已经放进去的那些协变量”被平衡了。 卡① 把可忽略性假设的判定直接写成“无法验证”:这个假设在数学上不可被数据检验,均衡性表只能证明已纳入的变量被平衡,排不掉未观测混杂。卡④ 里四种估计量落在 [0.699, 0.842] 也一样——结论文案明说,它们一致只说明结论对函数形式稳健,不能说明不存在未观测混杂。
- 匹配率高不等于匹配好,卡钳才是决定成败的那个旋钮。 实测把卡钳倍数改成 999(等于不设卡钳):匹配率从 57.8% 升到 96.1%,看着漂亮,可平均 |SMD| 只从 57.3% 降到 55.6%、最大 |SMD| 仍有 93.7%,卡① 直接点名两个协变量未达均衡,ATT 是 1.328——与完全不做匹配的朴素组间差 1.333 几乎一样。默认卡钳下 ATT 是 0.703,与同一张表里的双重稳健回归 0.702、全样本 OLS 0.699 互相印证。先看 SMD,再看匹配率。
- 加了卡钳,ATT 的对象就变小了,必须连丢弃数一起报。 演示数据 204 个处理单元只匹配上 118 个,86 个因卡钳内找不到对照被丢弃,匹配后的“实验组均值”7.127 也不再等于匹配前的 7.487。卡⑤ 的报告规范说得很重:用了卡钳却不报丢了多少处理单元,等于隐瞒了 ATT 的估计目标已经变小这件事。此时的结论只对“卡钳邻域内有可比对照的那部分处理个体”成立。
- 换成半径匹配,配对 t 的标准误会明显偏小。 实测切到半径匹配(半径 0.05):匹配率 93.1%,但工作年限的 |SMD| 由 9.4% 变成 14.5%、家庭人口数的方差比高达 15.34;更要紧的是配对 t 给的标准误是 0.041,而 Abadie-Imbens 两种口径都给 0.085,差了一倍以上——因为半径匹配下一个对照会被多个处理单元重复使用,配对 t 看不见这件事。用半径匹配时应报卡② 那张口径对照表,而不是只报主设定那一行。
- 倾向得分模型的系数不是研究结论。 表注写明该模型只用于生成倾向得分,其系数的显著性不应作因果解读。演示数据里受教育年限的 Logit 系数 0.3722 说的是“学历越高越可能去参加培训”,不是“学历让收入涨了多少”。同理,Pseudo R² 也不是越高越好:卡① 的说明指出它过高意味着两组几乎可完全区分、重叠会很差,过低则说明协变量与处理无关、匹配没有价值。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(平均处理效应 ATT)
- 输出结果三:可视化(均衡性与倾向得分分布)
- 输出结果四:效应量与事后分析(效应量·均衡改进·替代估计量)
- 输出结果五:结论与学术表述
- 附表:匹配明细(可下载全量)
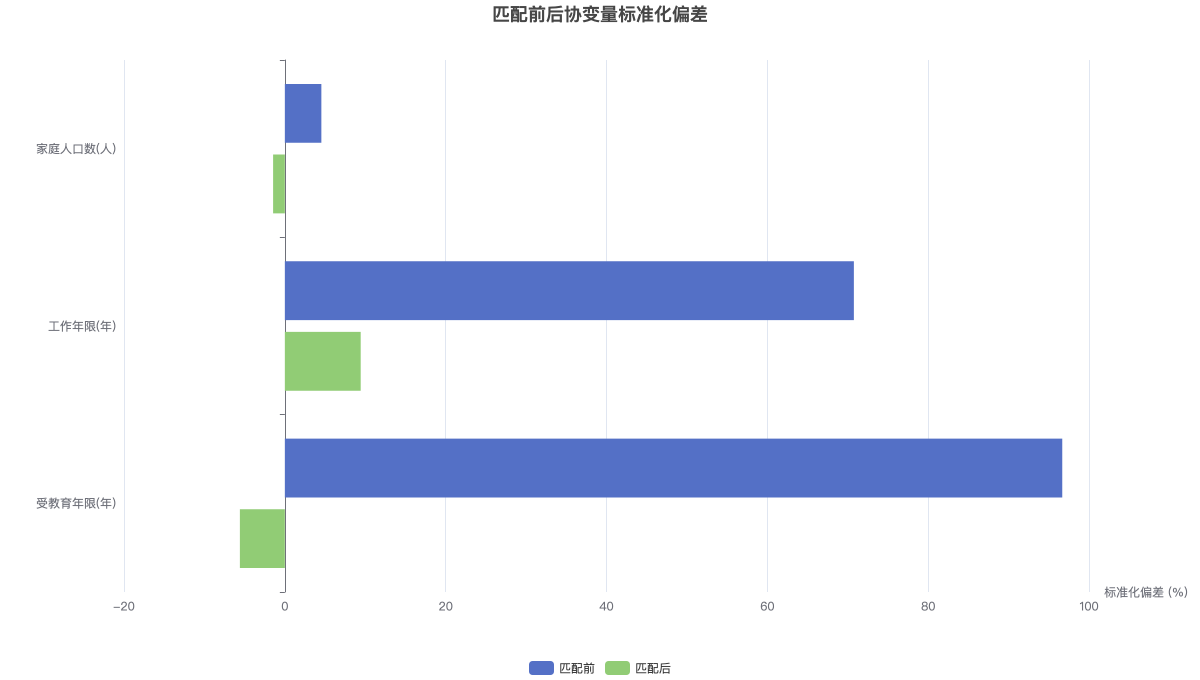
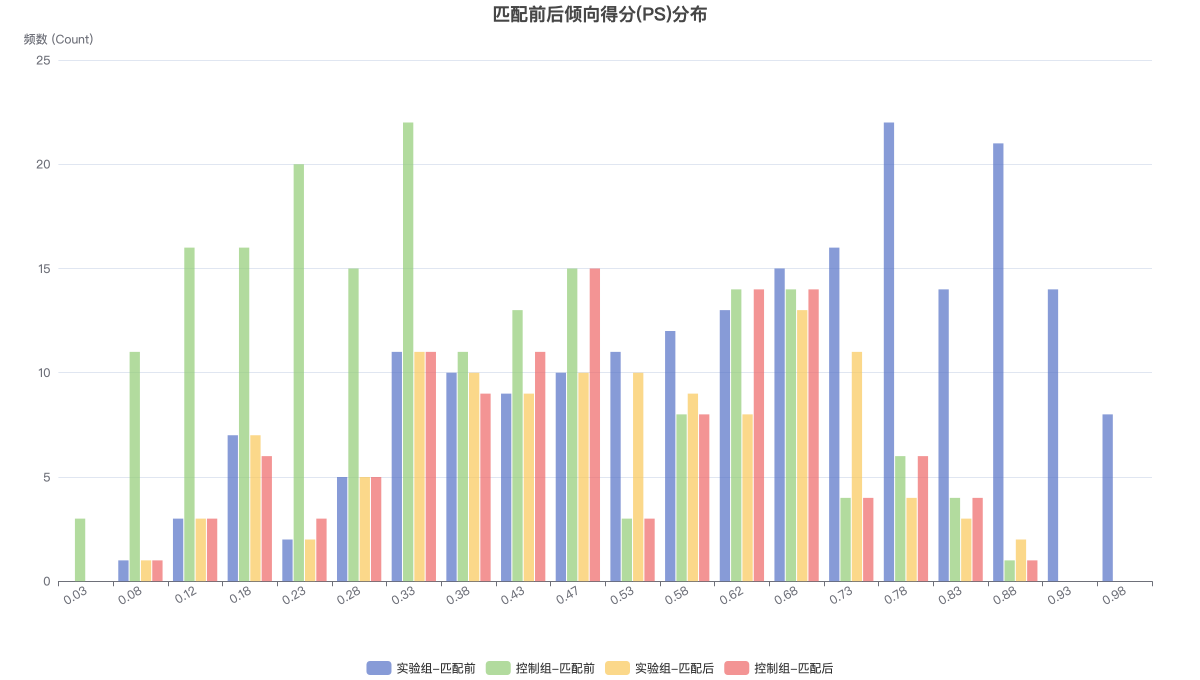
上图为各协变量匹配前后的标准化偏差对比,下图为两组倾向得分的分布重叠情况。