
极端随机树分类
这个方法是做什么的
和随机森林一样用一群树投票来预测类别,区别在于切分阈值也是抽签抽出来的:普通决策树在候选特征上遍历所有可能的切点、挑信息增益最大的那个,极端随机树则给每个候选特征随机丢一个切点,只在这几个随机切点里选最好的。少了“挑最优切点”这一步,单棵树更弱、更不贴合训练数据,但树与树之间的相关性更低,投票平均下来方差更小,训练也更快。因变量是定类列,自变量可同时含定量与定类,定类列在管线内做独热编码;和这一族其它模块一样,它不产出任何系数或 p 值。
报告共五张卡:卡① 建模设置、类别分布与八项前提体检;卡② 分层 5 折交叉验证的主结果表加无信息率检验;卡③ 混淆矩阵、ROC、PR 与逐类别指标四张图;卡④ 逐类别派生指标、效应量的 Bootstrap 区间与置换重要性;卡⑤ 论文表述。本模块读表4 时有一处必须先知道:这张表没有“训练折均值”那一列(同族的回归模块有)。而本模块默认“最小叶节点样本数=1、最大深度=不限”,每个训练样本都能独占一片叶子,实测训练集回代正确率就是 1.0000——也就是说过拟合的落差客观存在,却在报告里没有任何一格能显示它,只能改看“折间标准差”与 95%CI 的宽度。
需要准备什么数据
- 放入因变量Y:不限
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入因变量Y」的类别数需在 2~20 之间。
- 「放入因变量Y」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 类别边界很不规则,切一刀不够、需要很多刀,而你说不清该按哪个变量先切
- 自变量个数不算少、又希望训练快一点,随机森林在每个节点搜全部切点太慢
- 想要一个方差更小的树集成结果,用来和随机森林或提升树的结论互相印证
- 只需要“判得准不准”和“哪些变量被用上了”,不需要可解释的效应量
前提:因变量是定类列,2~20 个类别、每类至少 5 例;整表至少 30 行。样本量还有一层本模块特有的下限:随机切分要靠足够的样本才能“抽到好切点”,样本过少时各棵树会高度相似,降方差的机制随之失效——卡① 表3 第一行给出实测的 N/p 与判定。含缺失的整行会被剔除;同一列不得同时进因变量区与自变量区。
什么时候不要用它
- 因变量是连续数值:用「极端随机树回归」。
- 要报告每个自变量的效应量与显著性:本模块一项都不给;二分类结局用「逻辑回归」,多分类且需要可解释规则用「CHAID决策树」。
- 样本量只有几十条:随机切分在小样本上几乎等同于乱切,集成也救不回来;这种规模下参数更省的方法更稳,判别变量全为定量时用「线性判别分析」,否则用「逻辑回归」。
- 自变量里混着大量与结局无关的列:随机切点会不断把这些列切进树里,稀释真正有用的信息;先用「特征筛选」压掉无关列再回来。
- 观测之间不独立(重复测量、班级/医院内嵌套):交叉验证会把同一个体拆到两边,性能虚高;用「混合模型」或「面板模型」。
容易误读的地方
- “随机性更强”是关于方差的说法,不是关于准确率的承诺。 卡① 的方法学说明写的是“通常能进一步降低方差、提升泛化稳定性”——降低的是换一批数据重训时结果的抖动,偏差可能同时上升。演示数据上交叉验证 Accuracy=0.7458、Macro-F1=0.7443、κ=0.4909,卡④ 判为“中等(moderate)”。要判断它是不是比别的算法好,只能在同一份数据上分别跑一遍再比交叉验证均值,并且要连折间标准差一起看,不能拿两个模块各自演示数据上的数字对照。
- “随机种子”这一个控件同时决定五件事。 它既是每棵树抽切点的种子,也决定留出测试集怎么划、交叉验证怎么分折、卡④ 效应量 Bootstrap(B=800)怎么重抽、以及表8 置换重要性那 10 次重排。所以“换个种子看看稳不稳”换掉的不只是模型的随机性。实测:只改种子、其余全不动重跑九次,κ 落在 0.4246~0.4909 之间;而卡⑤ 的综合判定把 κ≥0.41 当作可用性门槛之一,实测最低的那一次离这条线只剩 0.0146。
- 表8 里“区间跨 0”不等于这个变量没用。 演示数据里“促销折扣力度(%)”的 ΔF1=0.0203、95%CI[−0.0227, 0.0633],判为“贡献不稳定”;而“广告投入(万元)”是 0.1120、CI[0.0831, 0.1409]。这只说明在留出的那 48 例上、打乱它之后 Macro-F1 的下降幅度在 10 次重排之间不稳,样本量小与重复次数少都会把区间撑宽。它既不能推出“这个变量与结局无关”,也不能拿来做变量筛选的判据。
- 树的数量对本模块比对随机森林更要紧。 每棵极端随机树都比一棵普通决策树更“随意”,集成要靠数量把这层额外随机性平均掉。默认 100 棵是够用的起点,但当你发现折间标准差偏大、或换种子结果跳动明显时,第一个该调大的是“树的数量”而不是深度——加树只降方差、不增加过拟合。反过来,想压训练与验证之间的落差要动“最小叶节点样本数”与“最大深度”。
- 卡① 说“已在管线内标准化”,不代表尺度对本模块有影响。 表3 的“特征尺度差异”行在这一族八个模块里是同一段文字,它明确写着标准化“对距离/间隔类模型(KNN、SVM)必要”。树模型按单个变量找切点,任何单调变换都不改变切分结果,这一行对本模块只是流程说明。真正要看的是同一张表里的“标签泄漏扫描(NMI)”与“完全重复记录”两行——它们才会让交叉验证的成绩虚高。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:交叉验证性能主结果表
- 输出结果三:分类效果可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
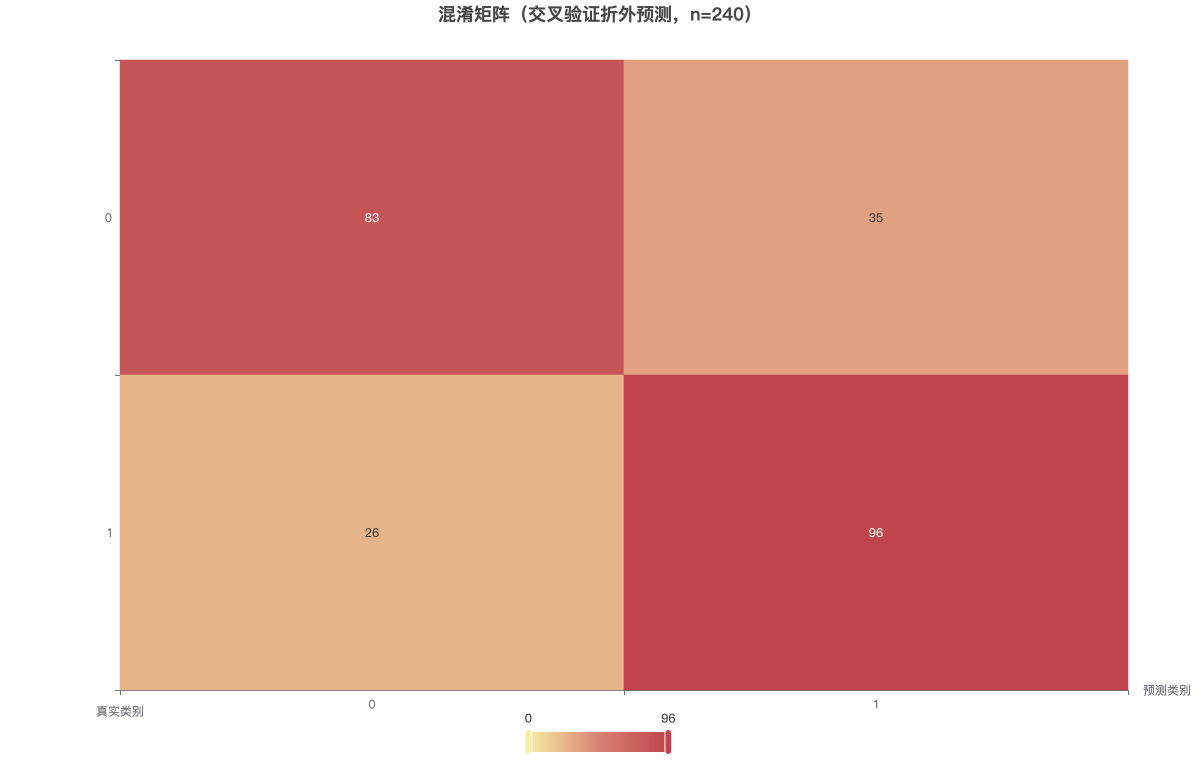
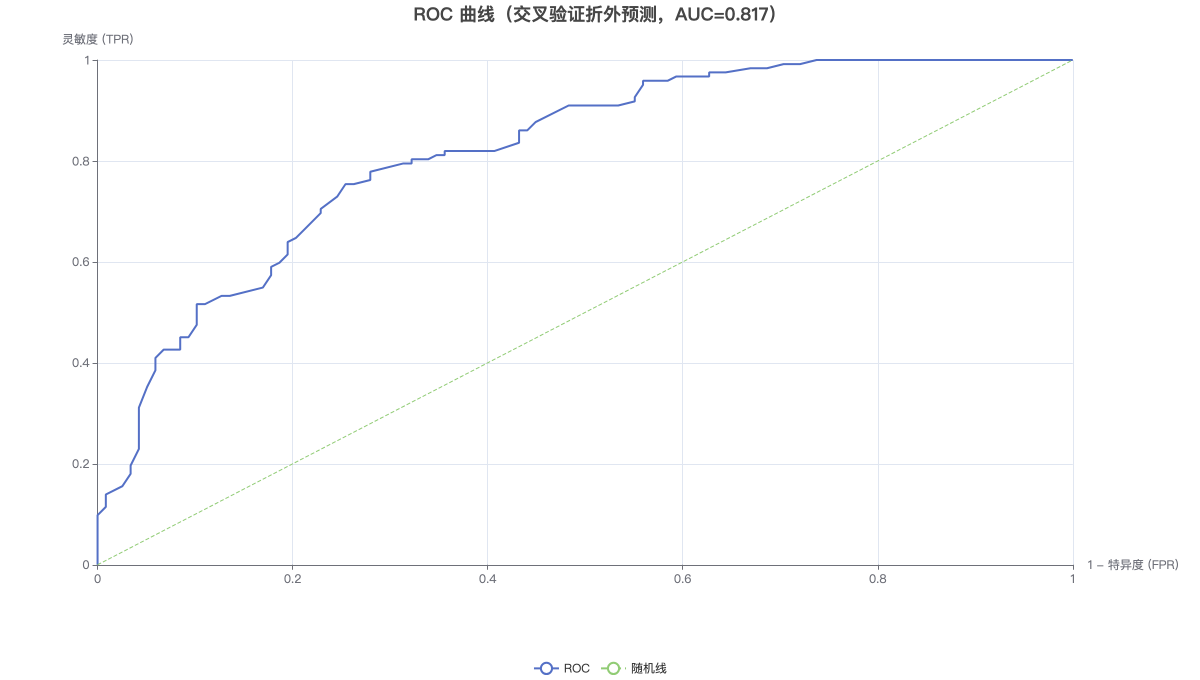
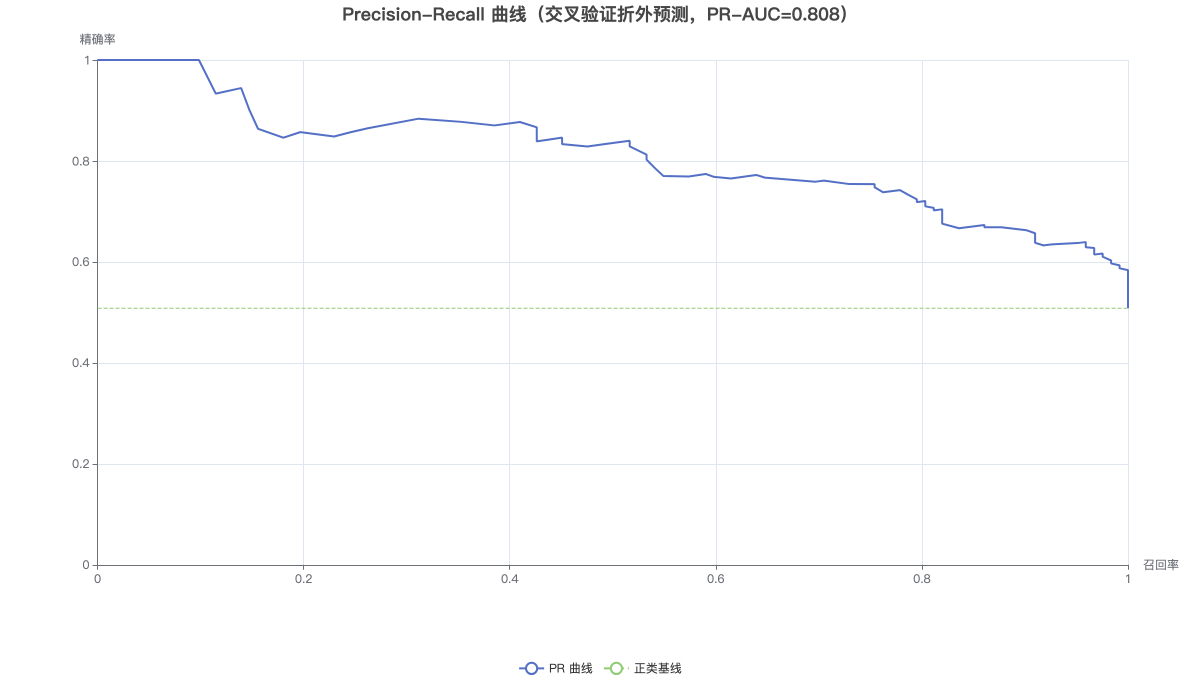
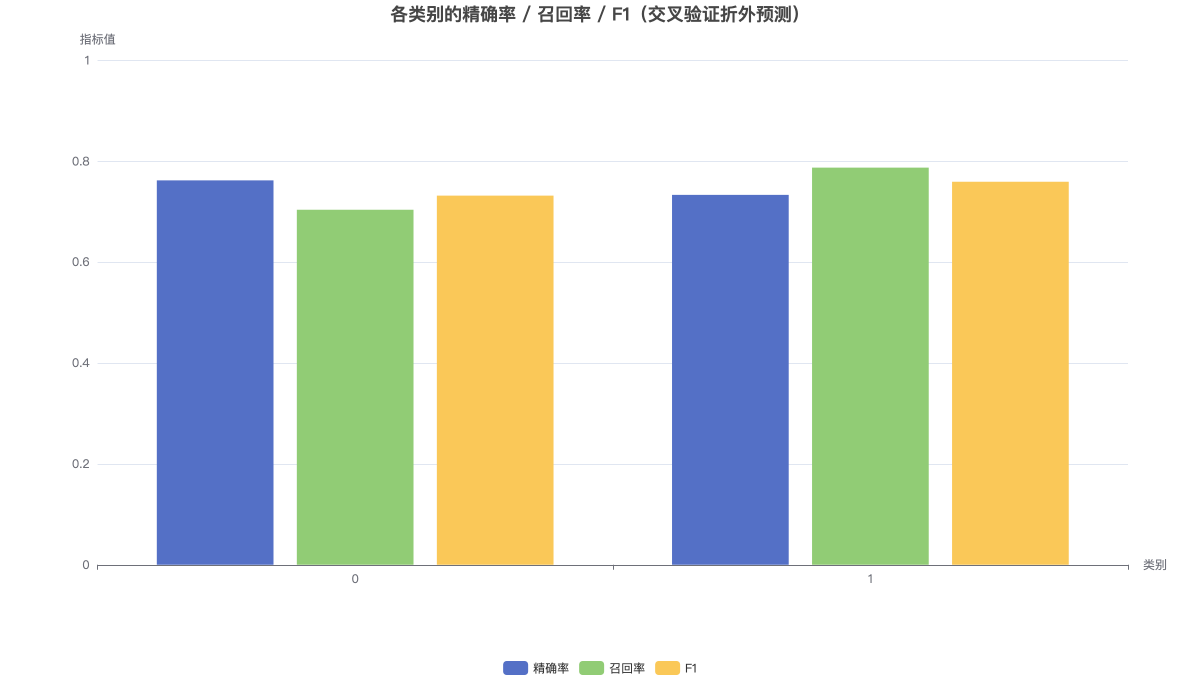
卡③ 全部基于交叉验证折外预测绘制:混淆矩阵与曲线所用的预测都来自模型未见过该样本的那一折,不是训练集回代结果。