
情感分析
这个方法是做什么的
对一列中文文本逐条打一个情感得分,再汇总成正面、中性、负面三类的条数与占比。得分来自 SnowNLP 的 sentiments——它是一个在电商评论语料上训练出来的朴素贝叶斯分类器,不是情感词典打分,所以模块里没有可替换的词表、也没有可调的阈值。输出是"这条文本像正面评论的概率",取值 0 到 1;判定规则固定为得分大于 0.6 记正面、小于 0.4 记负面、其余记中性。
除了三类占比,报告还给了三样东西用来判断这些占比可不可信:各极性占比的 Wilson 95% 置信区间与平均得分的 t 区间;打分覆盖度、强正面(≥0.9)与强负面(≤0.1)的规模、模糊区(0.45~0.55)占比、得分分位数与双峰系数 BC;以及一张得分最高与最低各不超过 5 条的原文表,专门用来人工核验模型判得对不对。不含中文字符的行会被剔除而不是记 0.5——因为那种情况下模型只是退回先验值,不是真的判成了中性。
需要准备什么数据
- 放入[文本]待分析列:不限
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 90%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 一批评论、开放题作答、客服工单,先看整体口碑偏正还是偏负
- 想知道强负面(得分 ≤ 0.1)与强正面(≥ 0.9)各占多大规模——第四张卡给的是条数与占比
- 判断评价是普遍温和还是两极分化(看双峰系数与得分分位数)
- 需要一个可写进报告的口碑描述:三类占比各带 Wilson 95% 置信区间,平均得分带 t 区间
前提是这一列为自然语言中文短文本,每行一条。纯数字列、编码列、极短标签列不适用;文体越接近电商评论,判定越准。
什么时候不要用它
- 你想知道用户在说什么内容,而不是好恶:情感分析只给一个方向,不给话题,用「词频统计」看说得最多的词、用「TF-IDF关键词提取」看有区分度的词、用「LDA主题模型」做主题聚合。
- 你手上已经有李克特量表评分或满意度打分:那是数值,不必再从文字里估情感,直接用「描述性统计」,组间比较用「独立样本T检验」。
- 你要比较两组(如新老客户)的正负面占比:本模块不分组、不做组间比较,也不把逐条得分或极性写回数据表——报告里唯一的逐条内容是卡2 那不超过 10 条示例原文,没有别的出口。要比较两组的极性构成,得先另行取得每条文本的极性标签(如人工编码),再用「卡方检验」。
- 文本是新闻、病历、判决书、学术摘要这类非评论文体:训练语料不匹配,偏差会明显增大。这种情况下应做人工编码,先用「Kappa一致性检验」确认两名编码者判得一致,再用「频数分析」统计。
- 你要测的是推荐意愿而不是文字情绪:0~10 分的推荐打分用「NPS净推荐值分析」。
容易误读的地方
- 情感得分不是"用户满意度",平均分 0.751 不等于"满意度 75 分"。 它是分类器给出的"这段话像正面评论的概率",是一个模型置信度,不是一把有刻度的量表。把它当分数去做前后对比、组间比较、乘权重加总,都是在给一个没有单位的量赋予单位。要报告的是三类的占比及其置信区间,而不是把平均概率当作满意度指标。
- 反讽、否定与领域术语是它最常翻车的三处。 "这也叫好用?"里全是正面词、"不推荐"分词后"推荐"仍在、医学语境里的"副作用不明显"是好话但"副作用"是负面词——朴素贝叶斯按词的出现概率加总,看不到这些结构。第二张卡给出得分最高与最低各不超过 5 条原文,就是让你逐条核验的:如果两端的原文里有明显判反的,整份占比都要打折扣,而不是只改那几条。
- 模糊区(0.45~0.55)的样本不能读成"用户态度中立"。 那是模型最没把握、得分向先验 0.5 收缩的一批,通常是文本太短、没有情感词、或者混杂了正负两面。它们被归进"中性",但"中性"里同时装着"真的不置可否"和"模型判不出来"两种完全不同的东西。这个占比偏高时,先看第一张卡的平均文本长度。
- 得分分布往往是两端堆积,此时均值比中位数更不可靠。 示例实测 P25 = 0.518、P50 = 0.982、P75 = 1.000,双峰系数 0.9162——分类器倾向于给出接近 0 或接近 1 的极端概率,中间很空。这种形状下的算术平均会被两端的相对条数拽着走,改一改阈值附近的几条就明显移动。判读应以三类占比与它们的 Wilson 区间为准,均值只作参考。
- 覆盖度是这份报告的第一道门槛,要先看它再看结论。 不含中文的行会被整行剔除,第一张卡逐项列出跳过的空行数与因无中文或打分失败被剔除的行数。覆盖度只有六七成时,剩下那部分文本未必能代表全体——被剔掉的往往是纯表情、纯数字评分、纯英文,而这些行本身可能有系统性倾向。所有占比的分母都是成功打分的条数,不是原始行数。
报告里有什么
- 输出结果一:语料概览与预处理充分性检验
- 输出结果二:总体情感分布
- 输出结果三:情感得分分布可视化
- 输出结果四:极性占比、强度分布与覆盖度指标
- 输出结果五:结论与学术表述
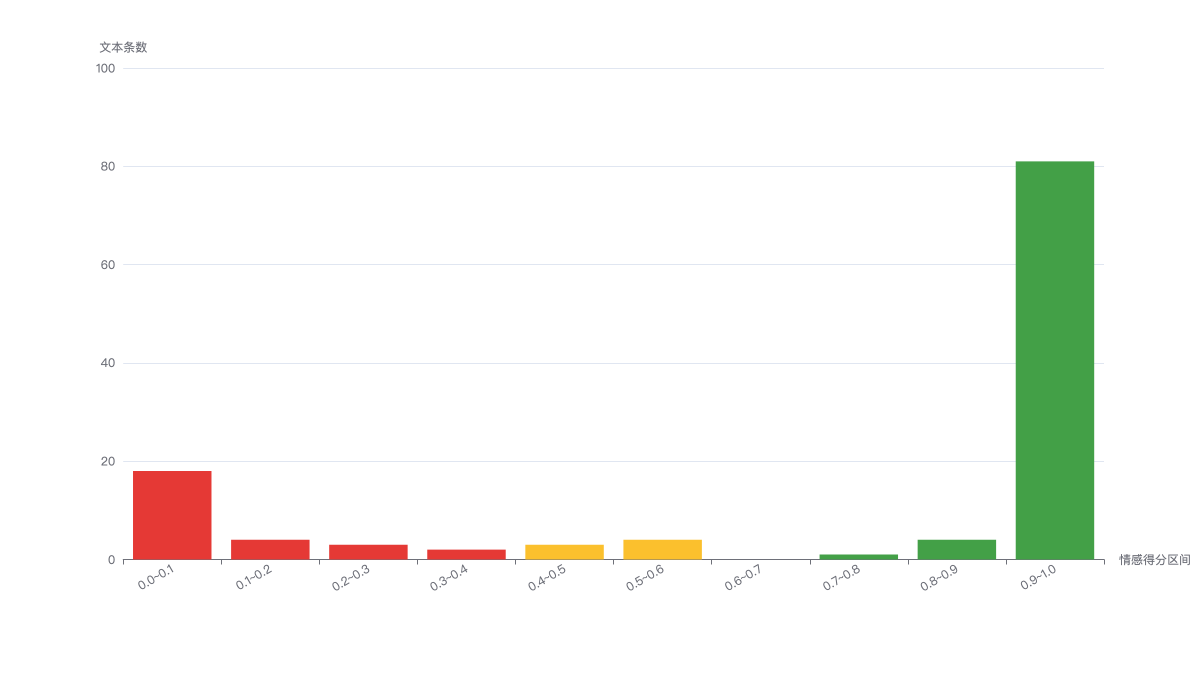
横轴为情感得分区间(0~1,共 10 段),纵轴为落入各区间的文本条数;柱色按倾向区分:绿=正面区、黄=中性区、红=负面区(着色以区间中点为准,仅作示意)。可用右上角切换器切到「表格」视图读取各区间的精确条数。