
单因素方差(ANOVA)功效
这个方法是做什么的
回答“比较三个及以上分组在同一个数值指标上的整体差异,总共需要多少样本”,以及“现有这几组数据,检出整体组间差异的把握有多大”。拖入 1 个分组变量(2~20 个水平)和 1 个定量测量变量,控件里只填显著性水平 α(默认 0.05)。效应量不是 t 族的 Cohen's d,而是方差分析自己的 Cohen's f:先由数据算出 η² = 组间平方和 / 总平方和,再取 f = √(η²/(1−η²));经验参考是 0.10 小、0.25 中、0.40 大。
卡① 逐组给样本量、均值、标准差与组内 Shapiro-Wilk,末尾两行是 Levene 方差齐性(中位数中心化)和组容量均衡度(最小组 n / 最大组 n)。卡② 给 k、N、η²、观测 f、事后功效,以及达到 80% / 90% 功效所需的总样本量(按 k 组均分外推)。卡③ 是功效随总样本量变化的曲线。卡④ 给当前 N 与 k 下的 MDES(Cohen's f)、α 取三档的功效对照与达标总样本量。卡⑤ 是论文表述模板。引擎是 scipy.stats.ncf(非中心 F),不输出 p 值。
需要准备什么数据
- 放入[定类]分组变量:1 个,定类变量(分组/标签)
- 放入[定量]测量变量:1 个,定量变量(数值)
数据要求
- 数据表至少 6 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]分组变量」的类别数需在 2~20 之间。
- 「放入[定类]分组变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 三个及以上剂量组 / 处理组的试验,论证总例数与每组例数
- 多中心或多品类的比较研究,估算整体差异的检出能力
- 已有多组数据,想知道现有规模能检出多大的 Cohen's f
- 因为要做多重比较校正、α 要收到 0.01,先看整体检验会损失多少效能
- 投稿被要求把样本量论证写进方法部分,需要 MDES 与达标总样本量
前提是各组相互独立、组内近似正态、组间方差大致相等——非中心 F 的功效公式建立在一个共同的组内方差上。卡① 把这三件事能查的部分都摆出来了:组内 Shapiro-Wilk、Levene、以及各组标准差本身。组容量均衡度那一行也要看,卡② 的外推是按各组人数相等做的。
什么时候不要用它
- 只有两组:用「两独立样本t检验功效」。两者在数学上等价(k = 2 时 F = t²),但那边直接给每组人数、分配比方案和换回原始单位的可检出均值差,比总样本量好用得多。
- 有两个及以上因素、或者要考察交互作用:分析用「双因素方差分析」或「多因素方差分析」。产品没有多因素设计的功效模块,把其中一个因素单拎出来跑本模块会忽略另一因素解释掉的变异,结果偏保守。
- 同一批对象被重复测量:用「重复测量方差分析」做分析;产品没有它的功效模块,若只比较其中两个时点,可用「配对t检验功效」。
- 真正关心的是某两组之间的差:本模块只算整体检验的功效,两两比较请用「事后多重比较」,其样本量需求要单独估。
- 要在比较组间差异时扣掉协变量:用「协方差分析」。产品没有它的功效模块;控制协变量会压低残差方差,本模块给出的总样本量在这种设计下偏保守。
- 数据严重偏态或是等级评分:检验改用「多独立样本Kruskal-Wallis检验」;产品没有非参数功效模块,常见做法是在本模块的总样本量上加 10%~15%。
容易误读的地方
- 这是整体检验的功效,不是你关心的那一对比较的功效。 omnibus F 的原假设是“k 个组的均值全相等”,拒绝它只说明至少有一对不同。卡④ 的图注写明本模块“不存在组间事后多重比较”。实际研究常常真正想问“A 组和 C 组差多少”,那一对的功效通常明显低于整体功效——两两比较要把 α 摊到多个比较上(3 组 3 对,Bonferroni 后 α ≈ 0.0167),效能随之下降。想估这个,可以把校正后的 α 填进「两独立样本t检验功效」的 α 控件逐对算。
- F 检验是单尾的,别照抄 t 检验的“双侧 α = 0.05”。 卡② 表注和卡⑤ 都专门写了这句:临界值取 F₁₋α(df₁, df₂),α 全部置于 F 分布右尾,方差分析里根本不存在“双侧 α”这回事。写方法部分时把 t 族的措辞直接搬过来是常见错误。
- 卡② 的事后功效由本次数据的 η² 反推,与单因素方差分析的 p 值一一对应。 本模块只有 α 一个控件,没有地方输入目标效应量,f 只能由这批数据估。所以“功效 0.9992”和“这次 F 很显著”是同一件事换了个说法,它不提供任何关于设计好坏的新信息,更不能用来解释“为什么没做出显著结果”。卡⑤ 的【方法学提示】把这一点写在了报告正文里。
- 样本 η² 偏大,而本模块没有保守情景表。 样本 η² 是总体效应的有偏(偏大)估计,组数越多、每组越小偏得越厉害,由它推出的 f 与达标样本量都偏乐观(文献里常报的 ω²、ε² 就是为纠这个偏)。两独立样本、配对、两比例、线性回归那四个功效模块的卡④ 有“观测效应量 ×0.5 / ×0.75”的情景表,本模块没有,只能自己折算:卡② 的结论文案给了比例关系——效应量减半,所需样本量约变 4 倍。真正该代入的 f 来自文献或专业上有意义的最小差异。
- 卡② 的总样本量是按各组均分算的。 组容量均衡度显著小于 1 时(模块在低于 0.5 时会明确提示),现实中招不到均衡的组,实际所需总量会比这个数大。同理,Levene 不显著不等于方差相等——非中心 F 的功效建立在共同组内方差上,各组标准差差异明显时(卡① 逐组列了标准差),把结论当成近似值来用,别当精确数。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:功效与所需样本量
- 输出结果三:功效曲线
- 输出结果四:敏感性分析(MDES / α 敏感性 / 达标样本量)
- 输出结果五:结论与样本量报告表述
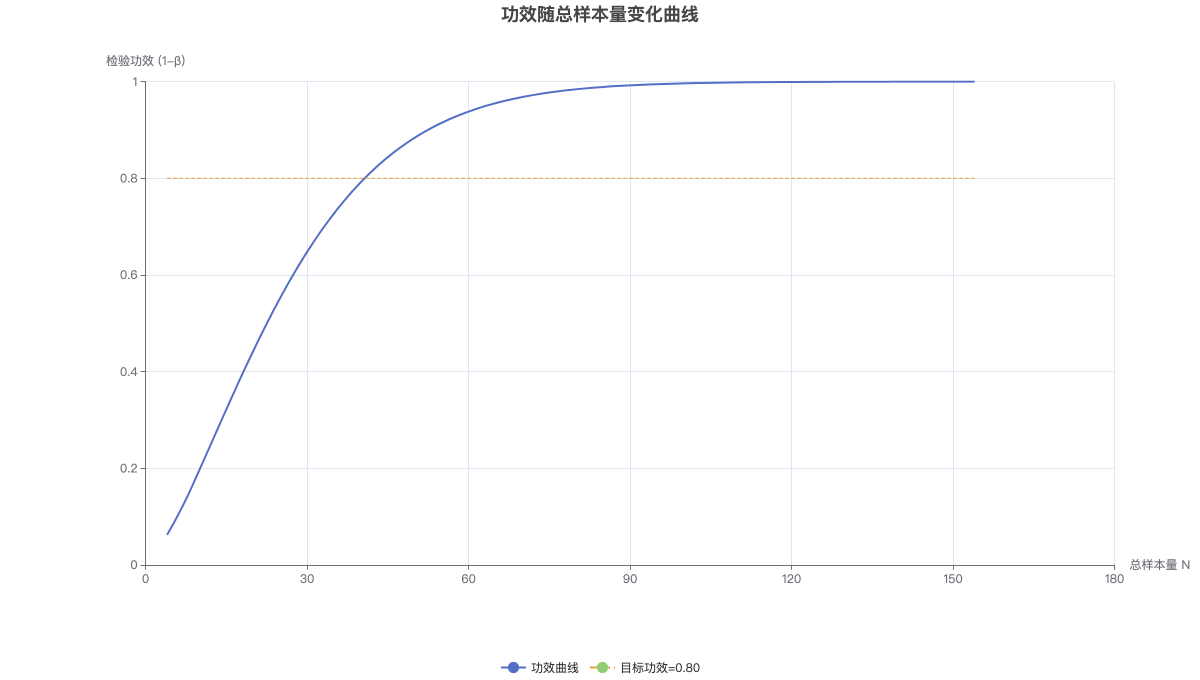
横轴为总样本量 N,纵轴为检验功效(1-β),橙色虚线为目标功效 0.80 参考线;可切换为表视图查看逐点采样值。