
混合模型
这个方法是做什么的
因变量是数值型连续量,而观测按某个分类变量成组——同一个被试的多次测量、同一所学校的学生、同一家门店的多个月份。普通最小二乘会把“同组更像”当成随机误差,于是低估标准误、把 p 值算得过小。混合模型把变异显式拆成两层:固定效应回答“自变量每变一个单位,因变量平均变多少(组间差异已被控制)”,随机效应回答“组与组之间的基线差异有多大”。随机效应区收定类变量、可以放不止一个;固定效应区允许留空,那就是只估方差结构的空模型。因变量必须是定量列,数据按长格式给(一行一次观测)。
除了固定效应的系数、95% 区间与逐项联合 Wald 检验,报告还给:方差分解(每个随机效应一行 + 残差一行,含占总方差的比例)、主模型 ICC 与空模型 ICC、Nakagawa 边际 R²m 与条件 R²c、残差的 Shapiro-Wilk 正态性检验。估计用 REML,三套优化策略并跑、取似然最高的收敛解。
需要准备什么数据
- 拖入[定量]变量:1 个,定量变量(数值)
- 拖入[定量]或[分类]变量(可选):至少 0 个
- 拖入[分类]变量:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「拖入[分类]变量」的类别数需在 2~200 之间。
- 「拖入[分类]变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 同一批被试在多个时间点的量表得分,且要在比较时点的同时扣掉基线等协变量
- 长格式数据、各人测量次数不一致、有缺失又不想整例剔除的重复测量
- 学生嵌在班级里、患者嵌在医院里,既要固定效应又要知道组间差异占多少
- 多中心试验:中心是从许多可能的中心里抽来的,你并不打算逐个比较它们
随机效应变量必须是定类,至少 2 个水平、每组至少 2 个观测——只含 1 个观测的组无法把组内变异与残差分开。组数少于 5 时方差分量极不稳定,卡① 会如实报出组数与组容量并打“注意”。卡① 另有固定效应的 VIF 与残差正态性检验;那张表里标着“未做”的行表示本次没执行,不代表前提成立。
什么时候不要用它
- 因变量是计数或二分类:用「广义线性混合模型(GLMM)」;完全没有分组结构的计数直接用「计数数据回归」。
- 只关心总体平均效应:因变量是正态连续时不必转走——恒等链接下把随机效应边缘化后 E[Y|X] 仍是 Xβ,本模块的固定效应本身就是总体平均效应;“个体内效应 vs 人群平均效应”的分歧只在 logit/log 这类非线性链接下才出现,而「广义估计方程(GEE)」没有高斯族、根本收不下正态连续因变量。真正的代价在标准误:本模块只给 REML 的模型基标准误,没有稳健(三明治)标准误,随机结构设错时它不会替你兜底。
- 数据是宽表、每人测量次数完全一致、也不打算放协变量:用「重复测量方差分析」更直接,它给球形度检验与三套自由度校正。
- 分组本身就是你要比较的、可穷举的固定处理(试验组/对照组),且每个个体只测一次:这时它是固定效应而不是随机效应,用「双因素方差分析」;要同时扣掉协变量用「协方差分析」。
- 只想把总变异拆成几个来源,并不打算解释固定效应系数:用「方差成分分析」。
- 怀疑不同组的斜率本身不同:本模块只拟合随机截距,卡⑤ 的解释边界写明“不含随机斜率”。产品内可行的做法是把分组变量与自变量的交互项当固定效应放进「线性回归 (最小二乘法)」,或分组别各跑一次「线性回归 (最小二乘法)」再比较斜率。
容易误读的地方
- 放两个随机效应变量时它们是并列(交叉)的方差分量,不是嵌套;内层编号在外层之间重复,会被当成同一个组。 实测同一份 150 行数据(2 所学校各 3 个班):班级列写成“1/2/3”(每校重复编号)时,卡① 的分组结构表把班级记成 3 组,班级方差 0.2396、占 1.64%;把班级列改写成全局唯一的“S1-1…S2-3”后记成 6 组,班级方差变成 4.2797、占 30.98%,残差同时从 3.5384 掉到 0.8829。前一种把两所学校的“1 班”当成了同一个班,组间差异被摊平。动手前先核对卡① 分组结构表里的“组数”对不对,不对就回数据处理里把内外层拼成一个唯一标识列。
- 拟合失败时会自动换成 OLS,方差分量、ICC 与 R² 全部变成“未做”。 回退后的模型是“把随机效应变量当作普通固定因子”的最小二乘。卡① 会印一条以“您定义的混合模型未能成功拟合”开头的说明,并写明不得据此认为组间差异为零——但主结果表看上去和正常情况没什么两样。所以看到卡④ 的方差分解整片“未做”,不要以为是这次组间差异恰好为 0。
- 卡① 的空模型 ICC 与卡④ 的主模型 ICC 不是同一个数,而且可能一个大一个小。 表注写死了口径:空模型 ICC 由“只含截距 + 同一随机结构”单独拟合,回答“有没有必要分组”;主模型 ICC 是控制固定效应之后还剩多少组间差异。示例数据里前者 0.2042、后者 0.3335——加了固定效应之后 ICC 反而升高,这不矛盾:固定效应主要吸走的是组内的残差变异,组间那部分在剩余变异里的占比就上去了。论文里报 ICC 必须写明是哪一个口径。
- R²m 与 R²c 的分母含随机效应方差,不能和普通回归的 R² 放在一起比大小。 Nakagawa 的 R²m 是固定效应预测值的方差除以(固定 + 组间 + 残差),R²c 把组间方差挪进分子。示例数据 R²m = 0.4634、R²c = 0.6424,差值 0.1789 才是分组结构的独立贡献。同一批自变量拿去跑「线性回归 (最小二乘法)」得到的 R² 与这两个数都不是一回事,据此说“混合模型解释力更高”是错的。另外这里的对数似然是 REML 口径,表里已写明只能在固定效应结构相同的模型之间比较——拿它去比不同自变量集合是无效的。
- 一个变量该不该进随机效应区,取决于“这些水平是不是从更大的总体里抽来的”,不取决于它是不是分类变量。 只有当你不关心“这几个具体的组”、而关心“组这一层带来多少变异”时,它才该放进去。把只有两个水平的试验组/对照组放进随机效应区(示例数据正是如此),报告会照跑并给出 ICC = 0.3335,但卡① 同时打出“注意:仅 2 个水平,组数过少会使随机效应方差的估计极不稳定,其置信区间通常不可信”——这条不是在提醒你样本量不够,是在提醒你变量放错了拖拽区。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:固定效应估计与联合检验
- 输出结果三:固定效应森林图与方差分解可视化
- 输出结果四:方差分量、ICC 与 R² 效应量
- 输出结果五:结论与学术表述
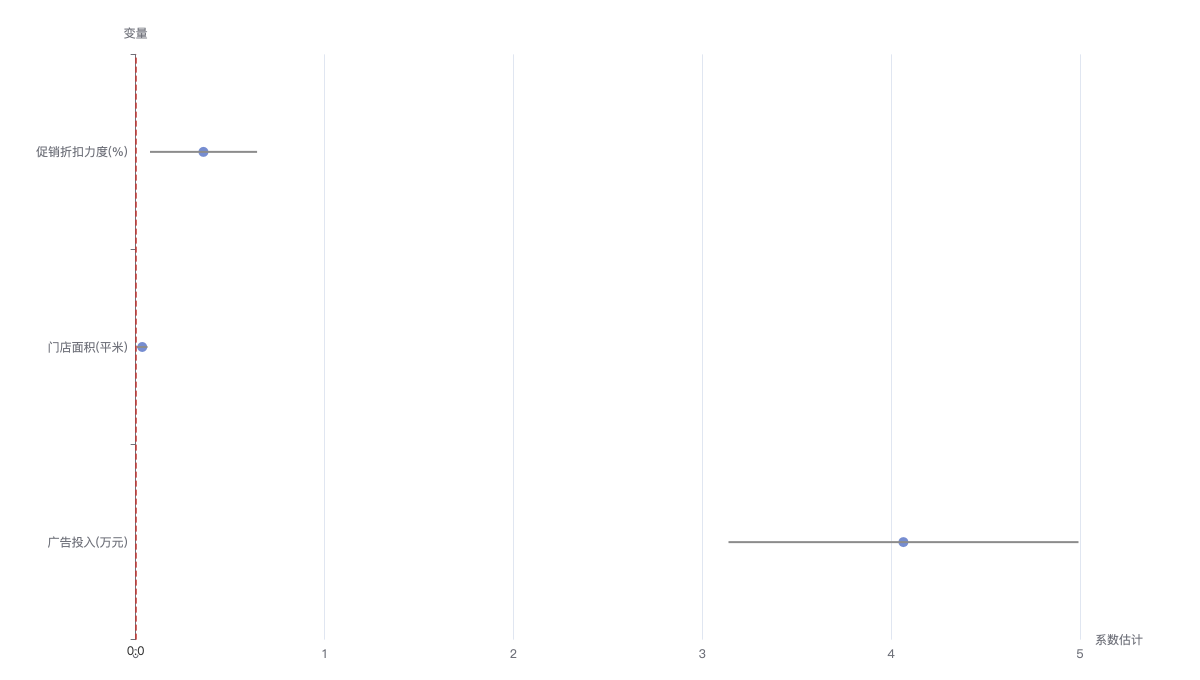
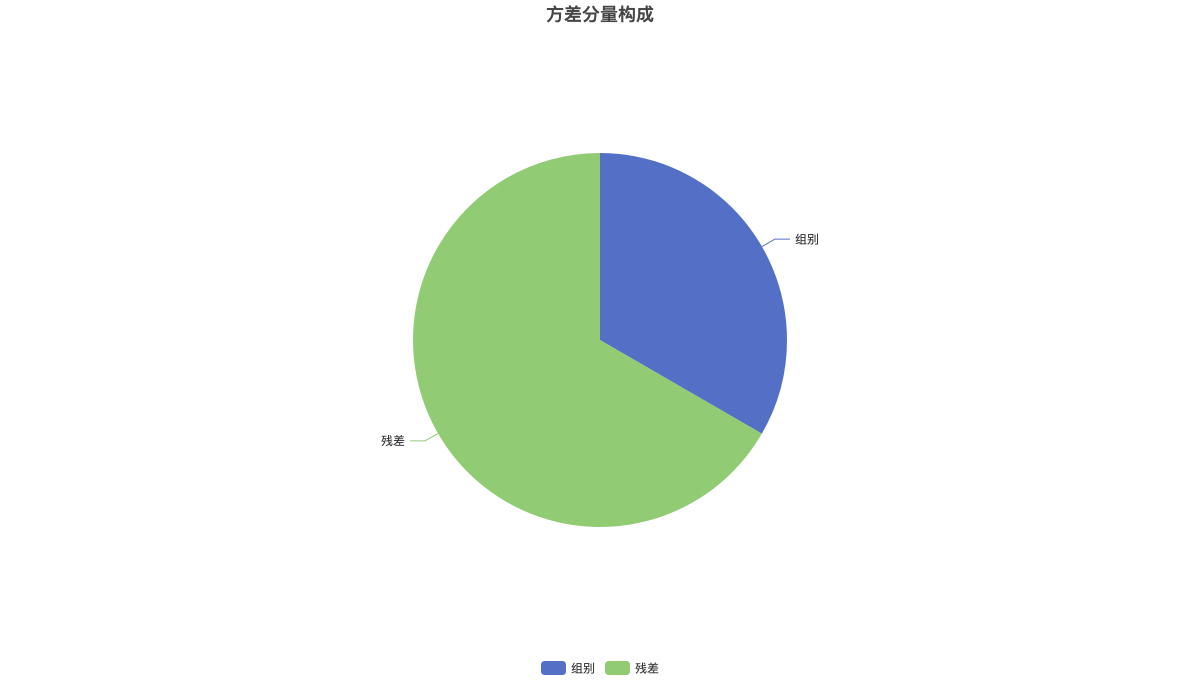
图形读法:圆点为各固定效应的系数点估计,横向须线为其 95% 置信区间;红色虚线为零参考线。置信区间跨越红色零线(即包含 0)表示该效应不显著(灰点),不跨越则显著(蓝点),须线越窄表示估计越精确。注:截距量级远超其它系数会压扁图形,本图已略去截距,仅展示各斜率系数。