
列联(交叉)分析
这个方法是做什么的
把一个行变量与每一个列变量交叉成列联表,给出逐格的频数与百分比,并对每一对做 Pearson 卡方独立性检验。行变量只能放 1 个,列变量可以放多个——它会一对一对地扫过去,因此适合“拿一个人口学变量去横扫一批单选题”这种活。频数低于 5 的稀疏类别会被自动并入“其他”——只对非数值型的分类列生效,用 1/2/3 数值编码的定类变量完全不合并;卡① 会写明哪些变量触发了合并。
除了 p 值,它还回答关联有多强、来自哪一格。强度用 Cramér's V(附 800 次 Bootstrap 的偏倚校正区间)、φ 系数与列联系数 C,2×2 表另给优势比 OR 与相对风险 RR;来源用调整标准化残差,卡③ 画成热力图、卡④ 列成逐格事后表。多对变量同时检验时,主结果表另有一列 Holm 校正后的 p,控制“扫这么多对”带来的族错误率。
需要准备什么数据
- 行变量(分类字段):定类变量(分组/标签)
- 列变量(可多选):至少 1 个,定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 「行变量(分类字段)」的类别数需在 2~20 之间。
- 「列变量(可多选)」的类别数需在 2~20 之间。
- 「行变量(分类字段)」的每一组至少 5 个样本。
- 「列变量(可多选)」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 用性别、学历、地区这类分组变量,同时对若干道单选题做交叉扫描
- 问卷报告里的交叉分析表:各组的构成比、堆积百分比图
- 需要在一份报告里同时拿到列联表、检验、效应量与逐格残差定位
- 2×2 的暴露—结局表,要优势比 OR 与相对风险 RR 及其置信区间
行变量与列变量都必须是定类变量,各自 2~20 个类别;总行数不少于 30,每个类别至少 5 条记录;含缺失的记录按所选变量整行剔除;同一列不能同时放进行变量区与列变量区。最要紧的前提是每个观测只被计一次且观测之间相互独立——这条无法由数据检验,只能由研究设计保证。
什么时候不要用它
- 同一批人被测了两次(干预前后是否达标、改版前后是否点击):这是配对的分类数据,独立性前提不成立,用「配对卡方检验」。
- 需要 Cohen's w 或 Bergsma 偏差校正的 V:本模块的效应量位给的是 Cramér's V(连同 φ、列联系数、2×2 的 OR/RR),没有这两个量,用「卡方检验」。逐格的观测与期望频数不必为此换模块——卡④ 的调整标准化残差表已经逐格给出 O、E 与 Holm 校正后的 p。
- 期望频数条件不满足:2×2 表改看「Fisher精确检验」或「Yates校正卡方检验」;更大的表本模块不做精确检验,只能先把语义相近的低频类别在“数据标签”里合并,或改用「卡方检验」查看逐格期望频数后再决定怎么并。
- 要检验单个分类变量的分布是否符合某个理论比例(而不是两个变量的关联):用「卡方拟合优度检验」;只想要各类别的频数与占比,用「频数分析」。
- 需要在第三个变量分层之后再看关联(控制混杂):本模块不做分层,用「分层卡方分析」。
- 表里填的是均值、金额或比例而不是计数:卡方的输入必须是计数。想比较各组的平均水平,两组用「独立样本T检验」、三组及以上用「单因素方差分析」;只做描述用「分类汇总」。
容易误读的地方
- 频数低于 5 的类别被自动并入“其他”后,那一类的语义已经不是原来的了。 合并阈值恒为 5,界面上没有改它的入口。卡① 的类别结构表会同时给出原类别数与分析用类别数,两者不等就说明触发了合并(示例数据没有触发,所以两列相同);数值编码的定类变量不参与合并,那两列永远相同,别据此以为“这批数据没有低频类别”。“其他”是若干个互不相干的稀疏水平的集合,对它做任何实质解释——比如“其他组的重度比例最高”——都没有意义。要保住语义,应先按业务把低频类别归并好再进来,而不是交给阈值。
- 列百分比的分母是行变量的每个类别,不是全表。 表格展示时行变量摊成各列、列变量摊成各行:示例中 72(43.64%) 的分母是“不吸烟”的 165 人,所以同一列的百分比加起来才是 100%。把 15.76% 读成“占全部 300 人的比例”是错的;读成“重度患者里有 15.76% 不吸烟”也是错的——后者是行百分比,实际是 26/69≈37.7%,要在卡③ 的图上切换指标才看得到。
- 整体显著不告诉你是哪一格,而百分比最高的那一格常常不是它。 示例中 χ²(2)=24.211、p<0.001,真正扛事的是“不吸烟×轻度”(残差 4.59)与“吸烟×轻度”(−4.59);而列百分比全表最高的“吸烟×中度”(51.85%)残差只有 1.42,Holm 校正后 p=0.312,判定栏写的是“与期望无显著差异”。百分比高低说的是构成,偏离期望说的是关联,两者完全是两回事。
- 报告里有两层 Holm 校正,控制的不是同一件事。 一层在主结果表的“p (Holm 校正)”列,管的是“一个行变量同时对多个列变量做检验”;另一层在逐格事后表内部,管的是同一张表里所有格子的比较。列变量只放一个时第一层等于没校正(示例中两列 p 完全相同);列变量放到十个时,一批未校正下“显著”的结果会经不起校正。写论文时必须说清引用的是哪一个。
- 显著与有实际意义是两件事,而强度分档还按自由度调过。 示例的综合判定自己就写着:虽达统计显著,但 V=0.2841 处于弱效应区间,实际意义有限——χ² 随样本量线性增长,300 人已足以把 p 压到 0.001 以下。另外强度阈值不是课本上固定的那套:模块先取自由度 min(行数,列数)−1,再把小/中/大对应的 0.1、0.3、0.5 各除以它的平方根,所以同一个 V 在 2×3 表和 4×5 表里会落进不同的档。
- Cramér's V 的置信区间是重抽样出来的,但它不会跨次抖动。 区间由 800 次非参数 Bootstrap 的偏倚校正 percentile 法给出,随机种子固定,同一份数据重跑结果完全一致——端点变了只可能是数据变了。要注意的是另一件事:样本 V 本身系统性偏高,这个区间估计的是总体 V,V 很小时区间会紧贴 0,下限接近 0 不能读成“没有关联”,关联的有无以检验的 p 为准。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:交叉列联表与独立性检验
- 输出结果三:交叉图与残差可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
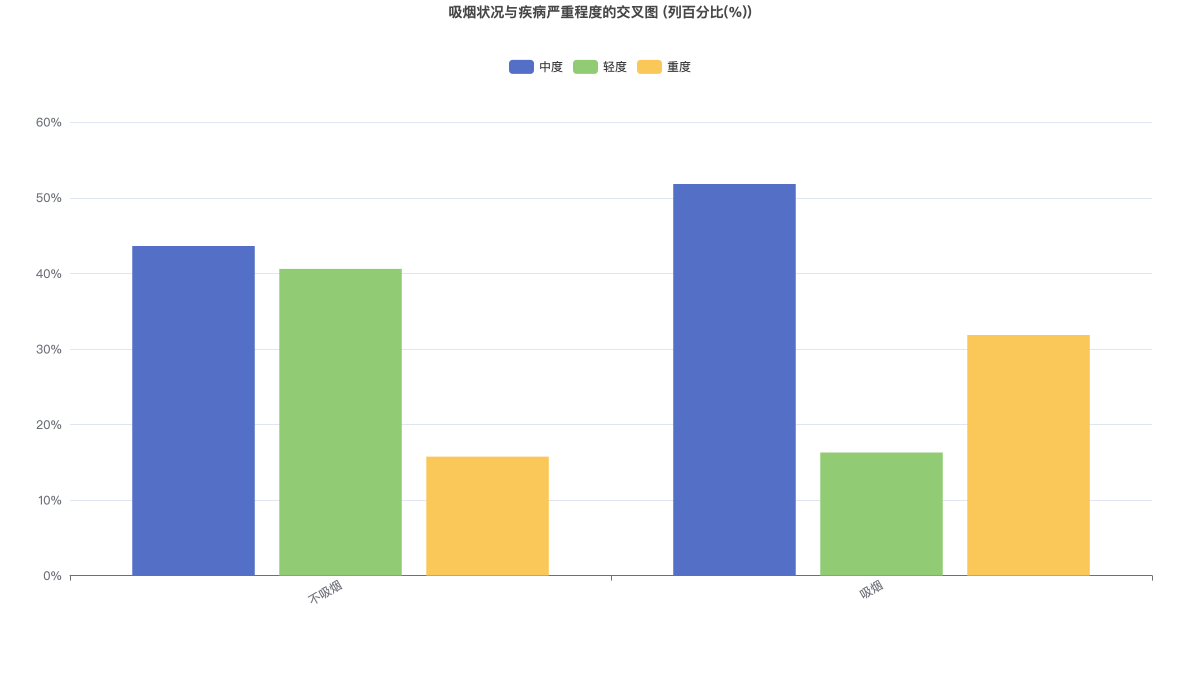
您可以通过图表上方的下拉框切换指标和图表类型,以从不同维度观察数据。
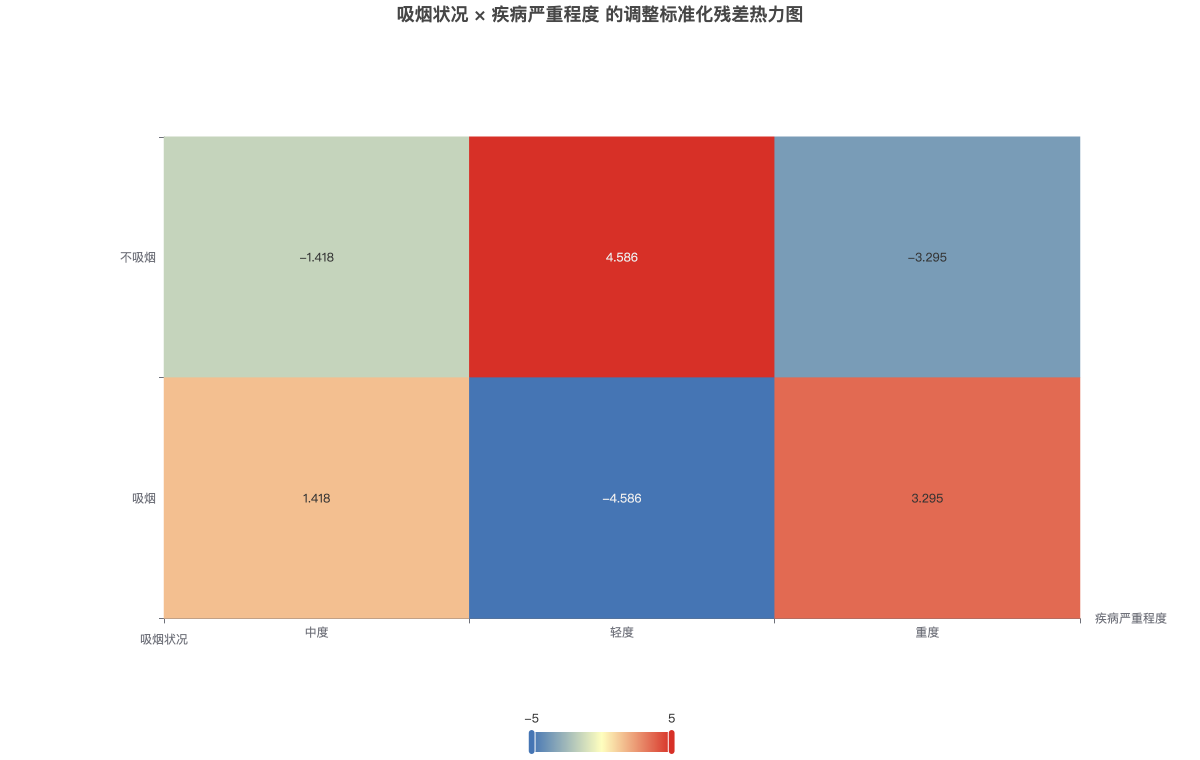
除交互式交叉图外,还给出「调整标准化残差」热力图:它直接指出是**哪些单元格**偏离了独立假设下的期望,是卡方显著之后必看的定位工具。