
系统GMM动态面板
这个方法是做什么的
面板数据里,被解释变量往往有惯性——今年的营业收入很大程度上由去年决定。把 y 的滞后项放进方程是合理的,但它天然与个体效应相关,普通最小二乘会高估这个系数、固定效应会低估它。本模块用 y 的更早期滞后项作工具变量做广义矩估计:差分 GMM(Arellano-Bond)只用差分方程,系统 GMM(Blundell-Bond)再加上水平方程的一组矩条件。滞后项系数 α 就是动态持续性,0 < α < 1 表示冲击会逐期衰减。
除了系数表,第一张卡交代面板结构与本次实际用了多少个工具变量,并逐条给出适用前提(T ≥ 4、N ≥ 30、工具数是否超过个体数、被解释变量的组内一阶自相关)。第四张卡把效应量分成三层:α 与它派生的冲击半衰期、长期乘数 1/(1−α);外生自变量的短期效应、标准化短期效应与长期效应 β/(1−α);以及 Hansen 过度识别检验与 Arellano-Bond AR(1)/AR(2) 检验。这一族里本模块特有的着眼点是:同一份数据能给出好几套差别很大的结果,所以“报告了哪一套设定”和“α 是多少”同样重要——第一张卡的“估计量 / 步数”“工具折叠 / 工具最大滞后阶”两行必须跟着结论一起抄走。
需要准备什么数据
- 放入 个体标识变量:1 个,定量或定类变量
- 放入 时间标识变量:1 个,定量或定类变量
- 放入[定量]被解释变量:1 个,定量变量(数值)
- 放入[定量]外生自变量(可选):定量变量(数值)
数据要求
- 数据表至少 40 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 个体多、期数少(大 N 小 T)的面板,被解释变量有明显惯性
- 解释变量存在内生性,又找不到合适的外部工具
- 要把“当期影响”与“累计到长期的影响”分开报告
- 需要一份带 Hansen 与 AR(2) 检验的完整动态面板结果
前提是长面板:一行一个“个体-时间”观测,两者组合不重复。期数 T 至少要 4,因为差分之后还得留下至少 2 期才构造得出滞后水平工具,AR(2) 检验本身也需要这么长。个体数 N 远小于 30 时 Hansen 检验与 Windmeijer 校正标准误都不可靠。被解释变量的滞后项由模型自动生成,不需要手工拖入。
什么时候不要用它
- 模型里根本没有滞后项、只要静态面板:用「面板模型」,它同时给 POOL / RE / FE 三套结果与选择检验。
- T 很大而 N 很小:大 N 小 T 的渐近前提不成立,改用「面板模型」的固定效应,或按多变量时间序列建模用「VAR向量自回归模型」。
- 内生性出在截面数据的某个解释变量上,且你有外部工具:用「GMM 估计」或「两阶段回归」。
- 有明确的政策时点与处理组 / 对照组:那是政策评估而非动态建模,用「双重差分(DID)」;需要先做匹配的用「PSM-DID」。
- 只有一条(或几条)时间序列,要的是长期均衡与短期修正:用「ECM模型」。
容易误读的地方
- 四个控件里动任何一个,α 和长期效应就是另一套数,同一份数据实测差出好几倍。 系统 GMM 两步(默认)α = 0.8575、半衰期 4.510 期、长期乘数 7.0191;改成差分 GMM 后 α = 0.4065、半衰期 0.770 期、长期乘数 1.6849;系统 GMM 改成一步 α = 0.8799;打开“折叠工具变量”α = 0.5855;工具最大滞后阶填 2 则 α = 0.7130。同一个外生自变量的长期效应随之从 0.1554 排到 0.7468。论文里只写“采用系统 GMM”是不够的,估计量、步数、是否折叠、工具滞后阶四项必须一起写。
- Hansen 检验的 p 值大不是好消息,太大反而是工具过多的信号。 判定列写的是“工具整体有效(0.05<p<0.99)”——连上限 0.99 都写进了判定条件;结论文案也点明“p 过于接近 1 提示工具过多”。工具个数会随期数增长而膨胀,第一张卡专门有“工具变量个数不超过个体数 N”一行盯着它。实测默认用了 30 个工具、Hansen χ²(26) = 26.759、p = 0.422;打开折叠后工具降到 10 个、Hansen χ²(6) = 3.834、p = 0.699。
- AR(1) 显著是正常的,AR(2) 显著才是问题。 一阶差分会让误差项天然含有 MA(1) 结构,所以 AR(1) 本来就该显著。实测 AR(1) z = −3.2711、p = 0.0011,判定列原文是“显著(符合预期:一阶差分误差本就含 MA(1))”;AR(2) z = −0.1694、p = 0.8655,判“不显著(识别假设得到支持)”。把 AR(1) 显著当成模型有问题,是这个报告最常见的误读。
- 半衰期和长期乘数是 α 的非线性变换,α 一贴近 1 就会失去区间估计。 实测默认设置下 α 的 95%CI 是 [0.7125, 1.0026],上端已越过 1,于是半衰期那一格的置信区间栏写成“不可估计(α 的 95%CI 端点越出 (0,1),半衰期在端点处无定义)”,而点估计 4.510 照常给出。长期乘数那一行的区间栏则是“未做”,表注说明引擎只输出各系数的标准误、没有完整协方差矩阵。所以长期效应只有点估计,不要给它配置信区间,显著性判断按表注的要求以短期效应的 p 值为准。
- Hansen 不显著证明不了工具外生。 第五张卡的解释边界写得很明确:GMM 的一致性依赖“工具变量外生”这一不可直接检验的假设,Hansen 检验只能证伪不能证实。所有工具若朝同一方向违反外生性,Hansen 同样不会拒绝。这一条和 α 接近 1 时长期效应对 α 极度敏感,是这份报告里两处最不该被点估计的漂亮数字盖过去的地方。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:GMM 系数估计
- 输出结果三:系数森林图
- 输出结果四:效应量与设定检验
- 输出结果五:结论与学术表述
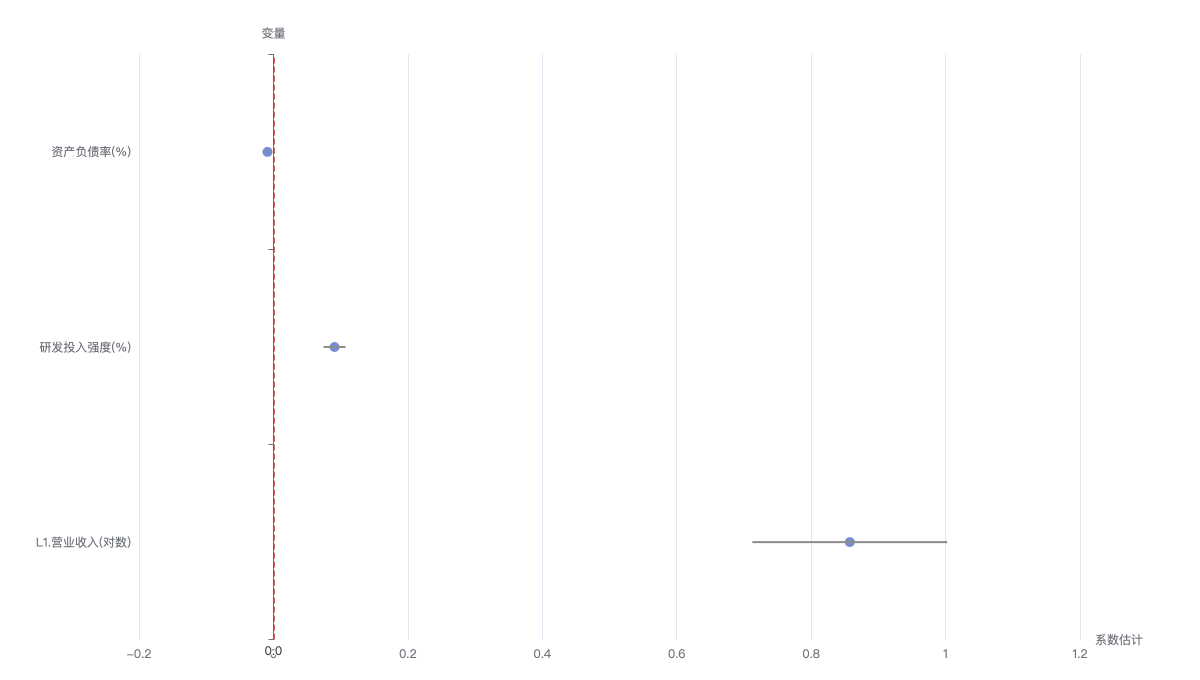
读图:每行一个变量,圆点为系数点估计,横向须为 95% 置信区间(由系数 ± 1.96×Windmeijer 校正标准误得到);须跨越红色零参考线表示该系数与 0 无显著差异(灰点),整条须落在零线一侧表示在 5% 水平上显著(蓝点)。本模型中变量 L1.营业收入(对数) 为被解释变量滞后项,其系数 α 度量动态持续性(0~1 为平稳收敛),其余系数为外生自变量的短期边际效应。可用右上角切换器切到「表格」视图逐个读取精确数值。为避免常数项 _cons 量级过大压扁其余系数,本图已略去截距,仅展示结构系数。