
Heckman两步法
这个方法是做什么的
有些结果变量在设计上就只对一部分人存在:只有参加工作的人才有工资,只有成交的房子才有成交价,只有理赔的保单才有赔付额。如果“谁被观测到”和“结果有多高”受同一批因素影响,直接拿看得见的那部分样本做回归就会有偏。Heckman 两步法先用 Probit 估计每个个体被观测到的概率,据此算出逆米尔斯比率 IMR,再把 IMR 当作一个额外的自变量放进第二阶段的 OLS 结果方程——IMR 吸收掉的正是选择过程带来的那部分系统性偏差。
IMR 的系数是否显著,就是“到底存不存在选择偏误”的正式检验。除此之外,卡① 逐条登记识别前提:第一阶段是否含有不进入第二阶段的排除性变量、IMR 与其余自变量的 VIF、Probit 的拟合与选择率,以及联合正态性假设(判定栏写的是“不可检验”);卡④ 给出结构参数 ρ 与 σ,并把朴素 OLS 与修正后的系数并排对比;卡③ 是系数森林图与两组选择概率的分布图。第二阶段标准误用 Greene(1981) 生成回归元校正,表注写明它纳入了“IMR 本身是第一阶段估计出来的”这部分不确定性,只用 HC1 会系统性低估标准误、高估显著性。
需要准备什么数据
- Y1(第一阶段,01变量):定类变量(分组/标签)
- X(第一阶段):定量或定类变量
- Y2(第二阶段,定量):定量变量(数值)
- X(第二阶段):定量或定类变量
数据要求
- 数据表至少 50 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「Y1(第一阶段,01变量)」必须正好是 2 个类别。
- 「Y1(第一阶段,01变量)」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 结果变量只在满足某个条件的子样本上存在,而这个条件不是随机的
- 你能说出至少一个只影响“是否被观测”、不直接影响结果水平的变量
- 想量化忽略选择偏误会让系数偏多少——卡④ 的对比表直接给出差值与相对偏离
- 需要在论文里正式回应“你的样本是不是被挑过”的质疑
第一阶段因变量必须是 0/1,1 表示被观测;第二阶段因变量为定量,且只在选中样本上有值。选择率太高(接近全选)说明几乎不存在选择问题,太低则第二阶段样本过少、IMR 的方差极大。
什么时候不要用它
- 第一阶段和第二阶段的自变量完全相同:见下方第一条实测,此时结论会翻。先补一个排除性变量再跑;确实找不到的话,就直接报告「线性回归 (最小二乘法)」的结果并写明选择问题未被处理,比端出一份靠函数形式硬撑的 Heckman 更诚实。
- 因变量不是“看不见”,而是堆在某个值上(消费额一堆 0、量表触顶):那是受限因变量不是样本选择,用「Tobit回归」,并在控件里填好左侧或右侧受限值。
- 数据本该有、只是随机丢了:那是缺失值问题。先用「缺失模式分析表」判断缺失机制,再用「多重插补」补齐,Heckman 处理的是结构性的不可观测。
- 偏误来自自变量自身内生(遗漏变量、双向因果),而不是“谁被观测到”:卡⑤ 已明说本方法不解决这个,用「两阶段回归」。
- 有政策时点与对照组:识别可以来自设计,用「双重差分(DID)」比依赖联合正态假设稳妥得多。
- 想比较处理组与对照组、而分配是个体自选的:那是处理效应问题不是选择问题,用「倾向得分匹配 (PSM)」。
容易误读的地方
- 排除性约束不满足时,模块照样出一份完整报告,而结论是反的。 实测把第一阶段独有的那个变量拿掉、让两阶段用同一个自变量:卡① 的排除性约束判定由“满足”变成“不满足”,IMR 的 VIF 由 1.02 飙到 26.27;受教育年限的系数由 0.693(p<0.001,95%CI[0.472, 0.913])变成 0.288(p=0.632,95%CI[−0.894, 1.469]),IMR 系数由 4.436(p<0.001)变成 −4.128(p=0.419),ρ 由 0.758 变成 −0.710。整篇报告里提示你出了问题的,只有卡① 那一行判定。这一条必须动笔前就想清楚:哪个变量只影响“要不要工作”、不影响“工资多少”。
- IMR 显著只有在联合正态假设成立时才能读成“存在选择偏误”。 卡① 把这条假设登记为不可检验,并说明若严重违背,IMR 的函数形式就设定错了,修正反而引入偏误。反过来 IMR 不显著时,卡⑤ 的方法边界给了明确出路:多数文献建议直接报告 OLS 结果,并说明已做过选择性检验——不必硬留着一个不显著的 IMR 在方程里。
- ρ 和 IMR 的系数不是两条独立证据。 卡④ 的结论文案专门写了这一句:ρ 的显著性检验与 IMR 系数的检验完全等价,报告时给出其一即可,不应当作互相印证。演示数据里 IMR 系数 4.436、σ=5.855、ρ=0.758,三个数是同一件事的三种写法,把它们并列成“多重证据”是重复计数。
- 第一阶段的系数不是研究结论。 表注写明该阶段只用于估计被观测的概率并生成 IMR,其系数不是研究的最终结论。演示数据里家庭其他收入的 Probit 系数是 −0.181,它说的是“家里其他收入越高越不容易去工作”,绝不能读成“家庭其他收入压低了工资”——工资方程里根本没有这个变量。
- 两个 R² 不可比,修正幅度也不是越大越好。 卡④ 写明含 IMR 的模型 R² 不能与朴素 OLS 直接比较。而“修正幅度大”本身是中性的:演示数据在排除性约束满足时最大相对偏离只有 8.6%,抽掉排除性变量后反而涨到 62.0%——后者的大幅偏离恰恰来自识别失效,不是修正做得更彻底。判断该不该信,看的是卡① 的前提是否满足,不是看系数动了多少。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(两阶段回归系数)
- 输出结果三:可视化(系数森林图与选择概率分布)
- 输出结果四:效应量与事后分析(选择偏误强度与修正幅度)
- 输出结果五:结论与学术表述
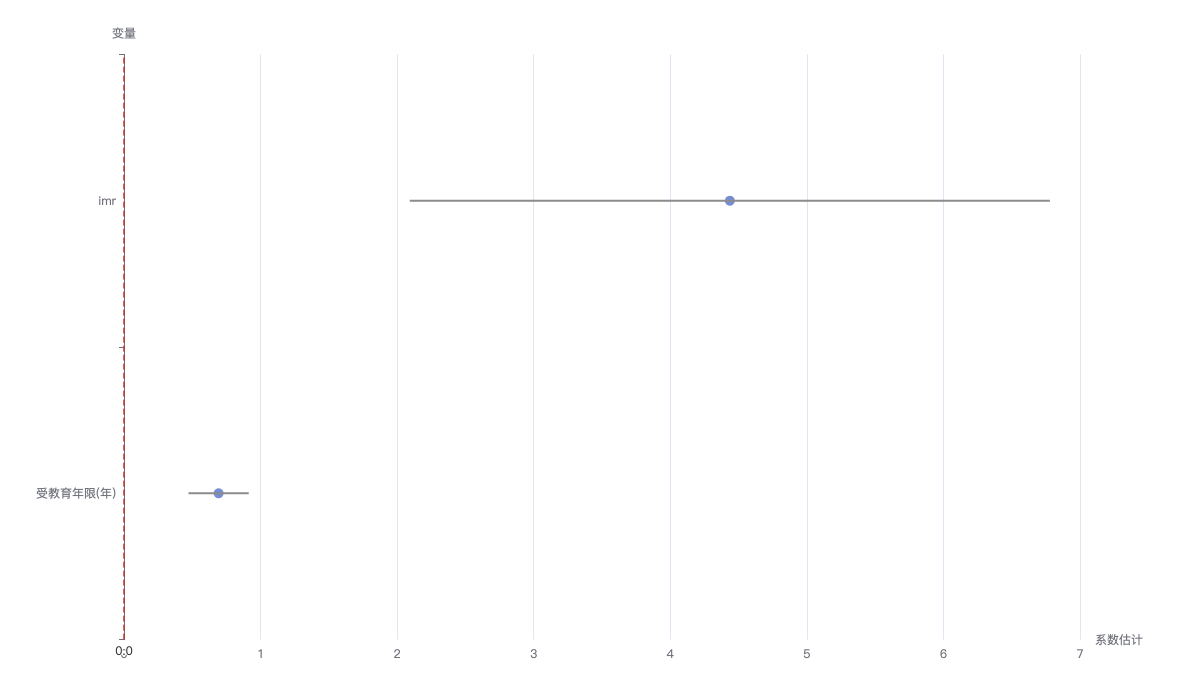
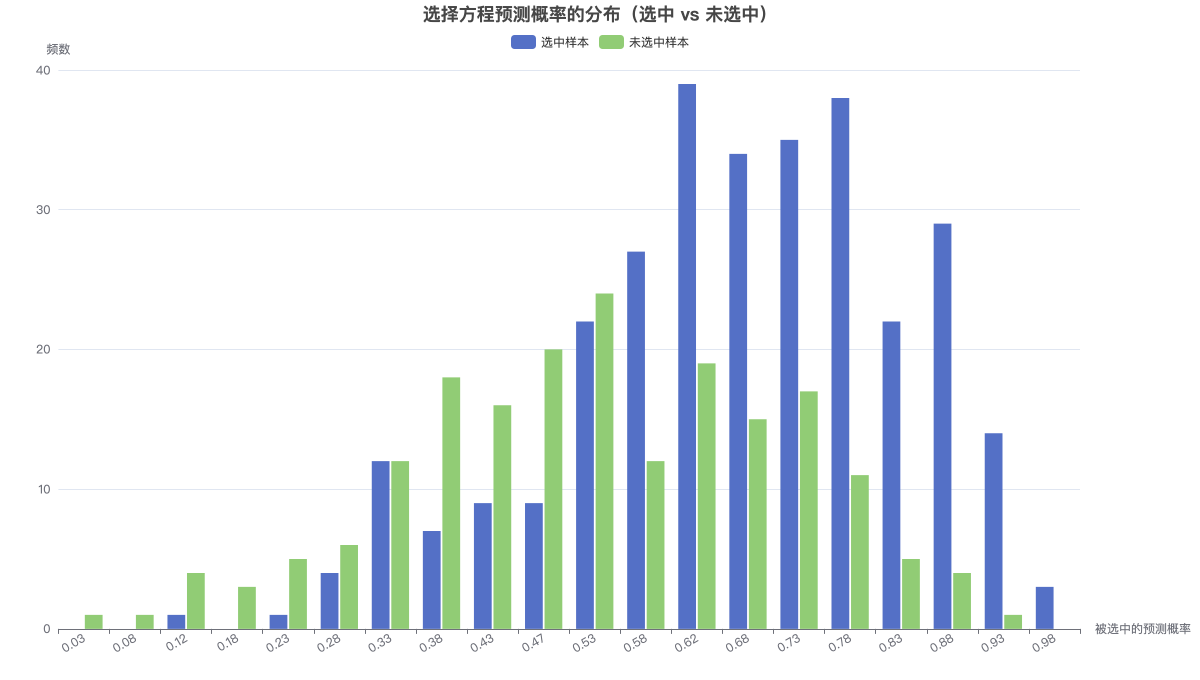
上图为第二阶段各系数的点估计与 95% 置信区间(与表5 同源,均用 Greene 校正后的标准误,已略去截距以免压扁图形);下图为选择方程预测概率在选中/未选中样本中的分布。