
广义线性混合模型(GLMM)
这个方法是做什么的
因变量是计数或二分类,观测又按组嵌套(同一家医院的病人、同一个被试的多次记录、同一个班的学生),而且组间差异本身就是你要说清楚的东西——这时用 GLMM。它在固定效应之外给每个组一个随机截距:固定效应回答“在同一个组内部,X 每变一个单位结局变多少”,也就是个体特异(条件)效应;随机截距的方差回答“不同组之间的基线差多少”。分布族只有泊松与二项两种,随机结构只有随机截距,各组的斜率被假定相同。
卡④ 是它相对普通广义线性模型的核心增量:随机截距方差与标准差 σ_u、潜尺度 ICC(Logit 链接取分布层方差 π²/3,对数链接取 ln(1+1/λ̄) 并把 λ̄ 一并印出)、组间中位数比 MOR(与 OR/RR 同量纲,可直接和固定效应比大小),以及逐组随机截距的后验均值与后验标准差。估计用变分贝叶斯近似,快,代价是系统性低估后验方差——因此它不产出对数似然,AIC/BIC 与似然比检验三项在报告里如实印成“未做”,卡① 也会专门说明这一点。
需要准备什么数据
- 放入因变量 (Y):不限
- 放入自变量 (X):至少 1 个
- 放入分组变量:定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入分组变量」的类别数需在 2~200 之间。
- 「放入分组变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 多中心研究里,“各中心基线发生率差多少”本身就是结论的一部分
- 同一批被试的重复测量,因变量是次数或“是/否”,要说的是“这个人自己前后变了多少”
- 学生嵌在班级里、患者嵌在医院里,既要固定效应也要量化组间异质性
- 组数较多、各组样本量不一致,不愿把每个组都做成哑变量塞进模型
分组变量必填、必须是定类,至少 2 个水平、每组至少 2 个观测——只含 1 个观测的组无法把组内变异与随机截距分开;组数上限 200。组数少于 5 时随机效应标准差的估计极不可信。因变量必须与分布族对得上:泊松族要非负整数、二项族要恰好两个取值,对不上在入口直接报错。卡① 还会给出因变量的均值与方差、数值自变量的 VIF,以及被自动剔除的常量变量。
什么时候不要用它
- 因变量是正态连续(评分、金额、浓度):本模块只有泊松与二项两族,用「混合模型」,它给 ICC 与 Nakagawa 边际/条件 R²。
- 只关心总体平均效应(政策口径的“人群平均下降多少”),组间差异只是要校正的干扰:用「广义估计方程(GEE)」,它另给稳健标准误与相关结构的稳健性对照。
- 需要严格的模型比较(嵌套模型的似然比检验、AIC/BIC):变分贝叶斯不产出对数似然,本模块给不了。产品内可行的路径是用「广义估计方程(GEE)」的 QICu 比较自变量集合,或放弃随机效应、把组当作固定因子放进有完整似然的「逻辑回归」「计数数据回归」。
- 组数太少(只有两三个组):方差分量估计不可信。把组当成普通定类自变量放进「逻辑回归」或「计数数据回归」。
- 有两层嵌套结构(学生在班级里、班级在学校里):分组区只收 1 个变量。因变量是正态连续时用「混合模型」,它的随机效应区可以放多个变量;因变量是计数或二分类时只能先把外层与内层拼成一个全局唯一的标识列、选定其中一层做随机截距,并在文中说明另一层未建模。
- 想知道各组的斜率是不是也不同:本模块只有随机截距。把分组变量与自变量的交互项当固定效应放进「逻辑回归」或「计数数据回归」,或分组别各跑一次再比较系数。
容易误读的地方
- 这里的系数是条件(组内)效应,与 GEE 的总体平均效应不相等,不可互换引用。 实测同一份二分类数据:GLMM 给 OR = 2.59(σ_u = 1.5388、潜尺度 ICC = 0.4185),GEE 在同一份数据上给 OR = 1.98。非线性链接下组间异质性越大,两者差得越远。把 GLMM 的 OR 写成“人群中 X 高一档的人风险高约 1.6 倍”是错的,那是 GEE 的口径;GLMM 说的是“在同一家医院内部”。卡① 的表注与卡⑤ 的解释边界都把这条写死了。
- 变分贝叶斯把不确定性低估了,这里的 p 值只能当筛选证据。 表注写明 95% 区间由“后验均值 ± 1.96×后验标准差”构造,而变分贝叶斯会系统性低估后验方差,于是区间偏窄、p 偏小、显著性偏于激进。这个偏是有方向的、不是随机噪声:结论若卡在 p 略小于 0.05 那一带,等于没有结论。卡④ 里“log(SD) 的后验标准差”那一列同样被低估,表注明说不宜据此构造置信区间——所以不要给 σ_u 配一个 95% 区间写进论文。
- 潜尺度 ICC 不是“组间方差占实测方差的比例”,它算在潜变量尺度上,换个分布族数字就变。 表里“ICC 的计算依据”那一行把口径写死了:Logit 链接下分布层方差取 π²/3 ≈ 3.290,对数链接下取 ln(1+1/λ̄)(示例数据里 λ̄ = 1.5456,得 0.4990)。同一份数据换族重跑,ICC 会变;它也不能和「混合模型」里那个基于实测方差的 ICC 直接比大小。跨研究引用 ICC 时必须连口径一起写出来。
- σ_u 单独看没有参照系,MOR 才是能和固定效应直接比的那个量。 MOR 的量纲与 OR/RR 一致(表注给了公式),读作“随机抽两个组,基线高的那组相对基线低的那组的中位数倍数”。示例数据 MOR = 1.2256,比两个自变量的发生率比(1.3011、1.2168)还小,说明“你在哪个中心”对结局的影响并不比自变量更大;而另一份实测数据里 MOR = 4.3397、自变量 OR 只有 2.59,那就是“在哪一组”比自变量取值更能决定结局。这条对比是卡④ 表注明确支持的读法。
- 随机截距的后验均值不能拿来给组排名。 卡④ 逐组列出后验均值与后验标准差,示例数据里 16 个中心的后验均值落在 -0.269 到 0.252 之间,而后验标准差普遍是 0.12~0.14——多数组离 0 还不到两个后验标准差。随机效应是被向总体均值收缩过的(这正是它相对哑变量的优势),组内观测越少收缩越狠,所以“最高”和“最低”那两个组的差距本身就被压扁了;何况这里的后验标准差还被变分贝叶斯低估。用它挑“最差的中心”是过度解读。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:固定效应系数表
- 输出结果三:固定效应森林图与随机效应分布
- 输出结果四:方差分量、ICC 与随机效应
- 输出结果五:结论与学术表述
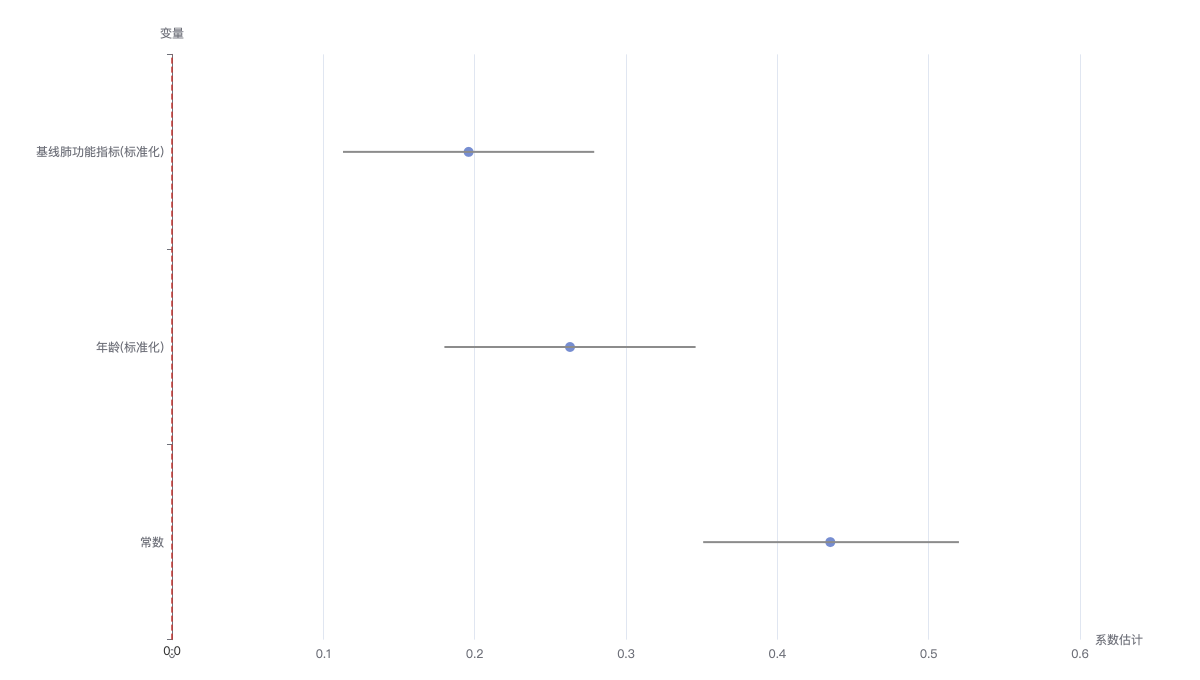
图形读法:圆点为各系数的点估计,横向须线为其 95% 置信区间;红色虚线为零参考线。置信区间跨越零线(含 0)表示该系数不显著(灰点),不跨越则显著(蓝点),须线越窄表示估计越精确。本图为表4的可视化,未改变任何数值;可用右上角切换器切到「表格」视图逐条读数。
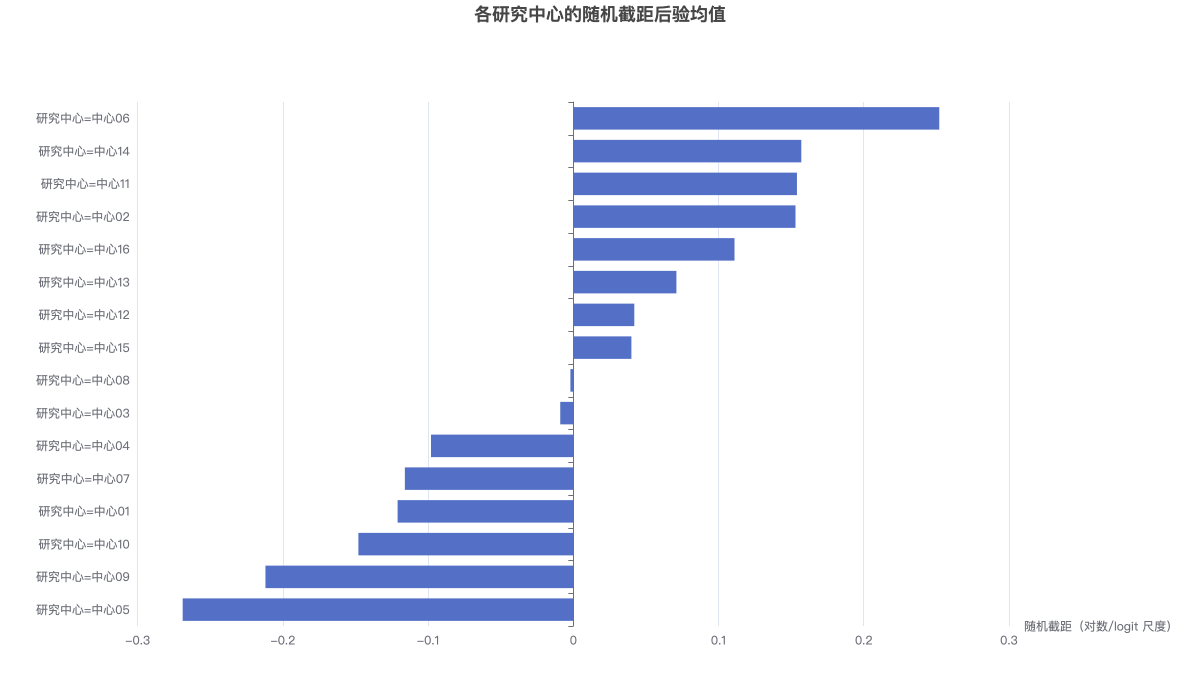
上图为固定效应森林图,下图为各组随机截距的后验均值(正值表示该组基线水平高于总体)。