
格兰杰因果检验
这个方法是做什么的
回答一个纯预测性的问题:把 X 的历史值加进 Y 的自回归方程,预测误差有没有显著下降。原假设是“X 的全部滞后项系数同时为 0”,也就是 X 对 Y 没有增量预测力;拒绝它才说存在格兰杰因果。方向是不对称的,K 个变量会产生 K×(K−1) 个有向检验,每一对都单独跑。
报告的重心在两头。卡① 是前提:逐序列 ADF(非平稳会直接产生伪因果)、VAR 信息准则的定阶依据(AIC/BIC/HQIC/FPE 各推荐几阶)、以及每个待估参数摊到多少观测。卡④ 是稳健性:Cohen's f²=(SSR_受限−SSR_非受限)/SSR_非受限,即加入原因变量滞后项后残差被削减的相对比例,它与 F 同源但不随样本量放大;同时给 Bonferroni 与 BH-FDR 两套校正后的 p 值。读这份报告的着眼点是:主结果表印的是未校正 p,判断稳健性必须翻到卡④ 看校正列,方向越多这两列差得越远。
需要准备什么数据
- 放入[定量]时间序列变量:2~20 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 判断某个先行指标是不是真的“领先”,能不能进入预测模型
- 多条宏观或业务序列之间做方向性筛查,看谁能预测谁
- 为 VAR 建模挑选值得纳入的变量
- 已知两条序列相关,想区分是同步共变还是有时间先后
前提是各序列平稳、共享同一条时间轴、等间隔。这个模块没有时间列拖拽区,同一行必须是同一时点的观测,行的先后就是唯一的时间信息。至少 30 行——29 行会被直接拦下;但 30 行只是技术下限,样本量应当明显大于待估参数个数(每对检验要估 2×滞后阶+1 个参数),卡① 会直接给出实测的“每参数可用观测数”。滞后阶数由控件指定,默认 1 阶。
什么时候不要用它
- 序列非平稳且同阶单整:直接做格兰杰检验会得到伪因果。分两种问题走:长期均衡是你要的,先用「协整检验」确认,再用「ECM模型」在误差修正框架下讨论方向;只要短期领先关系,改用「时间因果模型」——它的“非平稳时自动一阶差分”开关默认打开,这类数据直接就能跑,代价是结论说的是变化量之间的领先关系,长期均衡信息被差掉了。
- 想要的是冲击的传导路径与各变量的贡献占比:用「VAR向量自回归模型」,它给脉冲响应与方差分解。
- 变量较多、希望自动定阶并同时拿到效应量:用「时间因果模型」,它按信息准则选阶并给 Geweke 度量与部分 R²。
- 你只想知道两条序列错开几期对得最齐:用「互相关分析」,它直接给出峰值滞后。
- 你要的是真正的因果效应而不是预测增量:靠研究设计而不是时序检验,用「双重差分(DID)」「断点回归(RD)」或「倾向得分匹配 (PSM)」。
容易误读的地方
- “格兰杰因果”不是因果,这是它名字带来的最大误导。 它只说明加入 X 的历史值能显著改善对 Y 的预测。存在共同驱动的第三变量时,两个都被第三方带动的序列会互为格兰杰原因;真实因果的时滞若小于采样间隔(比如日内传导用月度数据去测),也会完全测不到。演示里的显著方向是“先行指标 → 工业增加值增速”,这句话的正确读法是“先行指标的历史有预测价值”,不是“先行指标推动了工业增加值”。
- 结论对滞后阶高度敏感,而默认值只有 1 阶。 演示数据在 1 阶下 F(1,136)=47.492,改成 6 阶后变成 F(6,121)=7.035——方向结论没变,但统计量差了近七倍。卡① 的信息准则表就是给这件事用的:AIC/BIC/HQIC/FPE 在演示数据上一致指向 1 阶,与设定相符才算有依据。规范做法是至少在建议阶与相邻阶各跑一遍,报告结论是否一致。
- 主结果表是未校正的,方向一多就必须看校正列。 3 个变量就有 6 个方向,5 个变量有 20 个。卡④ 同时给 Bonferroni(控 FWER,最保守)与 BH-FDR(控错误发现率,检出力更高),两者的适用场景不同:确证性研究用前者,探索性筛查用后者。只引用卡② 的星号而不说明校正方式,是这个模块最常见的报告缺陷。
- 两个方向都不显著,不等于两条序列无关。 格兰杰检验只看“历史能不能预测未来”,完全看不到同期(瞬时)相关。两条序列可能在同一期紧密同步却互不领先,此时该看的是同期相关系数或 VAR 的残差协方差,而不是宣布它们无关。
- f² 和 p 回答的是两个问题,不要用 p 的星号去说效应大小。 演示里显著方向的 f²=0.3492(按 Cohen 基准介于中等与大之间),不显著方向的 f²=0.0024(极小)。样本一大,很小的 f² 也能显著;样本一小,中等的 f² 也可能不显著。论文里两个都要报。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:格兰杰因果检验主结果
- 输出结果三:格兰杰因果关系可视化
- 输出结果四:效应量与多重比较校正
- 输出结果五:结论与学术表述
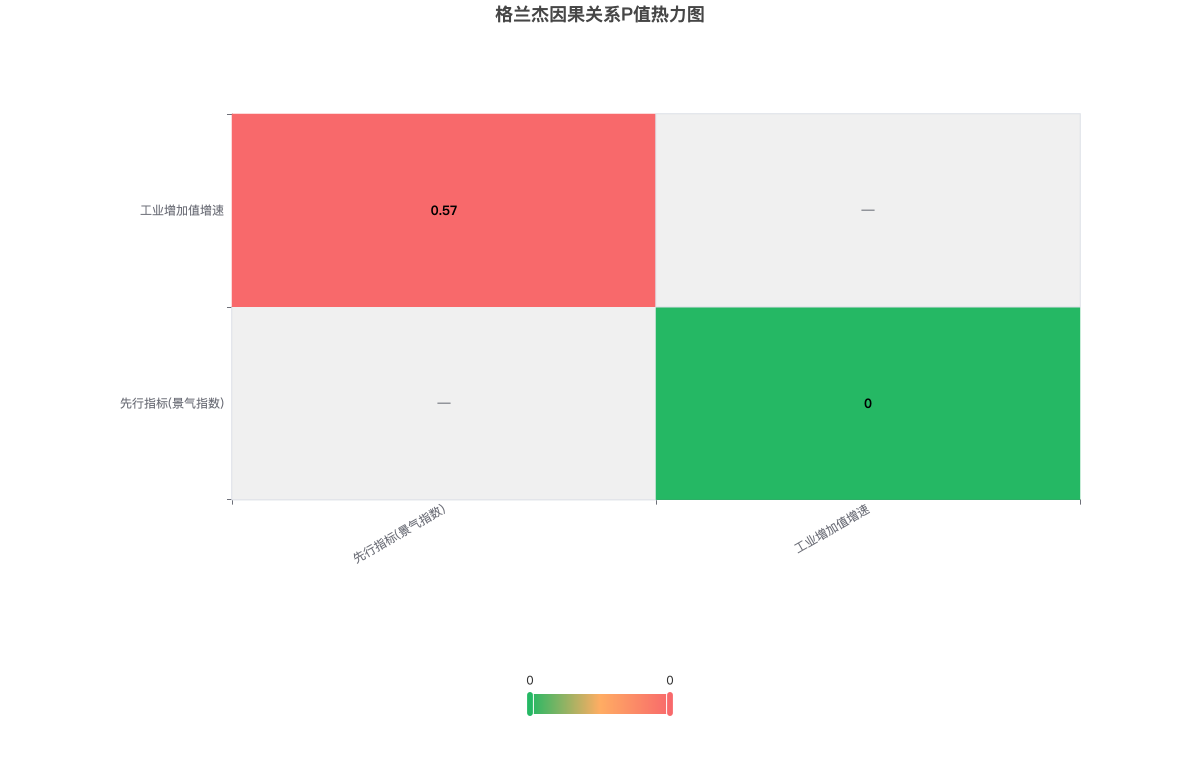
热力图的 Y 轴为「原因」变量、X 轴为「结果」变量,格内数值为该方向的未校正 p 值;颜色越绿 p 越小(越显著),对角线为自身对自身,不参与检验。
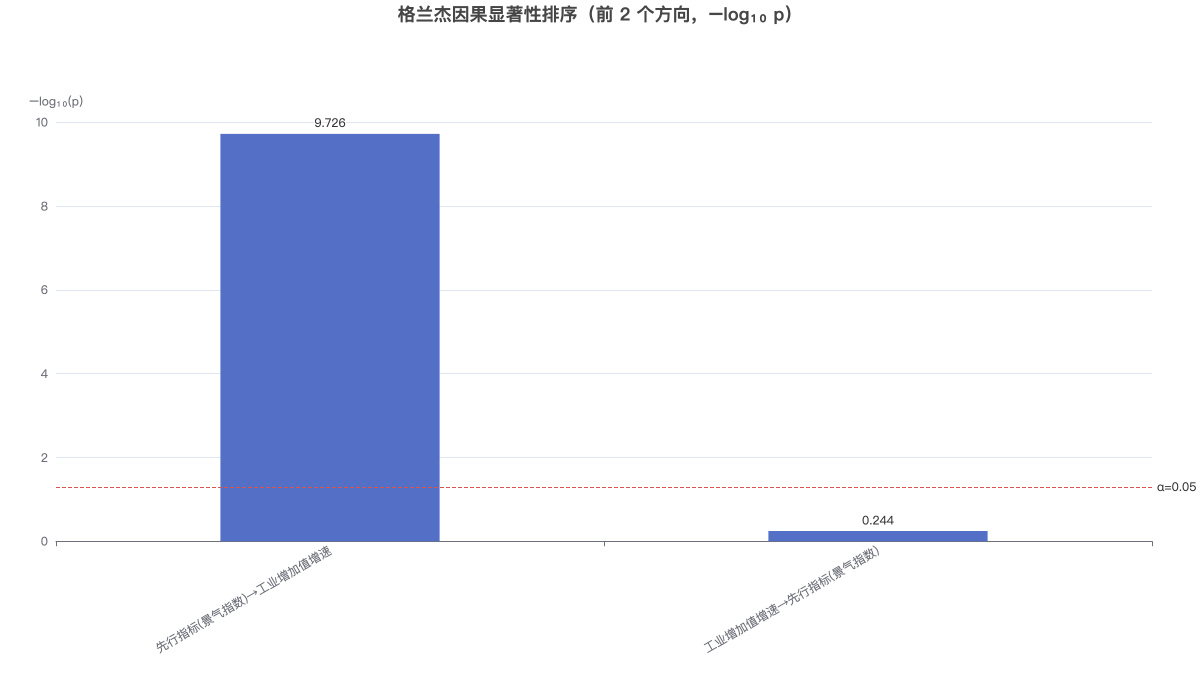
条形图按 −log₁₀(p) 从大到小排列各有向关系,红色虚线为 α=0.05 对应的阈值线;柱子越高,该方向的格兰杰因果证据越强。