
平行中介效应
这个方法是做什么的
中介问的是机制:X 对 Y 的影响,有多少是“经由”M 传导过去的。平行中介一次放入多个中介变量,它们彼此之间没有先后顺序,都并列地接在 X 与 Y 之间。模块估计三组方程:各中介对 X 的回归给出 a 路径,Y 对 X 的回归给出总效应 c,Y 对 X 与全部中介的回归给出各条 b 路径与直接效应 c′;每条 b 都是在控制了其余中介之后的偏效应。
判定中介是否成立,靠的不是“c 显著、c′ 变小”,而是间接效应 a×b 的置信区间是否含 0。默认做 2000 次非参数 Bootstrap(次数可改),第四张卡对每条路径给出 ab 的点估计、完全标准化间接效应 abcs、百分位与偏差校正两套 95% 区间、Sobel 检验与占总效应比 P_M,并给出总间接效应,以及“哪条中介更强”的两两对比检验。第一张卡另给四个方程各自的残差正态性、Breusch-Pagan 异方差、Durbin-Watson 检验与最终方程的 VIF。
需要准备什么数据
- 因变量 (Y):定量变量(数值)
- 自变量 (X):至少 1 个,定量变量(数值)
- 并行中介 (M):至少 1 个,定量变量(数值)
- 控制变量 (可选)(可选):定量变量(数值)
数据要求
- 数据表至少 50 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 理论上 X 通过几条并列的机制影响 Y(如领导风格分别经由满意度和信任影响组织承诺)
- 想知道多条机制之间哪一条更强、强多少
- 需要报告“总效应中有多大比例由中介传导”
- X、M、Y 的先后顺序已由实验设计或纵向测量确定,不是事后拍脑袋排的
四个拖拽区都只收定量变量,同一个变量不能出现在两个区里(X 与 M 相同会得到 a = 1 的恒等式而不是中介)。有效行数不少于 50、缺失比例不超过 20%、不得含常数列。自变量区可以放多个变量,但只有第一个是焦点自变量,其余当作同时进入方程的协变量处理,全部间接效应只针对焦点变量计算——第一张卡“焦点自变量”那一行会把这件事写出来。
什么时候不要用它
- 中介变量之间有先后顺序(X 先影响 M₁、M₁ 再影响 M₂、M₂ 才影响 Y):平行中介不估计中介之间的传导路径,会把这条链拆成两条互不相干的并列路径。改用「链式中介效应」。
- 你要问的是“效应在什么条件下更强”,而不是“经由什么传导”:那是边界条件问题,不是机制问题,两者名字像但问的不是一回事。用「调节作用分析」。
- 因变量不是定量的:Y 区只收定量变量。二分类结局用「逻辑回归」,等级结局用「有序逻辑回归」,计数结局用「计数数据回归」——不要把这类结局硬当成连续变量塞进来跑中介。
- 自变量或中介变量是定类的:定类列在数值化时会整列变成缺失。先在数据处理里做哑变量编码再拖进来;如果这个定类变量的角色其实是“分组”、你想看的是它会不会改变 X 与 Y 的关系,用「协方差分析」并打开“是否分析交互效应”,它检验的正是分组与协变量的交互。
- 观测之间不独立(同一批人多期测量、学生嵌套在班级里):各条路径都由普通最小二乘估计,标准误会被低估,Bootstrap 也救不了这一条。有个体与时间两维结构的用「面板模型」,重复测量或分层嵌套的用「混合模型」。
- 有效样本不到 50:50 不是“建议值”而是入口硬门槛,不够根本跑不出报告——40 行的表会被直接拒绝,提示“当前数据表共 40 行,少于平行中介效应所需的至少 50 行”;总行数够、但参与分析的变量按行对齐后完整记录不足 50 条(如 60 行里只剩 35 条),同样在入口被拒。这种数据下先用「线性回归 (最小二乘法)」把 X 与 Y 的总关联说清楚,同时用「线性回归功效」反推需要补多少样本。
容易误读的地方
- 中介的因果解读来自研究设计,不来自这份报告。 第一张卡“时序与无混淆假设”那一行的实测值就是“—(不可由数据检验)”,判定栏写明:中介的因果解释依赖“X 先于 M、M 先于 Y”与“无未测混淆”两条识别假设,任何统计检验都无法证实。横截面数据里 X、M、Y 同时测量,M 与 Y 的关系同样可能是反向的、或由第三变量驱动,而报告里看不出来。这种数据下结论必须写成“数据与该中介模型相容”,不能写成“X 通过 M 影响 Y”——模块的论文表述段已经按这个口径替你写好了。
- 恒等式 c = c′ + Σaᵢbᵢ 必然成立,不是模型拟合得好的证据。 表注逐字写着:“恒等式 c = c′ + Σaᵢbᵢ 在同一份数据、同一组控制变量下严格成立(最小二乘的代数性质),不是模型拟合优度的证据。”看到“总效应刚好等于直接效应加各条间接效应之和”,不要当成模型被数据验证了。
- a 显著且 b 显著,不等于 ab 显著;反过来也一样。 判定只能看 Bootstrap 区间是否含 0,不能逐段看 p 值凑结论。同一张表里的 Sobel 检验假定 ab 服从正态,而 ab 的抽样分布通常偏态、功效更低,模块明确标注它仅作参考。另一半同样重要:c 不显著也可能存在显著的间接效应——几条路径符号相反相互抵消就是遮掩效应,所以模块不把“c 显著”当作做中介检验的前置条件。
- “这条中介比那条强”必须用对比检验,不能靠比较两条区间显不显著。 第四张卡最后那张对比表算的是两条 ab 之差在同一批重抽样内的分布,已经自动考虑了两条路径的相关性。示例里两条间接效应分别是 0.1193 与 0.1371、都显著,但差值的 95% 区间是 [−0.1068, 0.0797],含 0,结论是强度无显著差异。用“一条显著、另一条不显著”推断两者有差异是显著性比较的经典谬误,表注专门点了这一条。还要留意:各条 b 是相互控制后的偏效应,中介之间高度相关时它们会互相抢解释力,单条 ab 不稳但总间接效应仍稳健,第一张卡的 VIF 表就是查这个的。
- 占总效应比 P_M 在总效应小的时候极不稳定。 它等于 ab/c,只有间接效应与总效应同号时才能读成“中介了百分之多少”;符号相反属于遮掩效应,比值可能超过 100% 甚至为负,c 接近 0 时更会直接爆掉。报告时必须同时给出 ab 的绝对值与它的 Bootstrap 区间,只报一个百分比是不够的。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与回归前提检验
- 输出结果二:中介路径系数主结果表
- 输出结果三:中介路径图与间接效应可视化
- 输出结果四:效应量分解与中介效应检验
- 输出结果五:结论与学术表述
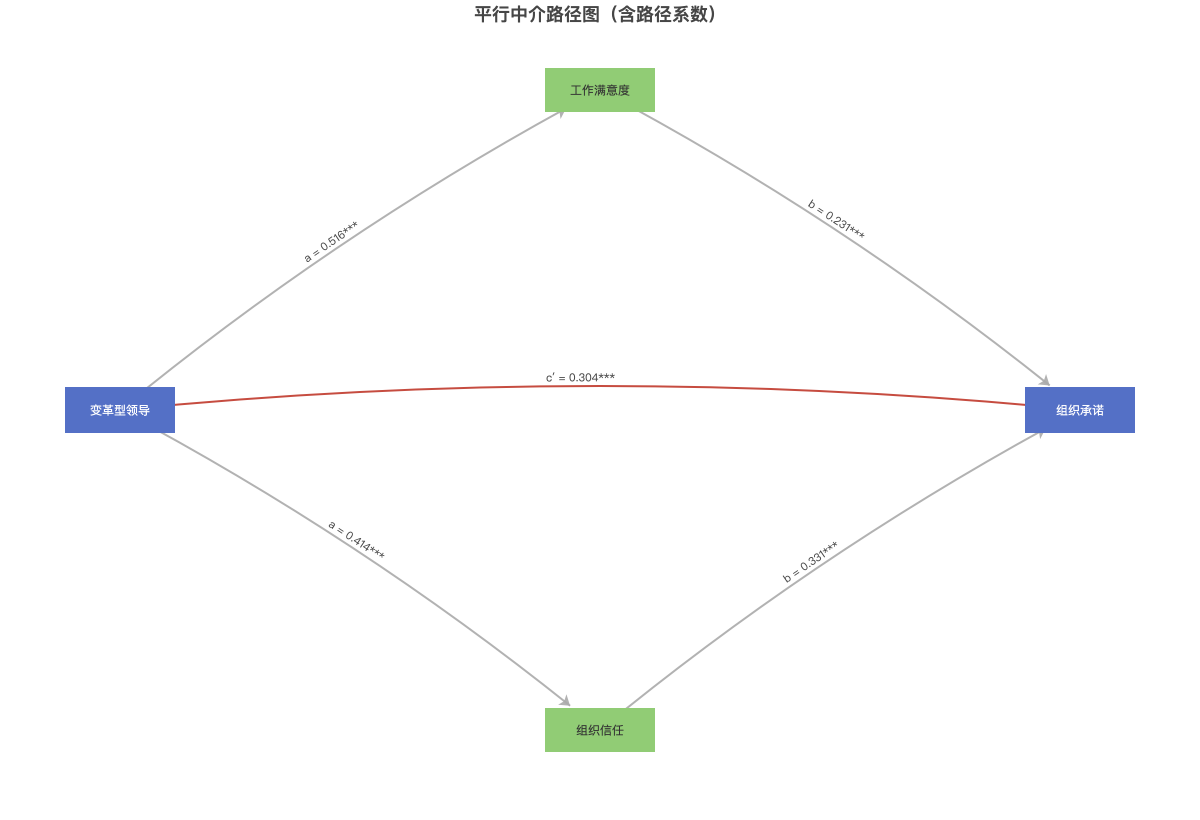
路径图上的箭头已标注实测系数:X→M 为 a 路径,M→Y 为 b 路径,X→Y 的红色箭头为控制全部中介后的直接效应 c′;星号为显著性(* p<0.05, ** p<0.01, *** p<0.001)。
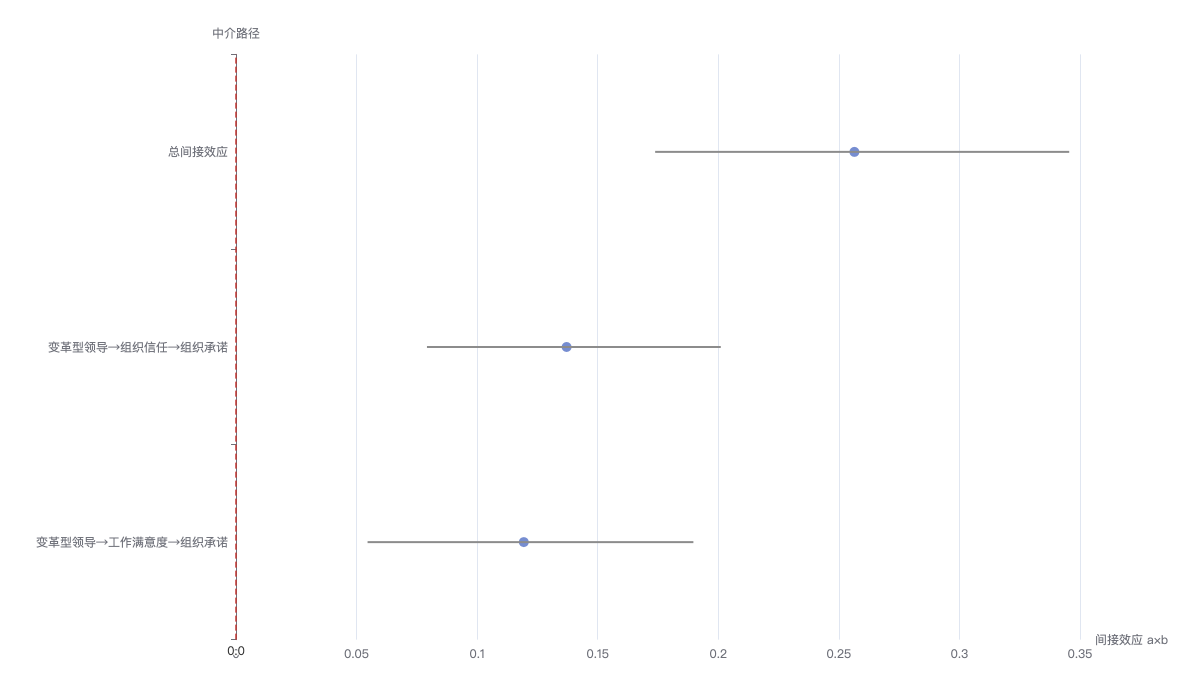
森林图给出每条中介路径的间接效应 a×b 及其 2000 次非参数 Bootstrap 的95% 百分位置信区间;须跨过 0 参考线(灰点)表示该间接效应不显著,完全落在一侧(蓝点)表示显著。