
校准曲线
这个方法是做什么的
预测模型给出的概率准不准。做法是把预测概率按分位数切成若干箱,逐箱比较“平均预测概率”与“实测事件率”,画出来就是校准曲线:点落在对角线下方表示高估风险,上方表示低估。校准与判别是模型性能两个正交的维度——一个 AUC 很高的模型完全可能把所有人的风险整体高估一倍,排序全对而概率全错,所以两者必须分开报告。
除了 Hosmer-Lemeshow 拟合优度检验,报告给 Brier 分数及其 Murphy(1973) 三分解(Reliability 失准分量 / Resolution 分辨分量 / Uncertainty 固有不确定性,外加一项如实单列的分箱分解残差)、Brier 技巧分 BSS、期望校准误差 ECE 与最大校准误差 MCE、校准斜率 b 与截距 a(拟合 logit(y)~a+b·logit(p))、大局校准 CITL,以及分箱明细表与逐箱实测/期望事件数的 z 检验(带 Holm 校正)。分箱数由顶部的“分箱数”控件给,默认 10。
需要准备什么数据
- 放入[二分类]结局变量:不限
- 放入[定量]预测概率:不限
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[二分类]结局变量」必须正好是 2 个类别。
- 「放入[二分类]结局变量」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 手上已有一列预测概率,要评价它给出的概率本身是否可信
- 外部验证:把已发表的模型套到自己队列上,看要不要重校准
- 比较 Platt 缩放或等渗回归等再校准手段的前后效果
- TRIPOD 等报告规范要求同时给出校准图、校准斜率与截距
数据要求:至少 20 行、缺失比例不超过 20%、不允许常数列;结局恰两类且两类都要出现,每类至少 5 例;预测概率必须是落在 0~1 之间的连续数值列——如果手上是 logit 或评分,得先转成概率。20 行这个门槛相当于默认 10 箱下每箱 2 例,箱一多就该按比例增加样本。卡①还会核对各箱的期望事件数与期望非事件数是否都 ≥5(示例 10 箱里有 3 箱不达标,卡方近似的偏差因此增大)。
什么时候不要用它
- 你还没有预测概率,手上只有原始自变量:先用「逻辑回归」建模拿到概率列,再回来做校准。
- 你要问的是“能不能把高低风险分开”:那是判别能力,用「ROC曲线分析」。
- 你要问的是“按这个模型做决策划不划算”:那是临床效用,用「决策曲线分析(DCA)」。
- 你要问的是“加了新指标之后,有多少人被重分到了更正确的风险层”:用「NRI/IDI 重分类改善」。
- 结局是事件发生的时间而不是二分类:用「Cox比例风险回归」。
容易误读的地方
- 分箱数一改,Hosmer-Lemeshow 的结果与 ECE/MCE 全变,而校准斜率、截距和 Brier 一动不动。 实测同一份数据:g=10 时 χ²=10.366(df=8,p=0.2403)、ECE=0.0591、MCE=0.1804;把分箱数改成 5,变成 χ²=4.588(df=3,p=0.2046)、ECE=0.0423、MCE=0.0923。而校准斜率 0.915、截距 −0.215、CITL −0.234、Brier 0.1834 两次完全相同——它们来自回归,不经过分箱。所以 HL 的那个 p 不是校准好坏的最终裁决,报告时必须写明分箱数取了多少。
- HL 不显著只说明“没有检出失准”,不等于“校准良好”。 它的功效随样本量上升:大样本下微不足道的失准也会显著,小样本下严重失准也可能不显著,卡①与卡⑤两处都点了这条。真正描述失准形态的是斜率与截距:斜率 <1 表示预测过于极端(高风险被高估、低风险被低估,通常是过拟合的痕迹),CITL 偏离 0 表示整体风险水平有系统性偏移。示例斜率 0.915(95%CI[0.691, 1.139])与 1 无显著差异。
- Brier 分数里混着校准和判别两部分,不能当纯校准指标读。 卡④把它按 Murphy 分解摊开:示例 Brier=0.1834 = Reliability 0.0063 − Resolution 0.0717 + Uncertainty 0.2500,另有 −0.0011 的分箱分解残差被如实单列。其中 Uncertainty = ō(1−ō) 完全由基础事件率决定、与模型毫无关系,所以事件率不同的两个研究的 Brier 不能直接比大小;要跨研究比就看 BSS(示例 0.2663,>0 才优于“人人给总体事件率”的无信息基线)。
- 用同一批数据拟合出来的概率再拿回来做校准,结果必然偏乐观。 卡⑤的外部验证提示写明了这一点:表观校准好看不算数,结论应基于独立数据,或交叉验证/自举校正后的预测概率。这一条比报告里任何一个统计量都更能决定结论站不站得住。
- 正类是自动判定的,判反了整套结论的符号会翻过来。 卡①表注写着“正类由结局列的取值自动判定,请核对是否与研究定义一致”,卡①的概览表也把“正类=1、负类=0”明确打出来。正类认错时,平均预测概率与实际事件率的比较、校准截距与 CITL 的正负号都会反向,而报告本身不会报错。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:校准主结果表
- 输出结果三:可视化(校准曲线与分箱对比)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
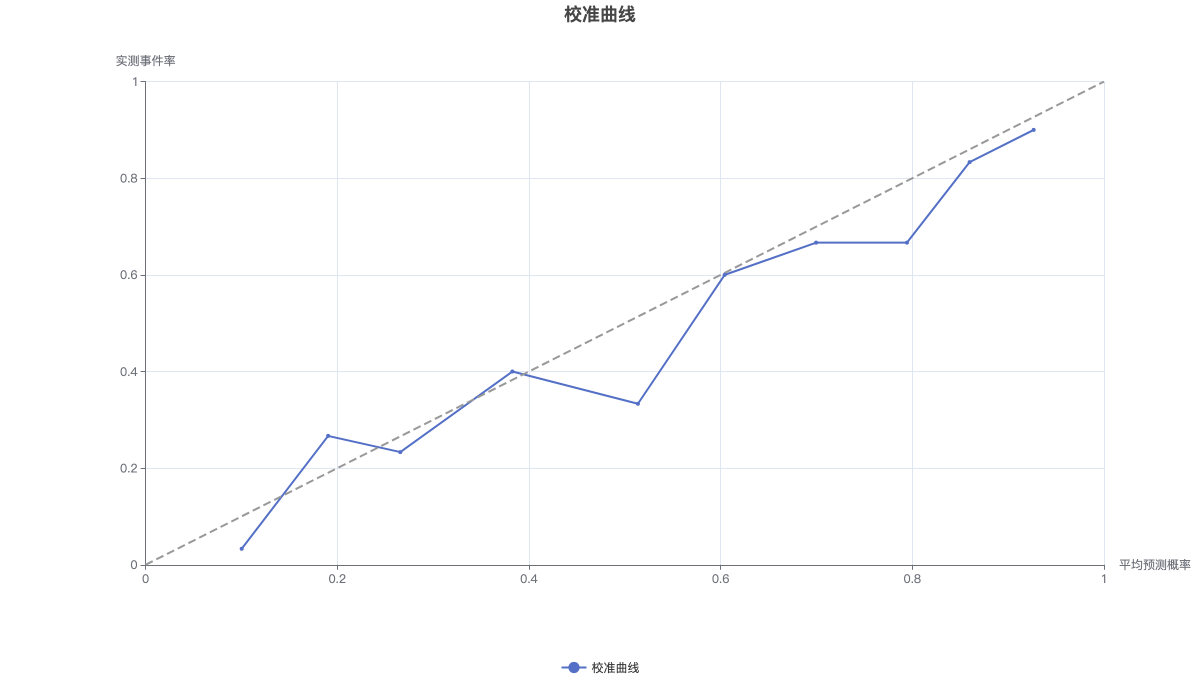
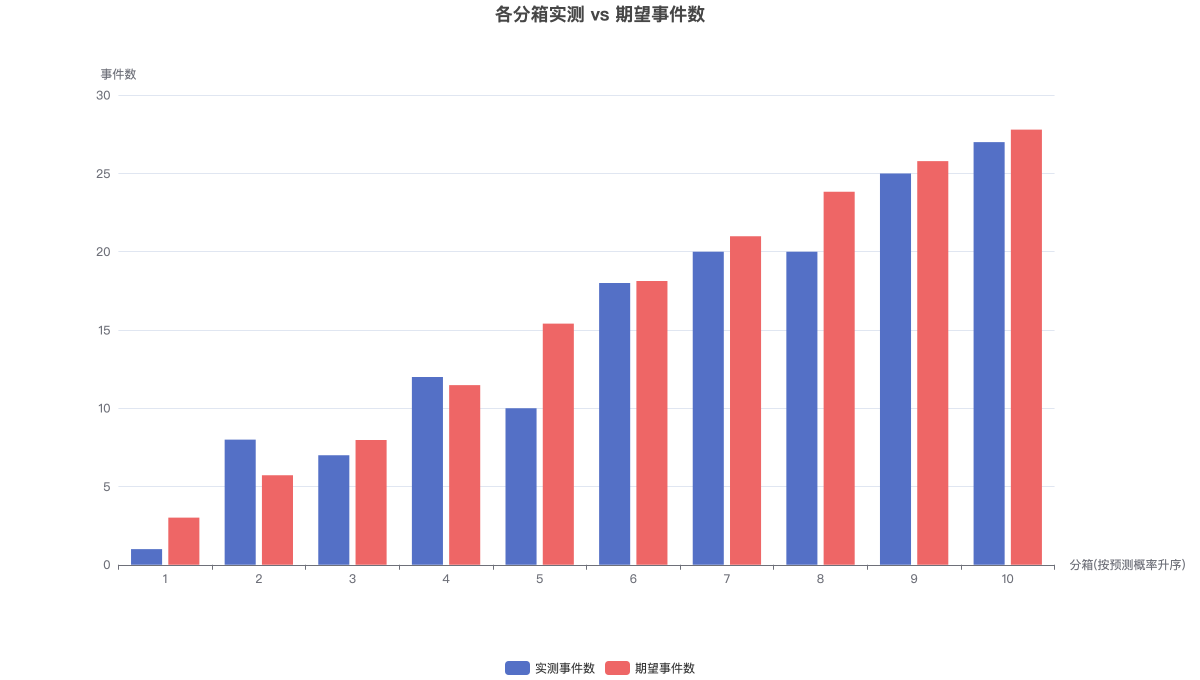
点越贴近对角线校准越好;点在对角线下方=高估风险,上方=低估风险。