
GBDT梯度提升回归
这个方法是做什么的
预测一个数值型因变量,路子和装袋类算法正相反:不是并排训练一堆树再平均,而是串行推进——先给出一个初始预测,然后每一轮新长一棵浅树去拟合上一轮剩下的残差,乘以学习率加到当前预测上,如此 100 轮。默认单棵树只有 3 层,拟合能力靠轮数累积而不是靠单棵树的复杂度。所以“弱学习器数量”与“学习率”是一对必须一起调的旋钮:学习率调小就要把轮数加上去,轮数加多而学习率不动,加的就是过拟合。定类自变量可直接拖入,管线内独热编码;同样不产出回归系数。
报告共五张卡。主结果口径是 5 折 KFold 交叉验证,表4 给验证折 R²、RMSE、MAE 的均值、折间标准差与 95%CI,另附“训练折均值”与一次留出测试集两列,表5 是逐折明细。卡① 给建模设置、变量描述与前提诊断(n∶p 比、尺度差异、VIF、因变量分布形态、疑似数据泄漏、重复观测);卡③ 给逐折 R² 柱状图、拟合散点与残差图;卡④ 给测试集上 20 次随机重排的置换重要性、Cohen f² 与“相对均值基线的 RMSE 降幅”;卡⑤ 给可誊入论文的表述。这一族八个模块的报告结构相同,本模块的着眼点是:默认设置在几个提升类算法里最轻(100 轮 × 深度 3,「XGBoost回归」是 200 轮 × 深度 6),所以这里较低的训练折 R²(本次 0.8917,XGBoost 是 0.9996)不代表模型更好。
需要准备什么数据
- 放入因变量Y:不限
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 结构化表格数据,关系非线性且带交互,希望把预测精度做得比开箱即用的装袋类算法更高
- 愿意花时间成对调“学习率 + 轮数”,而不是只跑默认值
- 自变量里定量与定类混杂,且不打算手工设定函数形式
- 需要的是变量重要性排序及其不确定性,不是系数与显著性
前提:因变量必须是连续数值且有真实波动。有效样本量建议 ≥30,且“样本量 / 独热编码后特征维度”比值 ≥10,卡① 表3 会给出实测值与判定。本模块的数据要求里另有一条针对本算法的提醒:逐轮拟合残差,弱学习器数量过多时容易过拟合,样本量越小越要压住树深与学习率——瓶颈在“轮数与样本量的配比”,不是绝对条数。所选变量上有缺失的整行会被剔除;缺失比例高的列先补齐再进模型,可用「多重插补」。
什么时候不要用它
- 因变量是类别:用「GBDT梯度提升分类」。
- 要系数、置信区间与 p 值:本模块一项都不给。要可解释的系数表用「线性回归 (最小二乘法)」;自变量多、想同时做筛选用「Lasso回归」。
- 因变量是计数(每天的投诉件数):本模块最小化平方误差、预测值可以是负数与小数,对计数不合适;用「计数数据回归」。
- 样本量大、特征多,跑不动:本模块逐个候选切点扫描,样本一多就慢;改用直方图算法的「LightGBM回归」。
- 要预测训练范围之外的取值:梯度提升树不能外推(见下),用「线性回归 (最小二乘法)」。
- 观测之间不独立(同一对象多期、分层嵌套):用「面板模型」或「混合模型」。
容易误读的地方
- “大效应”和“预测能力有限”同时出现,不是自相矛盾。 本次卡④ 给 Cohen f²=0.3522,判定“大效应(f²≥0.35)”,而卡⑤ 的结论写的是“预测能力有限……现阶段不建议直接用于决策”。因为 f²=R²/(1−R²),0.35 这条线换算回去只要 R²≥0.259,本次 R²=0.2605 刚好越线。Cohen 的基准回答的是“解释力放在社会科学惯例里算不算可观”,不回答“误差是不是小到能拿来做决策”。判断后者要看同一张表的“相对均值基线的 RMSE 降幅”——本次是 15.45%,即比“不看自变量、一律预测均值”只好了一成半。
- 加轮数不是免费的精度。 本次训练折 R²=0.8917、验证折 R²=0.2605,落差 0.6312。每一轮都在专门拟合上一轮的残差,而残差里既有信号也有噪声,轮数一多就开始把噪声也记住。本模块控件里没有早停,轮数是否过头只能自己判断:一次只改一个参数重跑,看表4 里“训练折均值”与“交叉验证均值”这两列的落差——落差持续变大而交叉验证均值不涨,就该往回调轮数、调小最大深度或降低学习率。同一张表最右的“留出测试集”是另一次划分,种子已与交叉验证错开,但它仍不是第二次独立验证:交叉验证跑在全部 240 条上,那 48 条留出样本照样进了各折的训练折。它也只是单次结果——本次 0.2546 与交叉验证均值 0.2605 几乎重合纯属巧合,表5 里五折从 0.1368 一路跳到 0.4944。
- 除非数据里已标明变量类型,唯一值不超过 10 个的数值自变量会被当成定类处理。 判定发生在建模之前:一个只有 5 档取值的评分列(1~5 分)会被独热成 5 个 0/1 列,而不是当连续变量参与分裂。看卡① 表1 的“自变量个数”行(示例是“3(定量 3,定类 0)”)和表2 的“类型”列,可以确认每个变量实际被当成了什么。这件事会同时改变 n∶p 比的分母和树的分裂方式,也会让“单位增加一档”的直觉失效——独热之后模型看到的是几个互斥的哑变量,不再有顺序关系。
- 置换重要性会在相关的自变量之间互相稀释。 卡① 表3 的 VIF 行明说“共线不影响树模型预测精度,但会稀释置换重要性”:两个高度相关的变量,打乱其中一个,另一个还能把信息补回来,于是两个的 ΔR² 都偏小,看上去谁都不重要。本次示例最大 VIF=1.27(门店面积(平米)),没有触发;真遇到中度以上共线(VIF 5~10 或更高),先用「VIF共线性诊断」查清是哪几个变量在互相替代,再解读排序,不要直接下“这个变量不重要”的结论。重要性本身也不是因果效应,更不等价于回归系数的显著性。
- 不能外推,加法结构也救不了。 预测是初始值加上一串树的输出,每棵树的输出都来自训练样本的残差;自变量走出训练范围后,样本落进同一批边界叶子,每棵树都吐出同一个数,累加结果就是一个常数,不会沿趋势继续走。本模块示例数据里“门店面积”是 79.0~368.8 平米,超出这个区间的预测没有依据。要沿趋势外延,回到有明确函数形式的「线性回归 (最小二乘法)」。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(交叉验证性能)
- 输出结果三:可视化(逐折性能 / 拟合散点 / 残差)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
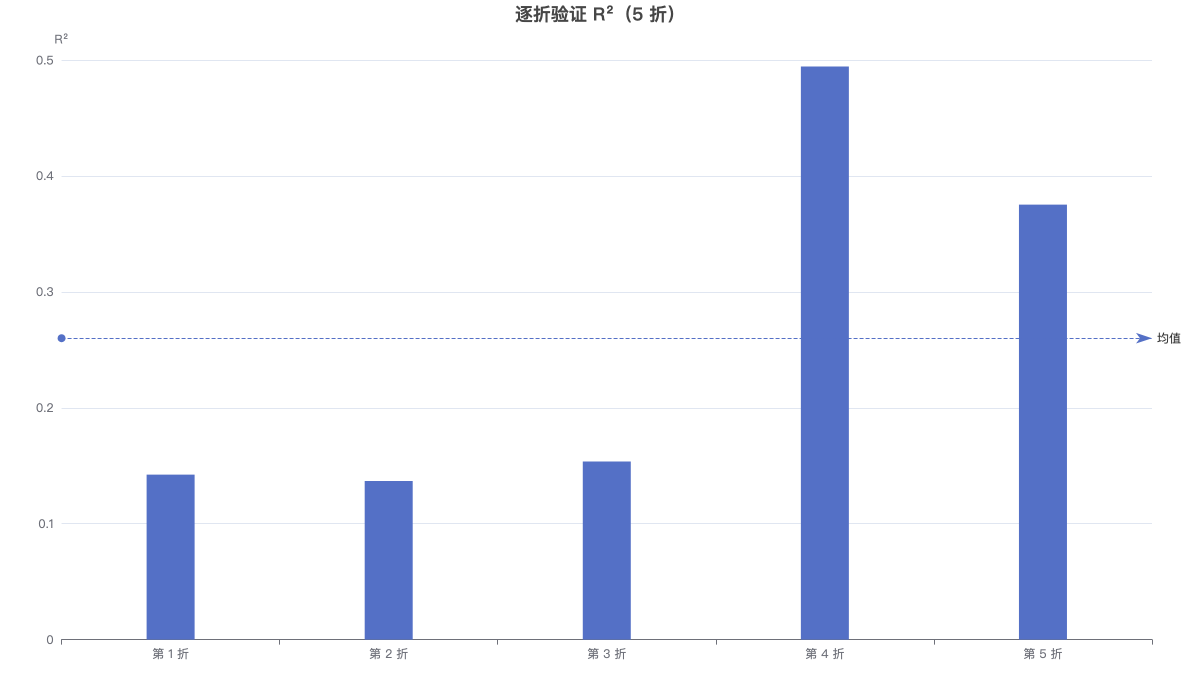
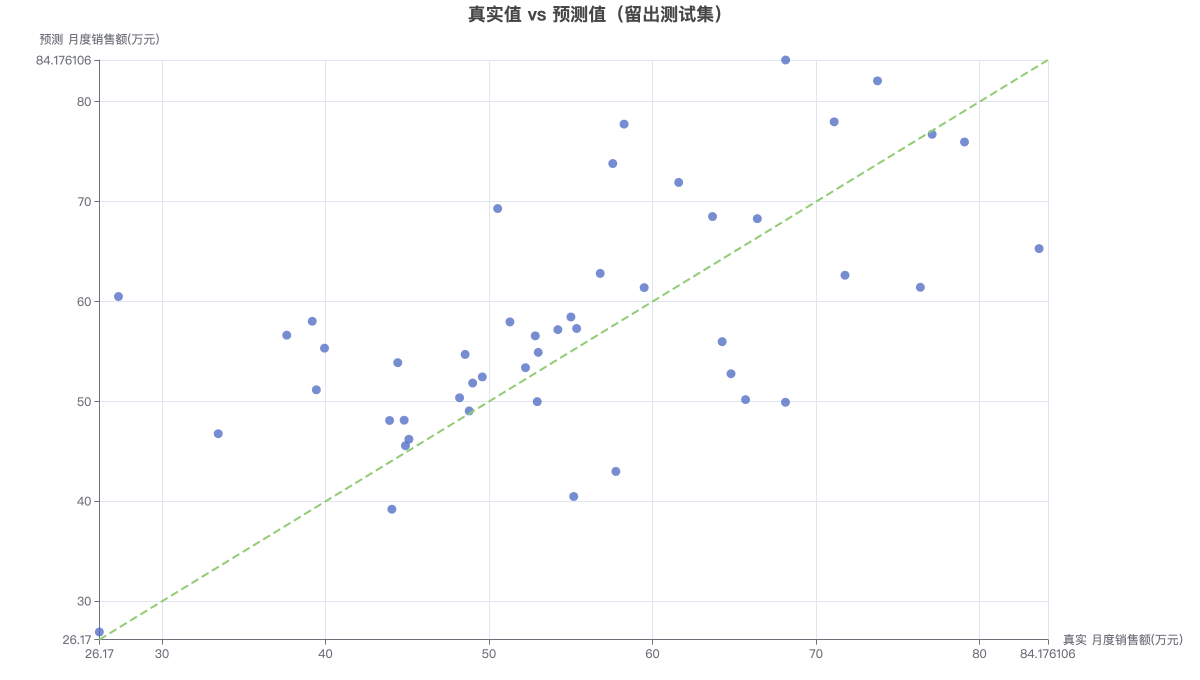
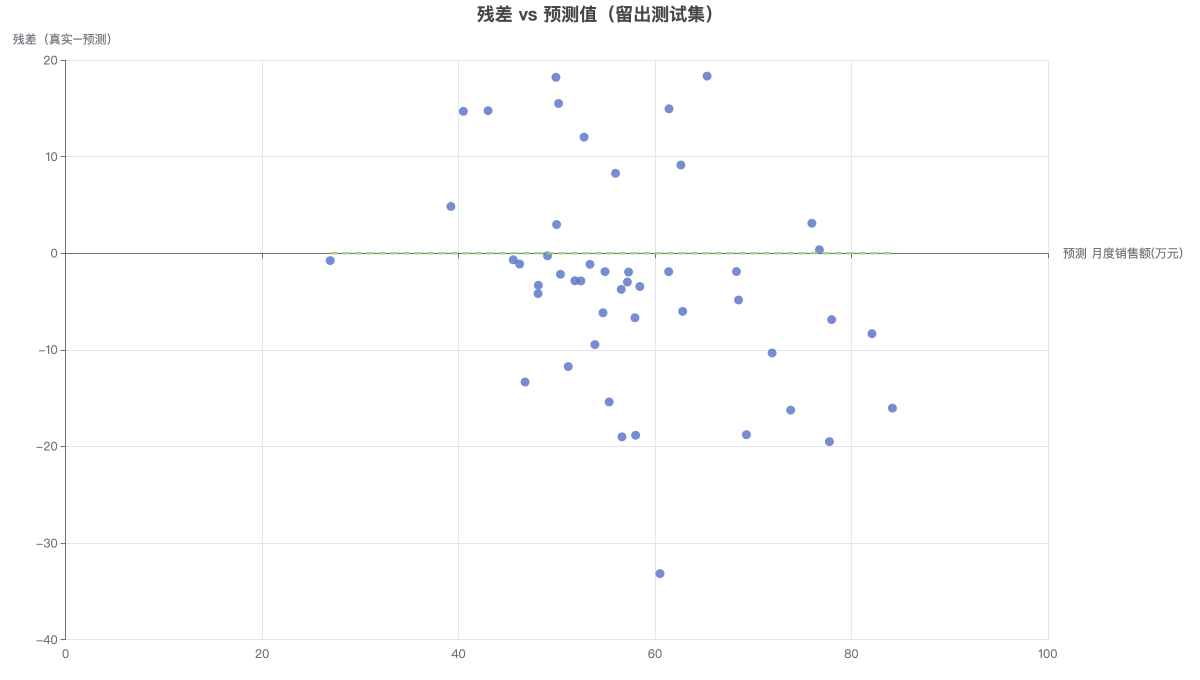
三张图分别回答:模型在不同数据划分下稳不稳(逐折 R²)、预测值贴不贴近真实值(散点)、误差是否随预测水平系统性变化(残差图)。