
价格敏感度PSM(Van Westendorp)
这个方法是做什么的
先说清一件事:这里的 PSM 是 Price Sensitivity Meter(价格敏感度测量),跟因果推断里的「倾向得分匹配 (PSM)」只是英文缩写撞名,两者在输入数据、要回答的问题和用途上毫无关系。要给处理组配对照组、平衡协变量的,请去因果推断那一栏,别在这里找匹配功能。本模块做的是 Van Westendorp 四问价格法:对同一批受访者问四个价格——多少钱算“太便宜以至于怀疑质量”、多少钱算“便宜/物有所值”、多少钱算“贵但还能接受”、多少钱算“太贵不会买”,把四组回答各画成一条累计分布曲线,两两求交点。
四个交点各有含义:OPP(太便宜 × 太贵)是最优价格点,此处抵触人数最少,常作建议零售价;IPP(便宜 × 贵)是无差异价格点,可视作多数人心里的“正常价”;PMC(太便宜 × 贵)是最低可接受价,PME(便宜 × 太贵)是最高可接受价,两者之间即可接受价格带。报告还给每个交点的 bootstrap 95%CI(对受访者重抽样 800 次)与变异系数 CV、相对价格带宽度 (PME−PMC)/OPP 作为无量纲的敏感度指标、溢价指数 OPP/IPP,以及“只保留逻辑一致问卷”的敏感性分析对照。卡① 先查逻辑序、三组单侧配对 Wilcoxon 的价格序、样本量与价格网格密度,最后一行还要查四组曲线是否真的交叉(示例为 4/4 真实交叉)。
需要准备什么数据
- 放入[定量]“太便宜”价格:不限
- 放入[定量]“便宜/物有所值”价格:不限
- 放入[定量]“贵但可接受”价格:不限
- 放入[定量]“太贵不会买”价格:不限
数据要求
- 数据表至少 100 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 新品上市前没有任何价格锚点,需要先划出一个心理上可接受的价格区间
- 判断现行定价是落在带内还是已经越过 PME
- 需要一个可跨品类比较的价格敏感度指标(相对带宽)
- 已按四问法设计好问卷、回收后需要求交点的分析
前提:四问价格各一列、均为定量,且必须来自同一批受访者按行一一对应——任一列缺失即整行剔除,因为四条曲线必须建立在同一批人身上。样本量建议 ≥100:交点是两条经验分布函数的交叉,小样本下会大幅摆动;数据不少于 100 行。同一受访者的四个报价理应满足“太便宜 ≤ 便宜 ≤ 贵 ≤ 太贵”,本模块不剔除违反逻辑序的问卷,只在卡① 报比例、在卡④ 给出剔除与不剔除两套结果供你对照。
什么时候不要用它
- 你要找的其实是因果推断里的倾向得分匹配:那是完全不同的方法,用「倾向得分匹配 (PSM)」;要和双重差分结合的用「PSM-DID」。这两个模块在“因果推断”分类下,输入是处理标记与协变量,与这里的四列价格没有任何交集。
- 想知道某个具体价位能卖出多少、赚多少:PSM 只给心理接受区间,不含销量与收益预测,卡① 与卡⑤ 都写死了这一点。要按价位算购买率与预期收益,用「价格断裂点(Gabor-Granger)」。
- 价格要和其它产品属性放在一起做取舍:用「联合分析(Conjoint)」,它把价格当作一个属性,能给出价格相对品牌、功能的重要度。
- 只问了一两个价格问题(比如只问“你能接受的最高价”):四个交点各需要两条曲线,缺一条就没有对应的价格点。单一价格问题的分布与分位数用「描述性统计」或「频数分析」看。
- 四问价格的逻辑序大面积违反(受访者把“太便宜”报得比“太贵”还高):这不是换个方法能修的,说明问项顺序或语义被误解。先用「描述性统计」核对四列均值是否依次递增,再决定要不要重新收数据。
容易误读的地方
- 这个 PSM 不是倾向得分匹配。 Price Sensitivity Meter 与 Propensity Score Matching 共用一个缩写,是这个模块最常见的走错门原因。前者输入四列价格、输出一条心理价格带;后者输入处理标记与协变量、输出匹配后的协变量平衡与处理效应。看到 PSM 先确认要的是哪一个——走错的代价不是多点几下鼠标,而是把定价问题当成因果问题做完并写进报告。
- 四个关键价格点是两条经验分布函数的交点,抽样波动比均值类统计量大得多。 卡⑤ 的研究局限直说了:解读时应以 bootstrap 区间而非点估计为准。示例 OPP=159.50,区间却是 [152.50, 178.00],上界比点估计高了一成多。把 159.50 当成一个精确的建议零售价,等于把一个宽区间读成了一个点。同一件事还体现在 CV 那几行(OPP 0.0434、PMC 0.0236、PME 0.0227)——交点落在曲线越陡的位置越稳,越平缓越飘。而且“交点”这个叫法本身有前提:某两条曲线在价格区间内没有真正交叉时,模块退化为取距离最近的网格点,卡⑤ 会追加一条研究局限指明该价格点是退化解、不应按交点解读。卡① 最后那一行查的就是这件事。
- 可接受价格带不是“定在里面就卖得动”。 卡① 的结论文案把边界划得很清楚:PSM 回答“定多少不会被拒绝”,不回答“定多少赚得最多”。示例区间 [139, 199] 只表示低于 139 会引发质量疑虑、高于 199 会大量流失购买意愿;这个区间里每一档的销量、毛利和市场容量,PSM 一个字都没说。把 OPP 当成收益最优价,是把两个不同的问题混成了一个。
- 四个问题的措辞就是结论本身。 这四问互为锚点:把“太便宜”问成“便宜到你会怀疑是假货的价格”和问成“你觉得很划算的价格”,得到的曲线完全不同,四个交点会整体平移。问卷里若先展示了产品详情或竞品价格,受访者的报价同样会被锚定。所以两份 PSM 结果只有在问法逐字一致时才可比。样本也是同理:这条价格带是这 220 个人的心理带,用自家社群或同事跑出来的区间,换一群人就会移位——代表性比样本量更要命,而后者才是大家习惯去核对的那个数。
- 逻辑序违反的问卷,模块不替你删。 卡④ 那张敏感性分析表的表注写着:本模块不自动剔除,只提供“全样本”与“仅逻辑一致样本”两套结果,剔除与否属研究者的判断,不应由软件代替决定。示例里逻辑一致率 100%,所以这张表显示“不适用”。真有不一致问卷时,两套结果差得越多,说明结论越依赖你的清洗决定——此时必须把两套都报出来,只报其中一套就是在藏掉一个关键的自由度。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:关键价格点与可接受价格区间
- 输出结果三:可视化(敏感度曲线与关键价格点稳定性)
- 输出结果四:价格带指标(效应量)与敏感性分析
- 输出结果五:结论与学术表述
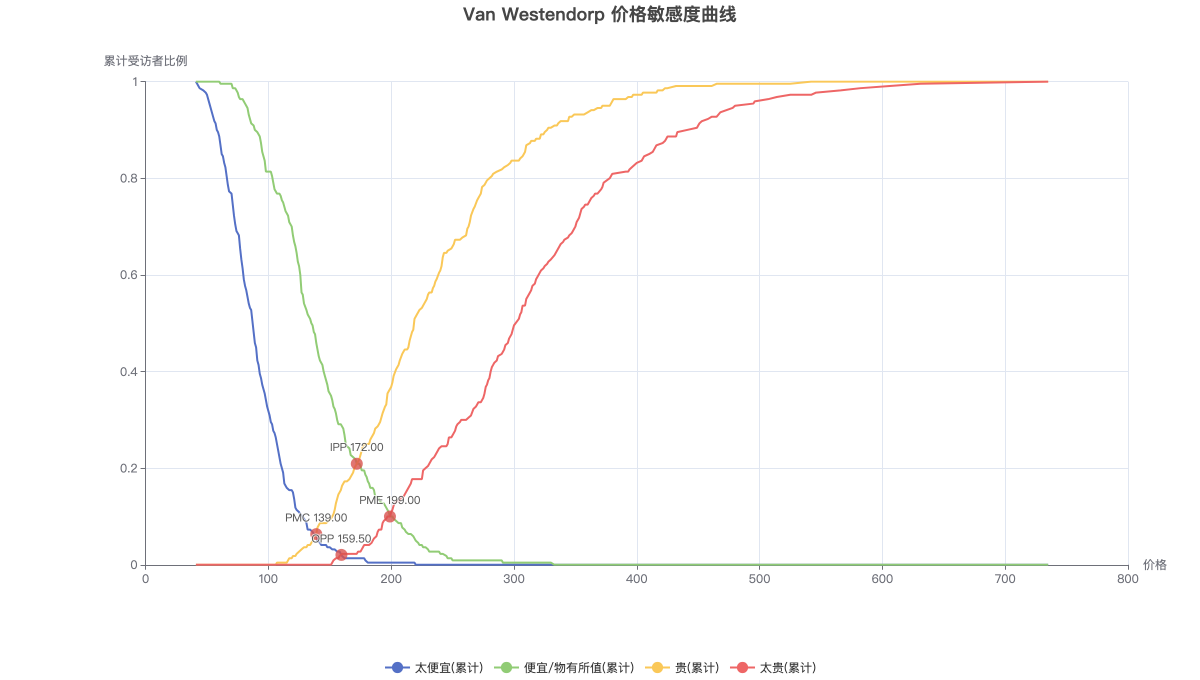
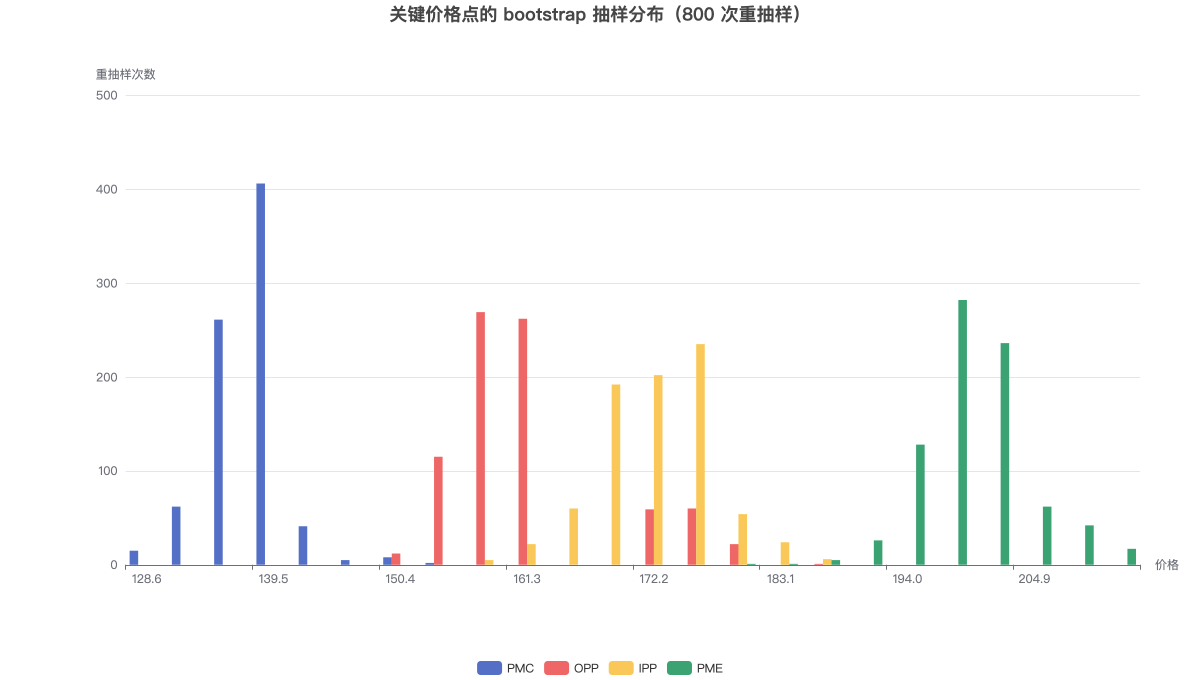
上图为四条累计曲线与其两两交点(红点),切到「表格」视图可读取任意价格处的四条曲线取值;下图为四个关键价格点在 bootstrap 重抽样下的实际分布。