
空间滞后模型(SLM/SAR)
这个方法是做什么的
用于“一个地方的取值会被邻近地方带动”的数据。模型写作 y=ρ·W·y+Xβ+ε:在普通回归的基础上多一项因变量自身的空间滞后 W·y,系数 ρ 度量溢出强度,ρ>0 表示相邻单元同向扩散(高值聚高值),ρ<0 表示空间竞争或挤出。空间权重 W 由你拖入的经纬度按大圆弧距构造 K 近邻(k=min(8, n−1))再作行标准化,没有可调开关。估计用 spreg 的空间两阶段最小二乘(GM_Lag),以 W·X 作为内生项 W·y 的工具变量,规避直接做最小二乘的内生性偏误。
读这份报告的第一落点不是系数表,而是卡① 的 LM-Lag 与稳健 LM-Lag 两行——它们决定了这份报告该不该存在。卡① 依次给出因变量自身的全局 Moran's I、最小二乘残差的 Moran's I,以及 LM-Lag / 稳健 LM-Lag / LM-Error 检验,按 Anselin 决策规则指示该选哪个空间模型。卡④ 给 LeSage-Pace 平均效应分解(直接 / 间接 / 总效应)与 Anselin-Kelejian 残差诊断。因为是两阶段最小二乘而非极大似然,报告不产生对数似然,也就没有 AIC/BIC 与似然比检验,拟合只以伪 R² 与残差方差衡量。
需要准备什么数据
- 放入[定量]因变量 Y:1 个
- 放入[定量]自变量 X:至少 1 个
- 放入[定量]经度:1 个
- 放入[定量]纬度:1 个
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 空间单元是地理实体(区县、城市、地块、监测站),因变量本身会跨界扩散:房价、污染物浓度、疫情、创新产出
- 卡① 的稳健 LM-Lag 显著而稳健 LM-Error 不显著,诊断明确指向滞后型
- 你要回答的问题里包含“某地的变化会带动邻近地区多少”,也就是需要间接效应这个量
- 最小二乘残差的 Moran's I 显著,说明普通回归的标准误与 p 值已经不可信
每行必须是一个带坐标的空间单元,经度与纬度各拖入一个定量列,不能同列、也不能与因变量或自变量重复,坐标须为十进制度且存在空间变异。至少 10 个空间单元,有效样本量还需不少于“自变量个数+2”;因变量与自变量须为定量非常数列。
什么时候不要用它
- 诊断指向误差型(稳健 LM-Error 显著、稳健 LM-Lag 不显著):空间结构在扰动项里而不在因变量里,用「空间误差模型(SEM)」。此时硬套滞后模型会把误差的空间相关错记成溢出。
- 两个稳健 LM 都显著,或理论上邻居的自变量也会影响本地:用「空间杜宾模型(SDM)」,它同时含 W·y 与 W·X。
- 只想先弄清有没有空间自相关、热点冷点落在哪里:用「莫兰指数(全局+局部LISA)」,它给全局 I 与局部 LISA 四象限,不需要设定回归方程。
- 没有坐标,只有个体×时期的二维结构:本模块必须由经纬度构造 W,用「面板模型」,它按个体与时间做变换。
- 同一批单元的多期观测(空间面板):本模块按单一截面处理,每一行都被当作一个独立的空间单元——同一个城市的 5 年数据会变成 5 个坐标相同的单元。可行的做法是分期各跑一次再比较 ρ,或改用「面板模型」并在文中说明未建模空间结构。
- 需要用 AIC/BIC 或似然比在多个设定之间做选择:两阶段最小二乘不产生对数似然,本模块给不了;空间设定的取舍只能依据卡① 的 LM 诊断,拟合比较只能看伪 R² 与 Anselin-Kelejian 检验。要按信息准则筛自变量,先在不含空间项的「线性回归 (最小二乘法)」里定好变量集合(必要时配「逐步回归」),再把定下来的变量放回本模块重估。
容易误读的地方
- 系数表里的 β 不是边际效应,卡④ 的分解才是。 因为 ρ·W·y 带来反馈回路:i 影响 j,j 又反过来影响 i。演示数据里“人均可支配收入”的 β=1.5362,而直接效应 1.6901、间接(溢出)效应 3.1896、总效应 4.8797——只报 β 会把真实效应低估到三分之一。卡④ 的表注把这一条写死了:“本表才是可解释的效应量;系数表中的 β 只是模型参数”。
- 这个模块答不了“哪个自变量的溢出更强”。 行标准化权重下,总效应与 β 的比值恒等于 1/(1−ρ),与是哪个变量无关:演示数据里两个自变量的空间乘数都是 3.176,间接/直接之比也都是 1.887。溢出只经由 W·y 一条通道,所有自变量共用同一个放大系数,这是模型结构决定的,不是数据碰巧如此。要让不同自变量拥有各自的溢出强度,必须改用「空间杜宾模型(SDM)」。
- 同一份报告里有两套星号档位,读星号前先看该表自己的表注。 卡① 的表注是“* p<0.001, p<0.01, * p<0.05”,而卡② 系数表与卡④ 效应分解表的表注是“* p<0.01, p<0.05, * p<0.1”——后者是计量经济学的惯用档位,报告已在表注声明。演示数据里常数项 p=0.0159、路网密度 p=0.0200 都标成 **,按卡② 的档位读是 p<0.05;照心理学论文的直觉读成 p<0.01 就错了。
- ρ 与效应分解都是“给定这个 W”的结论。 权重固定为 KNN(k=8) 行标准化,既不能改近邻数,也不能换成邻接或距离衰减矩阵。近邻数变了,谁是谁的邻居就变了,ρ 的大小甚至显著性都可能跟着变。卡⑤ 的模型局限点明了这一敏感性:论文里必须写清 W 的构造方式,不要把 ρ 当成与 W 无关的地理常数。
- ρ 显著不等于存在因果性的空间溢出。 一个被遗漏的、本身带空间结构的变量(地形、气候、共同的政策边界)会同时进入相邻单元的取值,最后被 ρ 吸收。卡④ 的 Anselin-Kelejian 检验只回答“残差里还有没有剩余的空间自相关”(演示数据 1.599,p=0.2060,已经没有了),它不能证明模型设定是对的,更不能把统计上的邻接关联升格成因果溢出。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:空间滞后模型回归系数
- 输出结果三:系数森林图与拟合散点图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
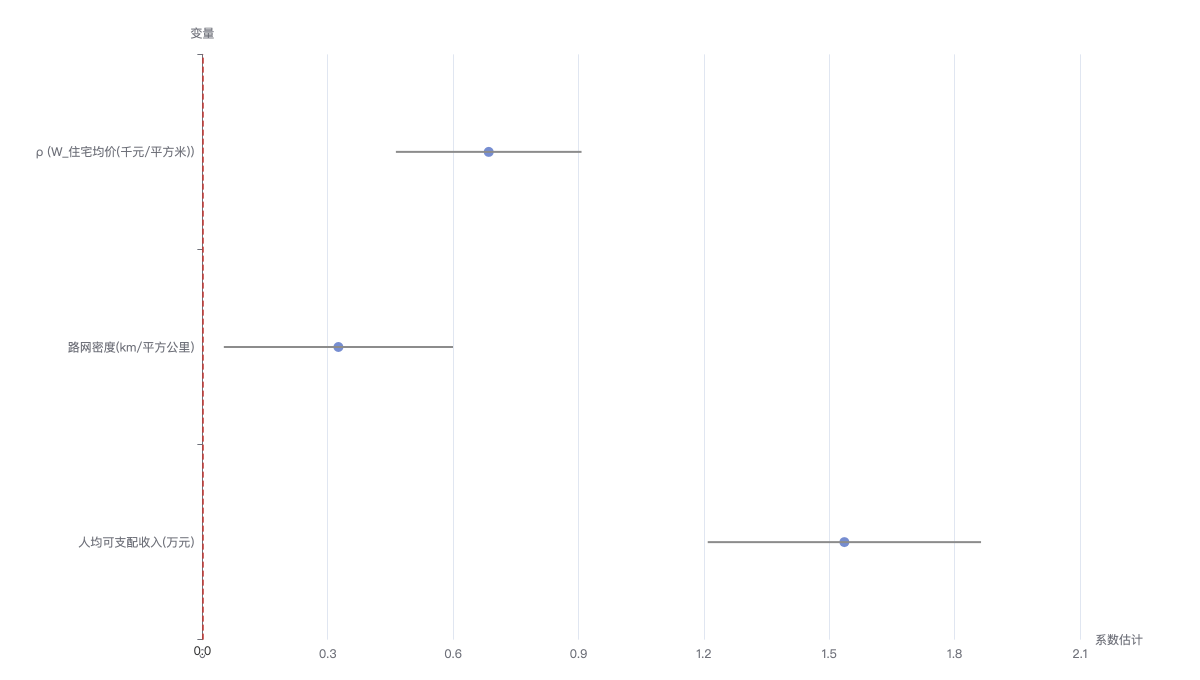
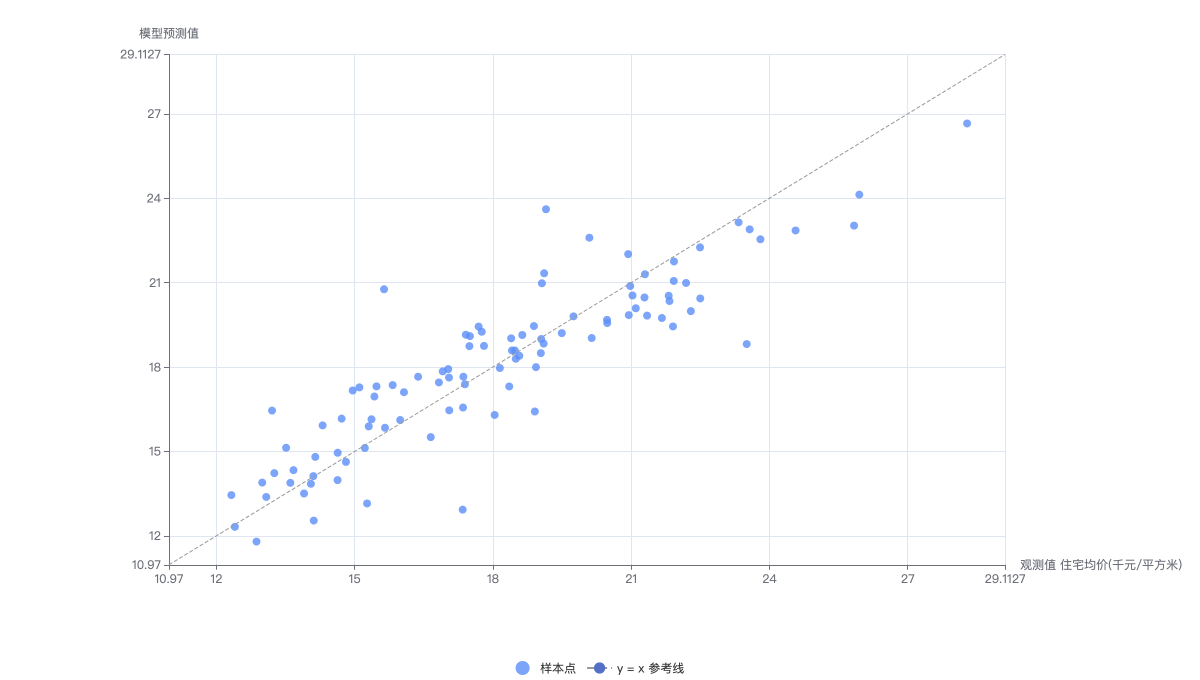
上图为各斜率系数与空间自回归系数 ρ 的森林图(点=估计值,横须=95%置信区间,口径与系数表一致:估计 ± 1.96×标准误;已略去截距以免压扁其余置信须);下图为观测值 vs 模型预测值散点,越贴近 y=x 对角线拟合越准确。