
决策曲线分析(DCA)
这个方法是做什么的
决策曲线回答的不是“模型准不准”,而是“按这个模型决策,比‘所有人都干预’和‘所有人都不干预’这两条默认策略更划算吗”。它的核心量是净获益 NB = TP/n − FP/n × pt/(1−pt)。这里的阈值概率 pt 就是你的风险偏好:pt=0.10 等价于认为漏掉 1 例真阳性的代价相当于 9 例不必要的干预,pt 越低越看重不漏诊。曲线在两条参考线之上的那一段,就是按模型决策真正划算的风险偏好区间。
报告在 0.01~0.99(步长 0.01,共 99 个点)上扫描阈值,给每个概率列的最大净获益及其阈值、优于两条默认策略的阈值区间(可以不连续),以及 0.05/0.10/0.15/0.20/0.30/0.50 六个常用阈值处各策略的净获益对照与“该阈值下最优策略”。第四张卡给标准化净获益 sNB=NB/患病率、每 100 人净减少的不必要干预数、平均净获益增量,以及多模型之间净获益差的配对 bootstrap 检验(500 次重抽样、固定种子,Bonferroni 校正)。第一张卡先把每列概率的 Brier、BSS、校准截距与斜率、Hosmer-Lemeshow 检验摆出来——校准是 DCA 的前提,不是附赠品。
需要准备什么数据
- 放入[二分类]结局变量:不限
- 放入[定量]模型预测概率:至少 1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[二分类]结局变量」必须正好是 2 个类别。
- 「放入[二分类]结局变量」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 两个模型的 AUC 差不多,你要判断哪一个更值得真的拿去用
- 论证“再加一个检查指标是否值得”:把新旧两列概率一起拖进来比
- 需要一句能对临床讲的话:“同样不漏诊的前提下,每 100 人可以少做多少次不必要的检查”
- 审稿人要求在 ROC 与校准之外补一张决策曲线
数据要求:至少 20 行、缺失比例不超过 20%、不允许常数列;结局恰两类且各至少 5 例;预测概率列必须是落在 0~1 的概率,不能是未经转换的评分或 logit——净获益取决于概率的绝对水平,不是排序。概率列可以放多列,一次比较多个模型。
什么时候不要用它
- 你要问的是“高低风险分不分得开”:那是判别能力,用「ROC曲线分析」。
- 你要问的是“预测的概率数值本身准不准”:那是校准,用「校准曲线」。
- 你手上还没有概率列,只有原始自变量:先用「逻辑回归」建模拿到概率。
- 你要问的是“新指标把多少人重分到了正确的风险层”:用「NRI/IDI 重分类改善」。
- 结局是“事件发生的时间”,净获益的 TP/FP 计数无从定义:用「Cox比例风险回归」,先把风险预测建立在生存框架里。
容易误读的地方
- 把所有概率同比例放大或缩小,AUC 一点都不变,净获益曲线却会整个走样。 卡①的结论文案就是这么写的,这也是这张卡为什么必须先看的原因。示例里“模型B预测概率”的校准斜率只有 0.5245、Hosmer-Lemeshow p<0.001,它优于默认策略的阈值区间因此被切得支离破碎——0.03~0.03、0.39~0.82、0.94~0.94、0.98~0.99;而校准良好的“模型A预测概率”是连成片的 0.02~0.18、0.20~0.99。卡①明说:校准斜率明显小于 1 时应先重校准再画决策曲线,否则模型的临床价值会被低估。
- “最大净获益”那一列几乎没有临床意义。 它通常落在扫描区间最低的阈值 0.01 上——此时几乎所有人都被判为阳性,净获益趋近患病率。示例两个模型的最大净获益都是 0.5320、都在 pt=0.01,模块自己的文案也直说“该点本身并无临床意义”。正确读法是先由临床代价权衡定下 pt 区间,再在这个区间内比较曲线高低,而不是比整条曲线。
- “每 100 人净减少干预数”可以是负的,看到负号不是算错了。 示例“模型B预测概率”在 pt=0.05/0.10/0.15/0.20/0.30 处分别是 −4.7 / −6.7 / −3.0 / −4.0 / −3.9,意思是在这些阈值下按它决策还不如直接“所有人都干预”;到 pt=0.50 才转正为 11.7。这个量是相对“全部干预”算的,与相对“全不干预”的比较是两回事。
- 两两比较的 bootstrap 把预测概率当成已知常量。 表注写明它没有在每个重抽样样本里重新拟合模型,因此概率若来自与本数据相同的拟合样本,置信区间会偏窄、结论偏乐观;p 值的分辨率下限约 2/(B+1)=0.0040。示例 6 次比较里未校正 p 有 3 个小于 0.05(0.012、0.020、0.024),Bonferroni 校正后最小的也只有 0.072,一个都不显著——下结论请用校正列。
- DCA 假定假阳性与假阴性的代价比恒等于 pt/(1−pt)。 卡⑤的局限性写明:代价随个体变化时需改用更一般的决策分析模型。还有一条同样重要——如果模型在你真正关心的阈值区间里并不优于默认策略,那就如实报告,这是有价值的阴性结论,不该靠挑一个碰巧占优的阈值来回避。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:净获益摘要(主结果表)
- 输出结果三:决策曲线可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
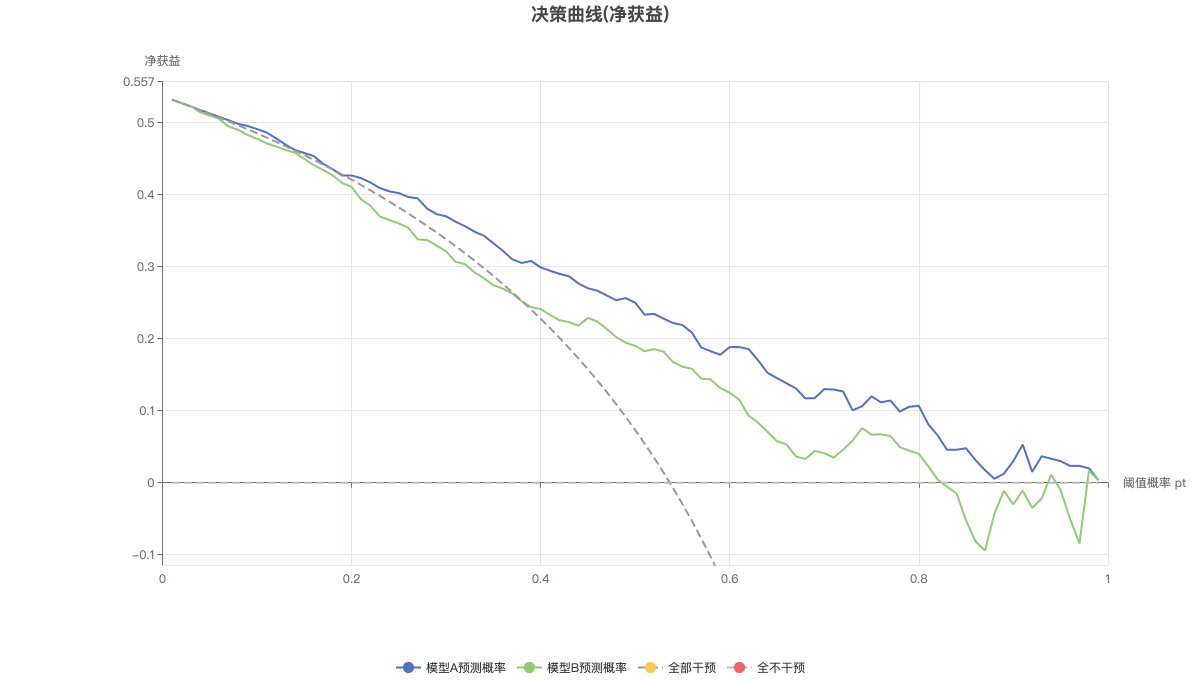
横轴为阈值概率,纵轴为净获益;模型曲线在参考线之上的区间即临床获益区间。可用切换器在「曲线 / 柱状 / 数据表」之间切换(数据表为 0.05 步长的净获益网格)。
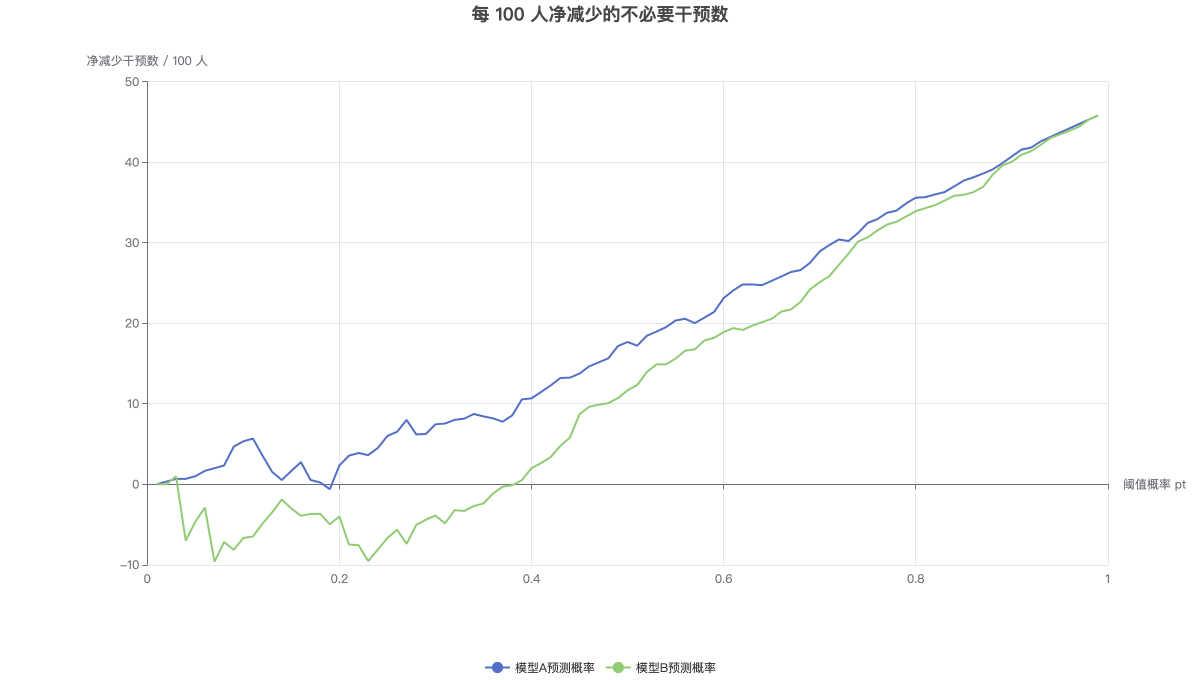
第二张图为「净减少干预数」曲线(避免的不必要干预数 / 100 人)= (NB_模型 − NB_全部干预) ÷ [pt/(1−pt)] × 100,把净获益换算成更易沟通的临床单位。