
TURF触达频次分析
这个方法是做什么的
回答一个组合问题:在若干候选方案里挑 K 个(K 就是界面上唯一那个控件“组合规模K”,默认填 3),怎么挑才能让“至少被其中一个方案覆盖到”的人最多。这个去重之后的覆盖比例叫净触达率(Total Unduplicated Reach)。数据形式是每个方案一列,单元格 1 表示这位受访者被该方案触达/喜欢,0 表示没有(“是/否”“有/无”这类文本也接受,模块会先二值化)。要特别记住它的输出是组合触达率,不是单品排行榜:单独触达率最高的方案未必入选,因为 TURF 看的是谁能补上还没被覆盖的人。
报告先给逐方案的单独触达率、Wilson 95%CI,以及独占触达人数——只被它触达、没被其它任何方案触达的人数,这是该方案不可替代性的直接度量;再给方案两两之间的 Jaccard 相似度与 φ 相关,做互补性诊断(TURF 偏好 Jaccard 小、φ 为负的组合)。求解部分给贪心逐步加入的过程(每步的净触达增量及其置信区间);组合数不超过 5 万时,还会真的枚举全部组合、把全局最优并排放在旁边对照。效应量一侧给重复触达率(去重损失)= 1 − 净触达 ÷ 各方案触达率之和、平均频次、Cochran's Q 检验各方案触达率是否相同,以及 McNemar 加 Bonferroni 的两两配对比较。
需要准备什么数据
- 放入[定量/定类]方案/产品触达列:至少 2 个
数据要求
- 数据表至少 100 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 货架 SKU、菜单、口味组合:只能上 3 个,上哪 3 个覆盖的人最多
- 媒介或渠道组合:几个渠道搭在一起触达面最广、重叠最少
- 已有“每人对每个方案是/否”的二值数据,需要求最优组合
前提:至少 2 个方案列,且所有方案列必须来自同一批受访者按行对应——任一列无法判定即整行剔除,因为净触达是去重后的覆盖人数,分母必须一致。这与逐列剔除不同,会让有效样本小于单列的非空数,卡① 会把整行剔除的行数打出来。受访者不少于 100,否则候选组合之间的净触达率置信区间会宽到无法区分。方案之间要存在真实的互补性,全都触达同一批人时,加方案对净触达几乎没有贡献。
什么时候不要用它
- 你想要的是方案的重要性次序而不是组合:单方案触达率只是 TURF 的副产品。相对偏好排序用「MaxDiff最大差异分析」,各选项被勾选的比例与选项之间的组合频次用「多选分析」。
- 数据是多选题的原始选项列(一列里存着多个选项),不是每方案一列 0/1:产品内没有多选题拆分功能——“计算公式”下的“虚拟(哑)变量”按整格取值建哑列,会把“A,B,C”当成一个类别,不按分隔符拆。只能在上传前用 Excel 等工具拆成每方案一列的 0/1 再进来;只想看选项分布与组合频次,用「多选分析」。
- 想知道人群内部有几种偏好类型:TURF 只优化总体覆盖,不做分群。用「聚类分析(K-Means)」或「二阶聚类」;想看方案偏好在人群变量上的分布差异,用「列联(交叉)分析」。
- 你关心的是“哪些方案常被同一批人选中”这种关联规则:卡① 的 Jaccard 与 φ 只做两两诊断,要系统挖组合规则用「关联分析」,要看两道多选题之间的交叉用「交叉分析【多选&多选】」。
- 方案带成本,要在预算约束下选组合:TURF 只最大化净触达,不含成本,卡⑤ 的研究局限写明了这一点。要在覆盖、成本、毛利这些指标之间做加权取舍,用「优劣解距离法(TOPSIS)」或「多准则妥协解排序法(VIKOR)」。
容易误读的地方
- 单独触达率最高不等于该进组合。 卡③ 的结论文案说得很直接:单独触达率高但独占触达极低的方案,人群已被其它方案完全覆盖,可以被替换。示例里“经典原味”单独触达 51.33%、独占 31 人,而“抹茶风味”单独触达只有 33.33%,却因为与前者重叠低(Jaccard 0.1925、φ=−0.1462)在第二步贡献了 19.67 个百分点的净增量。把 TURF 报告读成一张方案排行榜,是这个模块最常见的误用——排行榜在卡① 的第一张表里,但那不是结论。
- 净触达随 K 增长必然单调不减,所以“K 越大越好”是句废话。 每加一个方案覆盖只会增不会减,真正的问题是边际增量什么时候不值了。示例三步的增量是 51.33 → 19.67 → 10.67 个百分点。表注给了判据:增量的置信区间跨度若与增量本身量级相当,这一步的边际贡献在统计上就不可靠。第三步的增量区间是 [7.66%, 14.67%],跨度 7.01 个百分点、约为增量本身的三分之二——下界离 0 尚有距离,但已经贴着这条判据的边,不宜当成稳稳到手的贡献。K 定多少要看这条曲线,不该预先拍死。
- 贪心解不保证最优,能穷举时以穷举为准。 卡② 把两个解并排放出来:这次 5 个方案、K=3 只有 10 个组合,全部枚举后确认贪心解就是全局最优。但表注同时写明贪心只有 1−1/e 的近似下界。组合数爆炸时的失效方式不是“两个解对不上”,而是模块干脆不做穷举:那两行会印成“穷举全局最优 | 未做”与“贪心解是否达到全局最优 | 未知”,你手上只剩一个无从验证的贪心解。所以那两行不是装饰,它们是你能不能直接引用这个组合的前提。
- 重复触达率高,说明组合里的方案在抢同一批人。 示例组合三个方案的触达率之和是 117.33%,净触达只有 81.67%,重复触达率 30.40%,判定写的是“预算利用效率偏低”。这个数字才是 TURF 真正的诊断指标:81.67% 看起来很漂亮,但其中有近三成的触达是花两份钱买同一个人。“平均频次 1.44”是同一件事的另一面,注意它的取值域被 K 锁死在 [1, 3],不同 K 的分析之间不能横向比这个数。
- 净触达是这批受访者的覆盖率,不是市场覆盖率。 卡⑤ 的研究局限写着:净触达基于陈述性偏好或触达标记,与真实市场触达存在系统性差距。这里有两层距离叠加:说“会喜欢”和真掏钱之间一层,这 300 个人和真实消费者之间又一层。TURF 完全按你给的样本算覆盖,没有任何机制能纠正抽样偏差,所以拿自家社群或内部员工跑出来的 81.67% 不能当成上市后的覆盖预期。另外,最优组合只在已测方案集合内成立:一个没进问卷的口味,哪怕更好也永远不会出现在结果里。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:TURF 贪心求解过程与全局最优对照
- 输出结果三:可视化(净触达增长与方案贡献)
- 输出结果四:效应量、去重效率与事后多重比较
- 输出结果五:结论与学术表述
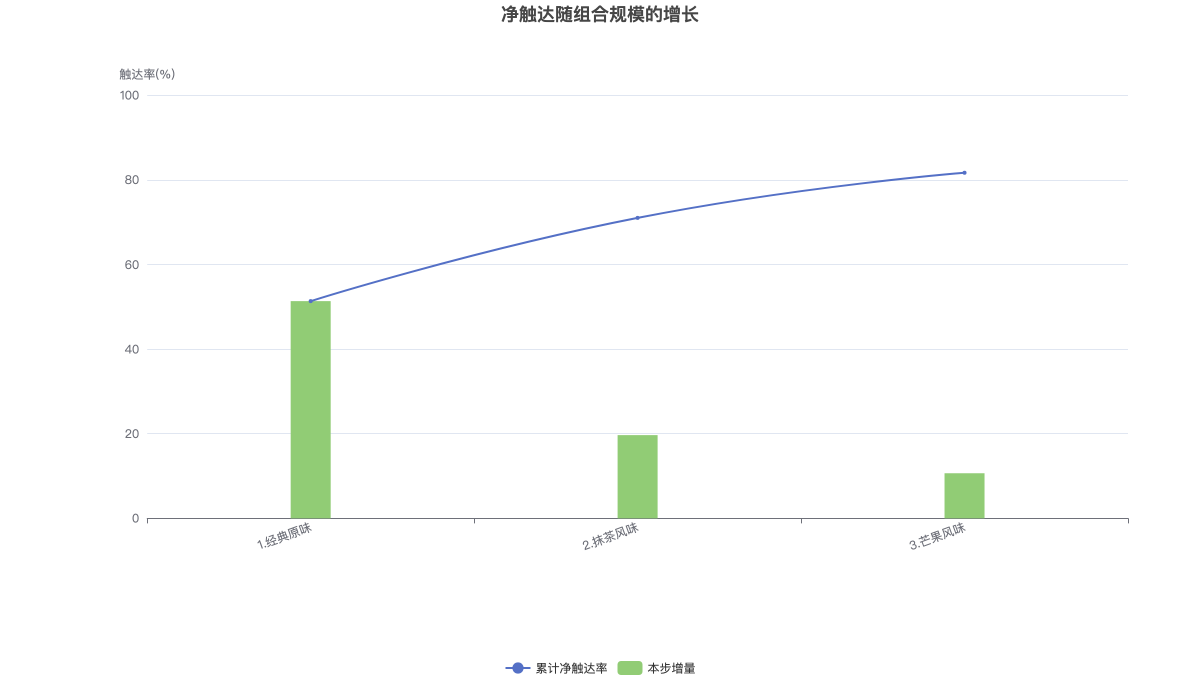
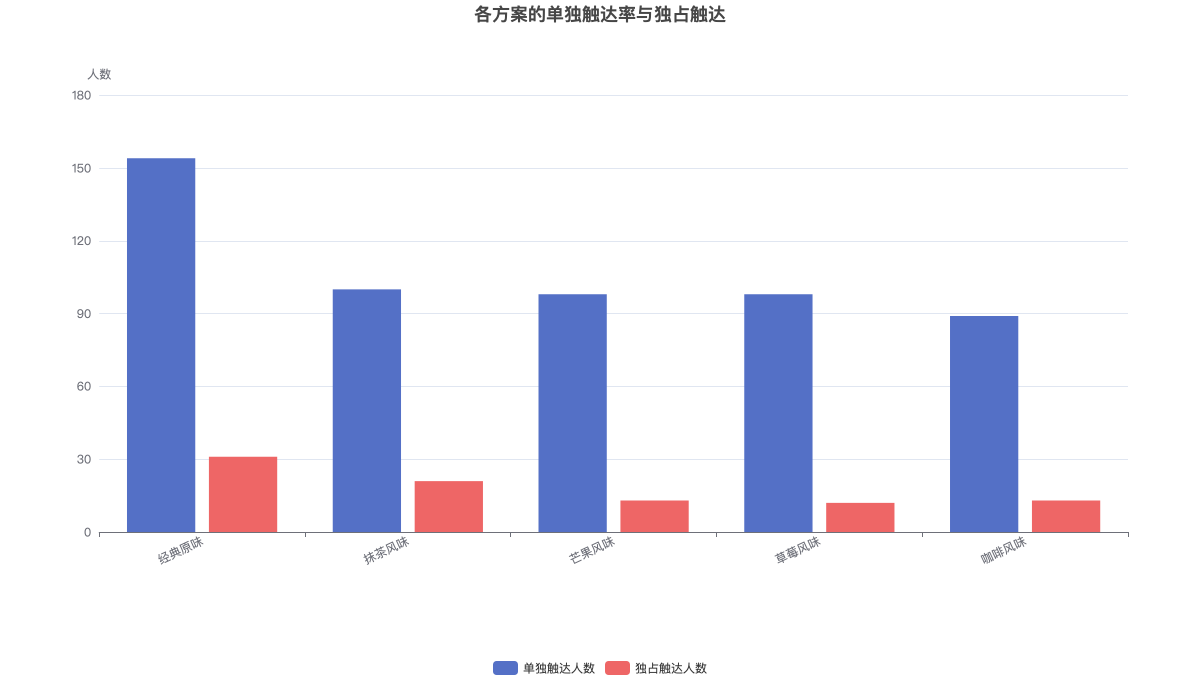
上图为净触达随组合规模的增长(折线=累计,柱=每步增量),下图为各方案的单独触达与独占触达对照。