
ROC曲线分析
这个方法是做什么的
评价一个连续的诊断评分(或模型预测概率)把两类人区分开的能力。把截断值从最低扫到最高,每个截断都算一对灵敏度与特异度,连成受试者工作特征曲线;曲线下面积 AUC 就是“随机抽一名阳性和一名阴性,阳性的评分更高”的概率。0.5 等于抛硬币,1 表示完全分开。
除了 AUC 与它的 DeLong 95% 置信区间,报告给出约登指数最大处的最佳截断及该点的完整诊断效能:真阳/假阳/假阴/真阴四格数、灵敏度、特异度、阳性与阴性预测值(均附 Wilson 区间)、似然比 LR+ / LR− 与准确率。判别力还被换算成 Gini 系数与等价 Cohen's d。评分区可以一次拖入多列,第四张卡会用 DeLong 相关样本检验做两两比较并作 Bonferroni 校正——示例两个模型 AUC 差 0.020,p=0.388,95%CI[−0.025, 0.065] 含 0。
需要准备什么数据
- 放入[二分类]结局变量:不限
- 放入[定量]评分/预测概率:至少 1 个,定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[二分类]结局变量」必须正好是 2 个类别。
- 「放入[二分类]结局变量」的每一组至少 10 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 一项化验指标能不能用来判断某种疾病,最佳临界值取多少
- 比较两个诊断评分或两个预测模型谁的判别力更强(同一批受试者)
- 评价一个已建好模型的预测概率,看它区分事件与非事件的能力
- 为筛查方案选阈值:在可接受的特异度下能拿到多高的灵敏度
结局必须恰好两类且两类各至少 10 例(DeLong 方差的正态近似要求),评分列必须是连续的定量变量,常数列没有判别信息会被拒。ROC 不要求评分服从正态分布,所以第一张卡不做正态性检验,取而代之的是一列“并列比例”:示例两个评分的不同取值数是 297 与 294、并列比例仅 1.0% 与 2.0%;若你的评分其实是 5 档粗分级,这个比例会很高,曲线呈明显阶梯状,最佳截断的分辨力也随之受限。
什么时候不要用它
- 结局是连续变量(评分、浓度)而不是两类:ROC 无从定义阳性阴性,改看两者的关系强度用「Pearson相关性分析」或「线性回归 (最小二乘法)」。
- 结局多于两类:本模块会直接拒绝。按研究问题合并成两类后回到这里,或改用能直接处理多分类的「随机森林分类」。
- 你真正想问的是“预测出来的概率准不准”(说 30% 的人里是不是真有约 30% 发病):那是校准而不是判别,用「校准曲线」。
- 你想知道“这个模型用到临床上到底划不划算”:判别力高不等于有净获益,用「决策曲线分析(DCA)」。
- 你要评价的是“在旧模型上再加一个新标志物带来多少增量”:单看两个 AUC 谁大不足以回答,用「NRI/IDI 重分类改善」。
- 手上还没有评分列、需要先由多个自变量建模:先用「逻辑回归」,它本身就会输出 ROC 曲线与 AUC。
容易误读的地方
- AUC 只有 0.222 的时候,p 值照样是 <0.001,先看正类是谁再看 p。 检验的原假设是 AUC=0.5、双侧,所以“显著低于 0.5”和“显著高于 0.5”都会给出很小的 p。实测把示例结局的 1 改成文字“未复发”、0 改成“复发”,模块按常见阳性词把“复发”判成正类,于是 AUC 掉到 0.222、Z=−10.573、p<0.001***,最佳截断显示“N/A(退化)”、约登指数 0.000。只盯着 p 会得出“判别力极强”的相反结论。
- 正类是模块按规则推断的,不是你指定的,而且没有控件可以切换。 规则是:结局为数值时取较大的那个值作正类(0/1 数据即 1);为文字时先找“阳性、患病、死亡、复发、事件、是、yes”等常见阳性词,找不到就按排序取后一个。所以“1=存活、0=死亡”这种编码会被判成正类=死亡,方向与你的评分正好拧着。第一张卡“结局取值数(须恰为 2)”那一行的取值栏会写明正类与负类各是谁,每次先读它;方向不对只能回到数据里重新编码结局。
- AUC 高只说明排序对,不说明概率准。 把一个模型的所有预测概率整体加 0.2,AUC 一分不变,而校准已经全坏了。第五张卡的局限性说明写明 ROC 只刻画判别,不反映校准与临床净获益——用“模型 AUC=0.78,说明预测准确”来概括是最常见的越界表述。
- 约登指数选出的截断,隐含“漏诊与误诊代价相等”这一假设。 示例最佳截断 0.5214 处灵敏度 0.732、特异度 0.714,几乎对半开。可筛查场景里漏掉一个真患者的代价远高于多召回一个人复查,此时就该主动压低阈值换灵敏度,而不是沿用约登点再抱怨灵敏度不够。截断的选取准则必须写进方法学部分。
- 阳性预测值不能跨人群搬运,似然比可以。 示例的阳性率是 51.0%,同一个截断给出 PPV=0.727;换到患病率只有 5% 的普通人群,同样的灵敏度特异度会让 PPV 大幅下跌,而 LR+=2.56、LR−=0.38 与患病率无关、保持不变。要把结论推广到别的人群,报似然比比报预测值可靠。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:ROC/AUC 与最佳截断(主结果表)
- 输出结果三:ROC 曲线可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
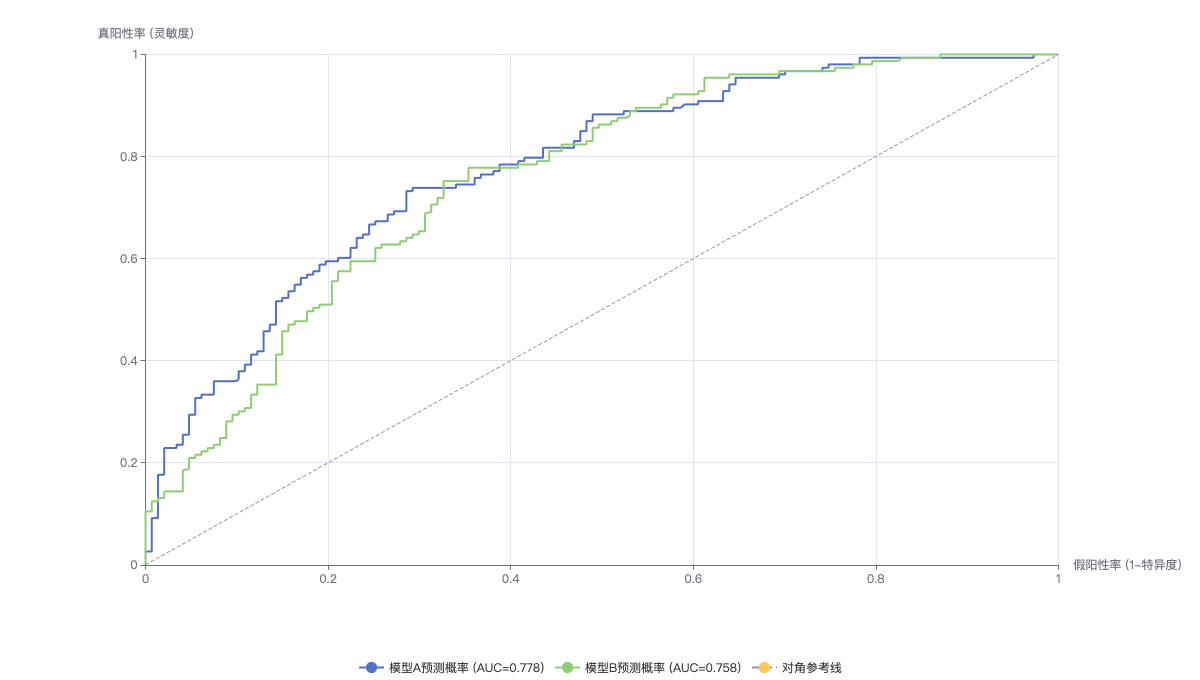
曲线越靠近左上角判别能力越强;对角线代表随机判别(AUC=0.5)。可用右上角切换器在「ROC 曲线 / AUC 对比柱状图 / 数据表」之间切换。